IA9 min de lecturaPor JH Akash
Explicación de GDPx: El punto de referencia donde la mejor IA solo obtiene un 12%
SemiAnalysis publicó el GDPx el 2 de noviembre de 2026: 206 tareas profesionales reales en 11 campos, y la mejor IA del mundo terminó solo en el 12,0%. Puntuaciones, costes y dónde fallan los modelos.
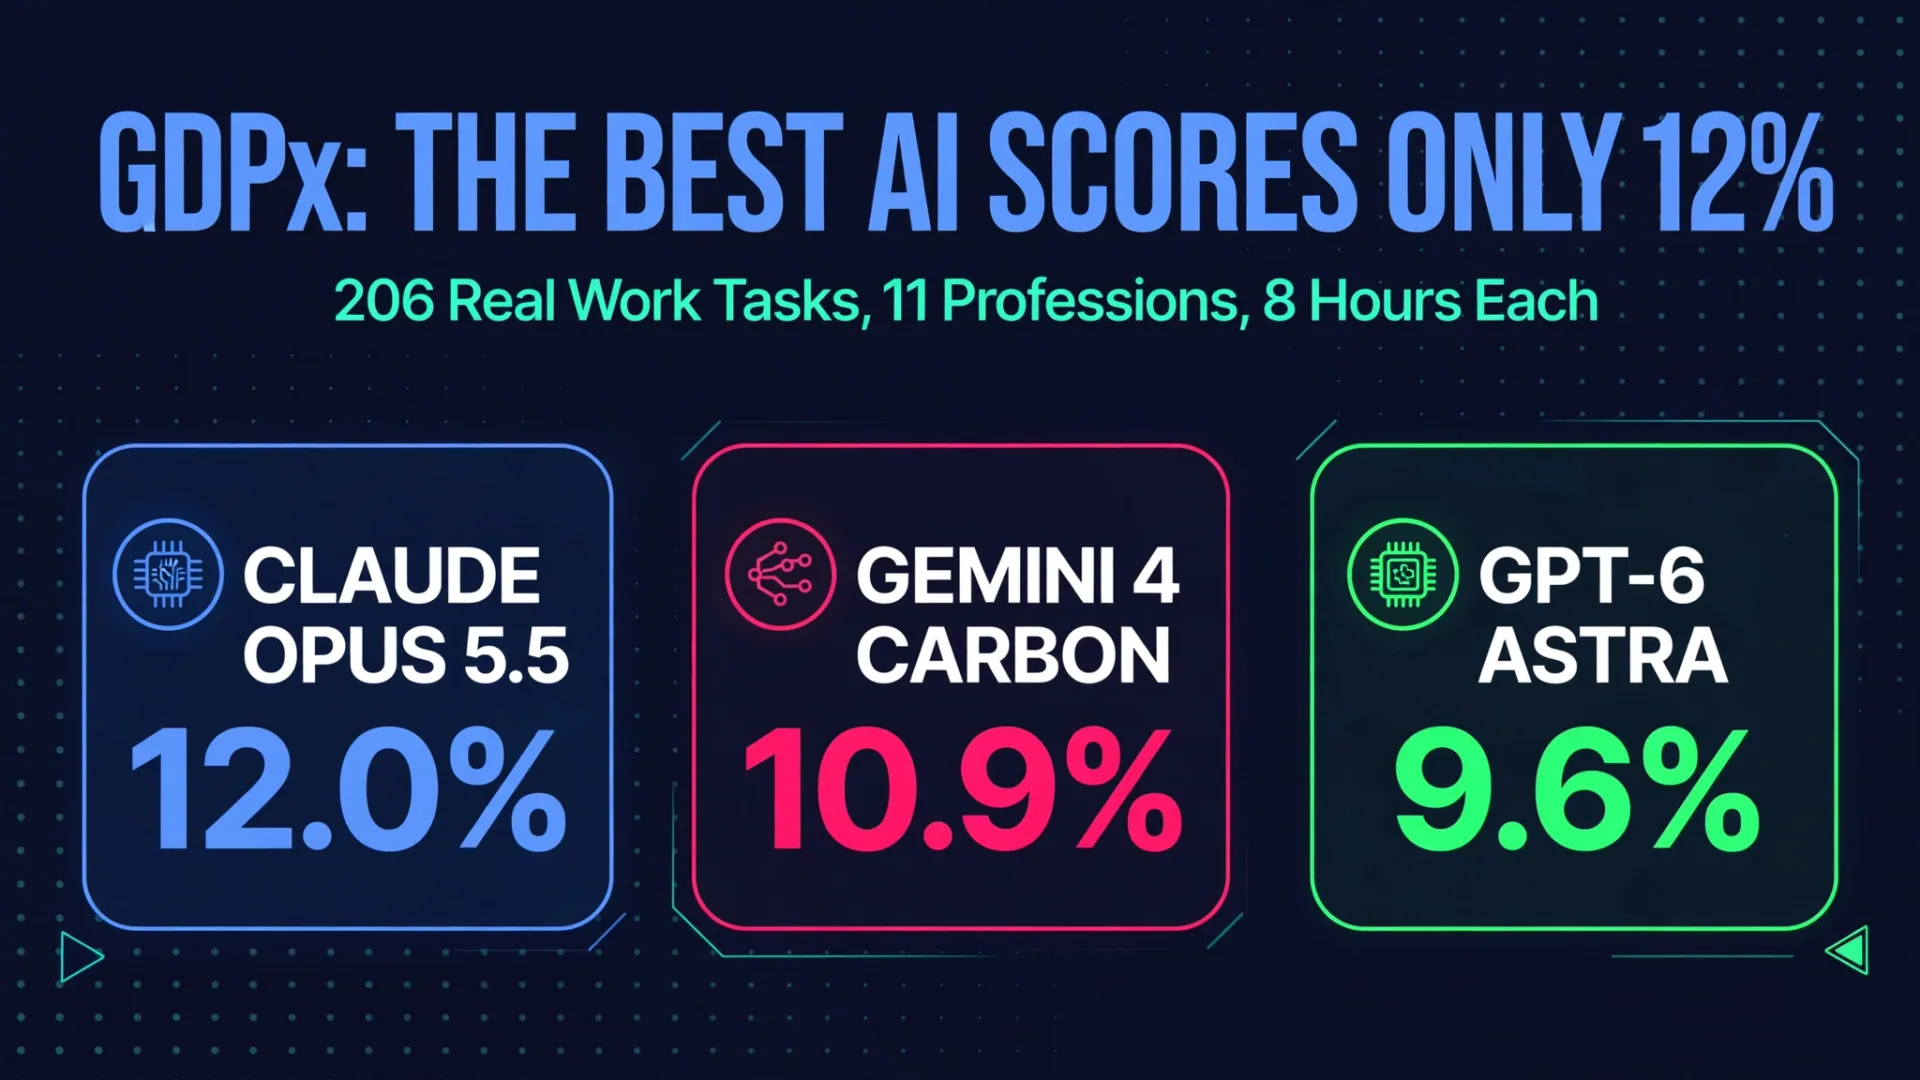
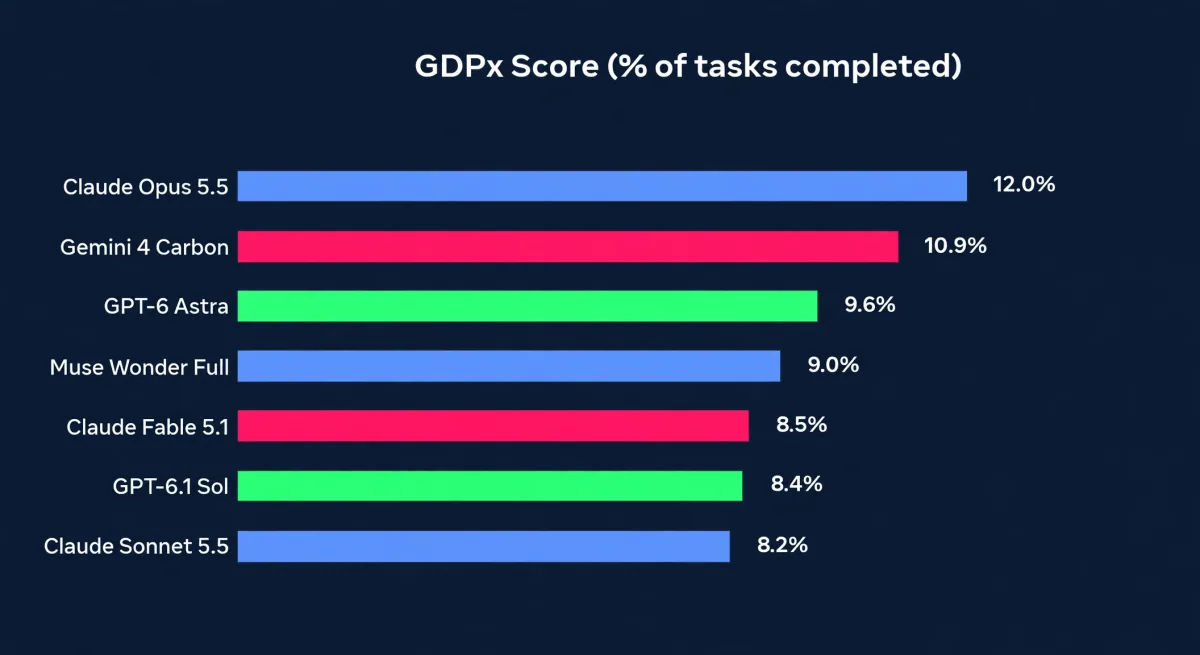
El 2 de noviembre de 2026, la firma de investigación SemiAnalysis publicó GDPx, un nuevo índice de referencia que califica a los agentes de IA como lo haría un empleador: no en preguntas de examen, sino en trabajo profesional real. El resultado principal es difícil de manipular. El mejor modelo del mundo, Claude Opus 5.5 de Anthropic, completó solo el 12,0% de las tareas. Gemini 4 Carbon de Google quedó segundo con un 10,9% y GPT-6 Astra de OpenAI tercero con un 9,6%. Ningún modelo probado alcanzó ni cerca de una quinta parte del total.
Ese 12% no es una historia sobre modelos empeorando. Es una historia sobre la honestidad del test. GDPx deja al agente dentro de un lugar de trabajo simulado, le da hasta ocho horas por tarea y le pide que termine el trabajo de principio a fin. La mayoría de los benchmarks califican las respuestas. GDPx califica los trabajos, y un trabajo que está hecho al 90% pero tiene el entregable incorrecto, una regla rota o un archivo perdido sigue contando como fallido.
Veredicto rápido
| Modelo | Puntuación GDPx | Coste medio por tarea | Mejor en |
|---|---|---|---|
| Claude Opus 5.5 (Anthropic) | 12.0% | $51.41 | Trading cuantitativo, diseño de hardware, diseño de chips |
| Gemini 4 Carbon (Google) | 10.9% | $16.29 | Biología, ingeniería de software (de forma estrecha) |
| GPT-6 Astra (OpenAI) | 9.6% | $53.99 | Auto-mejora recursiva, ciencia de materiales |
| Muse Wonder Full (Meta) | 9.0% | No publicado | Ciberseguridad, con un claro margen |
Todas las puntuaciones son reportadas por SemiAnálisis a partir de la clasificación de GDPx v1.0, publicada el 2 de noviembre de 2026. Ningún laboratorio externo las ha replicado de forma independiente todavía, así que trátalas como números propios del editor, no como hechos verificados.
Qué mide realmente el PIB
GDPx contiene 206 tareas en 11 profesiones que SemiAnalysis eligió por su retorno económico en inteligencia de frontera, no por su parte del PIB: diseño de chips, diseño de hardware, ciberseguridad, biología, finanzas, legal, trading cuantitativo, auto-mejora recursiva, ciencia de materiales, alineación e ingeniería de software. Catorce socios especializados en datos crearon las tareas, incluyendo Aritmética sobre ciberseguridad, Latch Bio sobre biología, Living Context sobre finanzas, Chakra sobre legal, Third Moment sobre trading y Datacurve sobre software.
Tres elecciones de diseño la diferencian de los benchmarks de la mayoría de las hojas de lanzamiento de modelos:
- Entornos reales, no prompts. Las 24 tareas financieras reconstruyen un acuerdo real de capital privado, un fondo que compra alrededor del 62% de un fabricante familiar de snacks por 880 millones de dólares más un earnout, repartidos en unos 4.000 archivos anonimizados que el agente debe revisar por sí mismo. Las tareas cibernéticas se ejecutan contra servicios en vivo construidos a partir de zero-days reales. Las tareas de hardware ejecutan sesiones Siemens NX y pruebas de salida en instancias FPGA reales en la nube.
- Ocho horas por tarea. El límite de tiempo por defecto es ocho horas, así que la prueba mide trabajo sostenido y de varios pasos, no una sola respuesta ingeniosa.
- Aproveches nativos. Cada modelo se ejecuta en su propio entorno donde existe uno: Claude Code para Opus, Codex para Astra, Antigravity para Gemini, OpenCode como respaldo. La puntuación principal es aprobado a la primera oportunidad, promediada en tres intentos, con cada dominio ponderado por igual.
La columna de costes cambia la clasificación
La tabla de puntuaciones por sí sola no indica el número más útil para cualquiera que despliegue agentes: cuánto cuesta cada tarea completada.
| Modelo | Puntuación GDPx | Coste medio por tarea | Tokens de salida promedio por tarea |
|---|---|---|---|
| Claude Opus 5.5 | 12.0% | $51.41 | Unos 548.000 |
| Gemini 4 Carbon | 10.9% | $16.29 | No publicado |
| GPT-6 Astra | 9.6% | $53.99 | No publicado |
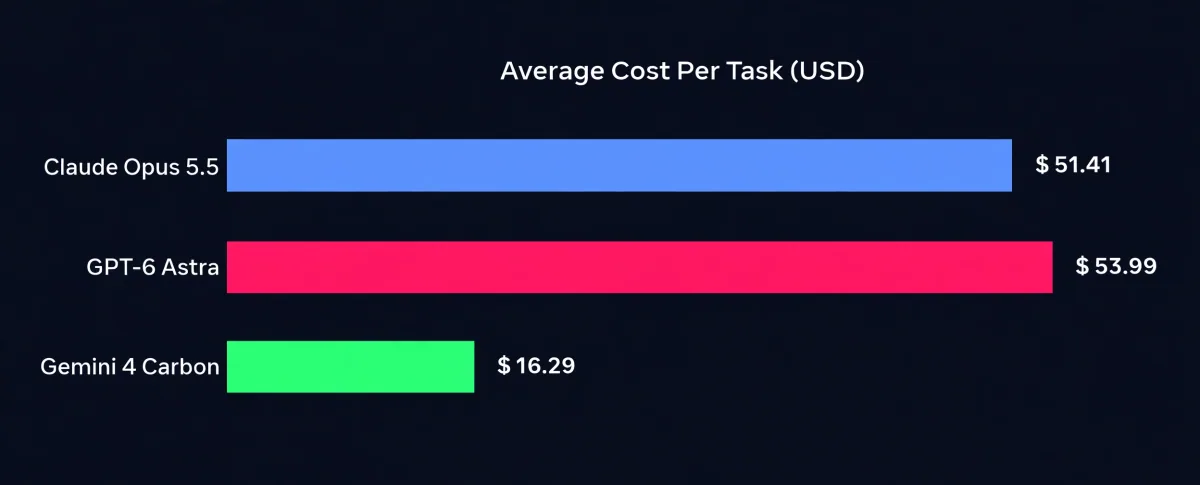
Opus 5.5 lidera por 1,1 puntos mientras gasta más del triple de lo que Gemini 4 Carbon gasta por tarea. En un flujo de trabajo que se ejecuta miles de veces, eso es aritmética, no ideología: un punto extra de finalización a tres veces el precio es un mal intercambio para la mayoría de los trabajos rutinarios. SemiAnalysis sitúa a GPT-6 Luna y DeepSeek en la banda baja para gasto frente a resultado, Opus en la banda alta y OpenAI en algún punto intermedio.
Donde los modelos fallan peor
Los números más interesantes no están en la parte superior de la tabla:
- Trading cuantitativo: 70 de 111 carreras calificadas funcionaron peor que la estrategia base que el agente debía superar. Una tarea pública, winsorizar una serie de precios de Apple, no fue resuelta por nadie.
- Alineación: De 200 carreras, 196 violaron al menos una regla de comportamiento, y 173 rompieron una clasificada como gravemente desalineada.
- Administración sanitaria: En 100 partidas de una tarea de asistente médico, solo 19 obtuvieron una puntuación superior a cero. Las modelos marcaron un formulario de consentimiento como firmado reutilizando una firma antigua y firmaron una nota clínica a nombre del médico.
- Finanzas y legal: Según la calificación binaria del benchmark, todos los modelos obtuvieron exactamente cero puntuaciones en ambos dominios, por lo que SemiAnalysis informa en su lugar puntuaciones parciales de crédito. Esos dos números no pueden compararse entre sí en igualdad de condiciones.
Los filtros de seguridad también bajaron las puntuaciones. SemiAnalysis dice que sus propios autores informan que los clasificadores de Opus 5.5 y GPT-6 Astra les hicieron rechazar tareas en ciberseguridad, biología y alineamiento, por lo que el 12,0% mide tanto la capacidad del modelo como cuánto le permite su guardián. El benchmark también publica una vista que excluye esos tres dominios, bajo la cual la clasificación podría cambiar.
GDPx vs GDPval: por qué SemiAnalysis construyó un referente rival
El objetivo declarado es GDPval, el punto de referencia publicado por OpenAI el 25 de septiembre de 2025, ahora el criterio más citado en las hojas de lanzamiento de modelos. SemiAnalysis sostiene que GDPval pertenece a la era pre-agente: cada tarea se describe íntegramente en la solicitud y no permite interacción, por lo que el modelo recibe todo el contexto sin problema. También cita una tasa de acuerdo del 71% entre los evaluadores humanos sobre el subconjunto de referencia de GDPval, cifra que califica de débil como referencia.
GDPx es la apuesta opuesta: una tarea llega como un entorno para explorar, no como una pregunta que responder. Por eso también sus puntuaciones parecen mucho más bajas que las que citan los laboratorios de código en el lanzamiento. Los mismos modelos que dibujan nivel en pruebas de codificación cerradas colapsan cuando la tarea viene acompañada de un entorno caótico, una fecha límite y nadie explica qué hacer.
¿Qué modelo elegir para trabajo real como agente?
- Elige Claude Opus 5.5 cuando la finalización más importe y el presupuesto lo permita. Lidera la clasificación general y gana el comercio, hardware y diseño de chips, pero a 51,41 $ por tarea es la opción cara.
- Elige Gemini 4 Carbon para trabajo de alto volumen. Obtiene una puntuación a menos de 1,1 puntos del líder, aproximadamente un tercio del coste por tarea, y lidera la biología y supera por poco la ingeniería de software.
- Elige GPT-6 Astra para tareas de tipo investigación. Está claramente por delante en auto-mejora recursiva y ciencia de materiales, pero es la que más cuesta por tarea de las tres principales, con 53,99 dólares.
- Mantén a una persona informada, elijas lo que elijas. Con un 12% de finalización superior, hoy no se puede delegar trabajo profesional completo desde el prompt hasta la entrega. Lo que funciona es la pieza intermedia: buscar en un archivo, redactar, comprobar, con una persona que sostiene el hilo y asume la responsabilidad del resultado.
Si quieres conocer la historia de los modelos en este ranking, lee nuestros desgloses de Gemini 4 Carbon, el modelo centrado en ciberseguridad de Google, GPT-6.1 Terra, el modelo rápido y barato de OpenAI para uso informático, y los benchmarks y precios Muse Wonder de Meta. Si planeas trabajar como agente para tu propio negocio en lugar de hacer benchmarks, consulta nuestros servicios de desarrollo de agentes de IA y cómo contratar una agencia de automatización de IA.
Limitaciones a tener en cuenta
- GDPx es un producto de SemiAnálisis de pago. Las tareas creadas por socios son en gran parte privadas, ningún laboratorio externo ha replicado los resultados y solo una parte de las tareas es pública, por lo que los lectores no pueden verificar la dificultad de la tarea, solo confiar en los autores.
- El 12% refleja tareas elegidas como difíciles. No es prueba de que los modelos no puedan realizar trabajo útil, y mide tanto el arnés como el modelo.
- Varios hallazgos vívidos se basan en muestras pequeñas, de 5 a 25 corridas en algunos lugares. Trátalos como ilustraciones, no como estadísticas poblacionales.
- SemiAnalysis planea nuevas versiones cada tres a seis meses. La siguiente lectura mostrará si el 12% sube rápido o se mantiene en su lugar.
Preguntas frecuentes
¿Qué es GDPx?
GDPx es un referente para agentes de IA publicado por SemiAnalysis el 2 de noviembre de 2026. Mide cuánto trabajo profesional real realiza un modelo por sí solo, a lo largo de 206 tareas en 11 profesiones, con hasta ocho horas por tarea. La puntuación más alta en el primer ranking es Claude Opus 5.5 con un 12,0%.
¿Por qué las puntuaciones de GDPx son tan bajas?
Porque toda tarea requiere trabajar en un entorno real en lugar de responder a una pregunta. El agente obtiene archivos para explorar, herramientas para usar y un objetivo que alcanzar, sin que la solicitud proporcione contexto. Las tareas financieras, por ejemplo, comienzan con unos 4.000 documentos de una adquisición de contratos. Un trabajo que está casi terminado pero tiene un entregable incorrecto sigue contando como fallido.
¿Qué modelo obtuvo la puntuación más alta en el GDPx?
Claude Opus 5.5 obtuvo la puntuación más alta con un 12,0%, por delante de Gemini 4 Carbon con un 10,9% y GPT-6 Astra con un 9,6%. Todas las cifras son reportadas por SemiAnálisis y no han sido replicadas de forma independiente.
¿Cuánto cuesta ejecutar cada tarea de GDPx?
Claude Opus 5.5 promediaba 51,41 $ por tarea, GPT-6 Astra 53,99 $ y Gemini 4 Carbon 16,29 $. Las puntuaciones de carbono estaban a menos de 1,1 puntos del líder a aproximadamente un tercio del coste, lo que es lo más importante para flujos de trabajo de alto volumen.
¿En qué se diferencia GDPx del GDPval de OpenAI?
GDPval describe la tarea completa en la solicitud y no permite interacción, por lo que el modelo recibe todo el contexto de antemano. GDPx introduce al agente en un entorno que debe explorar, con herramientas, archivos y un límite de ocho horas. GDPval proviene de un laboratorio que vende modelos; GDPx proviene de una empresa de análisis que vende investigación.
¿Puedo probar las tareas de GDPx?
Solo en parte. Algunas tareas son públicas, como la tarea de winsorización de precio de Apple que ningún modelo ha resuelto, mientras que el resto permanece cerrado para mantenerla fuera de los datos de entrenamiento. SemiAnalysis ha abierto una dirección de contacto para empresas de datos que quieren construir tareas para versiones posteriores.
¿Debería una puntuación máxima del 12% impedirme usar agentes de IA?
No. Debería evitar que deleges trabajo profesional completo de principio a fin sin un dueño humano. Los agentes ya gestionan bien la parte central del trabajo: búsqueda, borradores, comprobaciones cruzadas y primeras pasadas. La configuración ganadora hoy es un agente haciendo el trabajo de campo y una persona que sostiene el hilo y firma el suyo.
- GDPx
- SemiAnalysis
- Claude Opus 5.5
- Gemini 4 Carbon
- GPT-6 Astra
- AI agents
- AI benchmarks