IA12 min de lecturaPor JH Akash
Explicación del LFM3 de IA líquida: 6 modelos 2B de peso abierto
Liquid AI lanzó LFM3 el 27 de octubre de 2026: seis modelos de clase 2B de peso abierto a partir de una sola columna vertebral de 1.7 mil millones, contexto de 256K, 1 GB a 4 bits, API de 0,08 dólares por cada 1 millón de tokens.
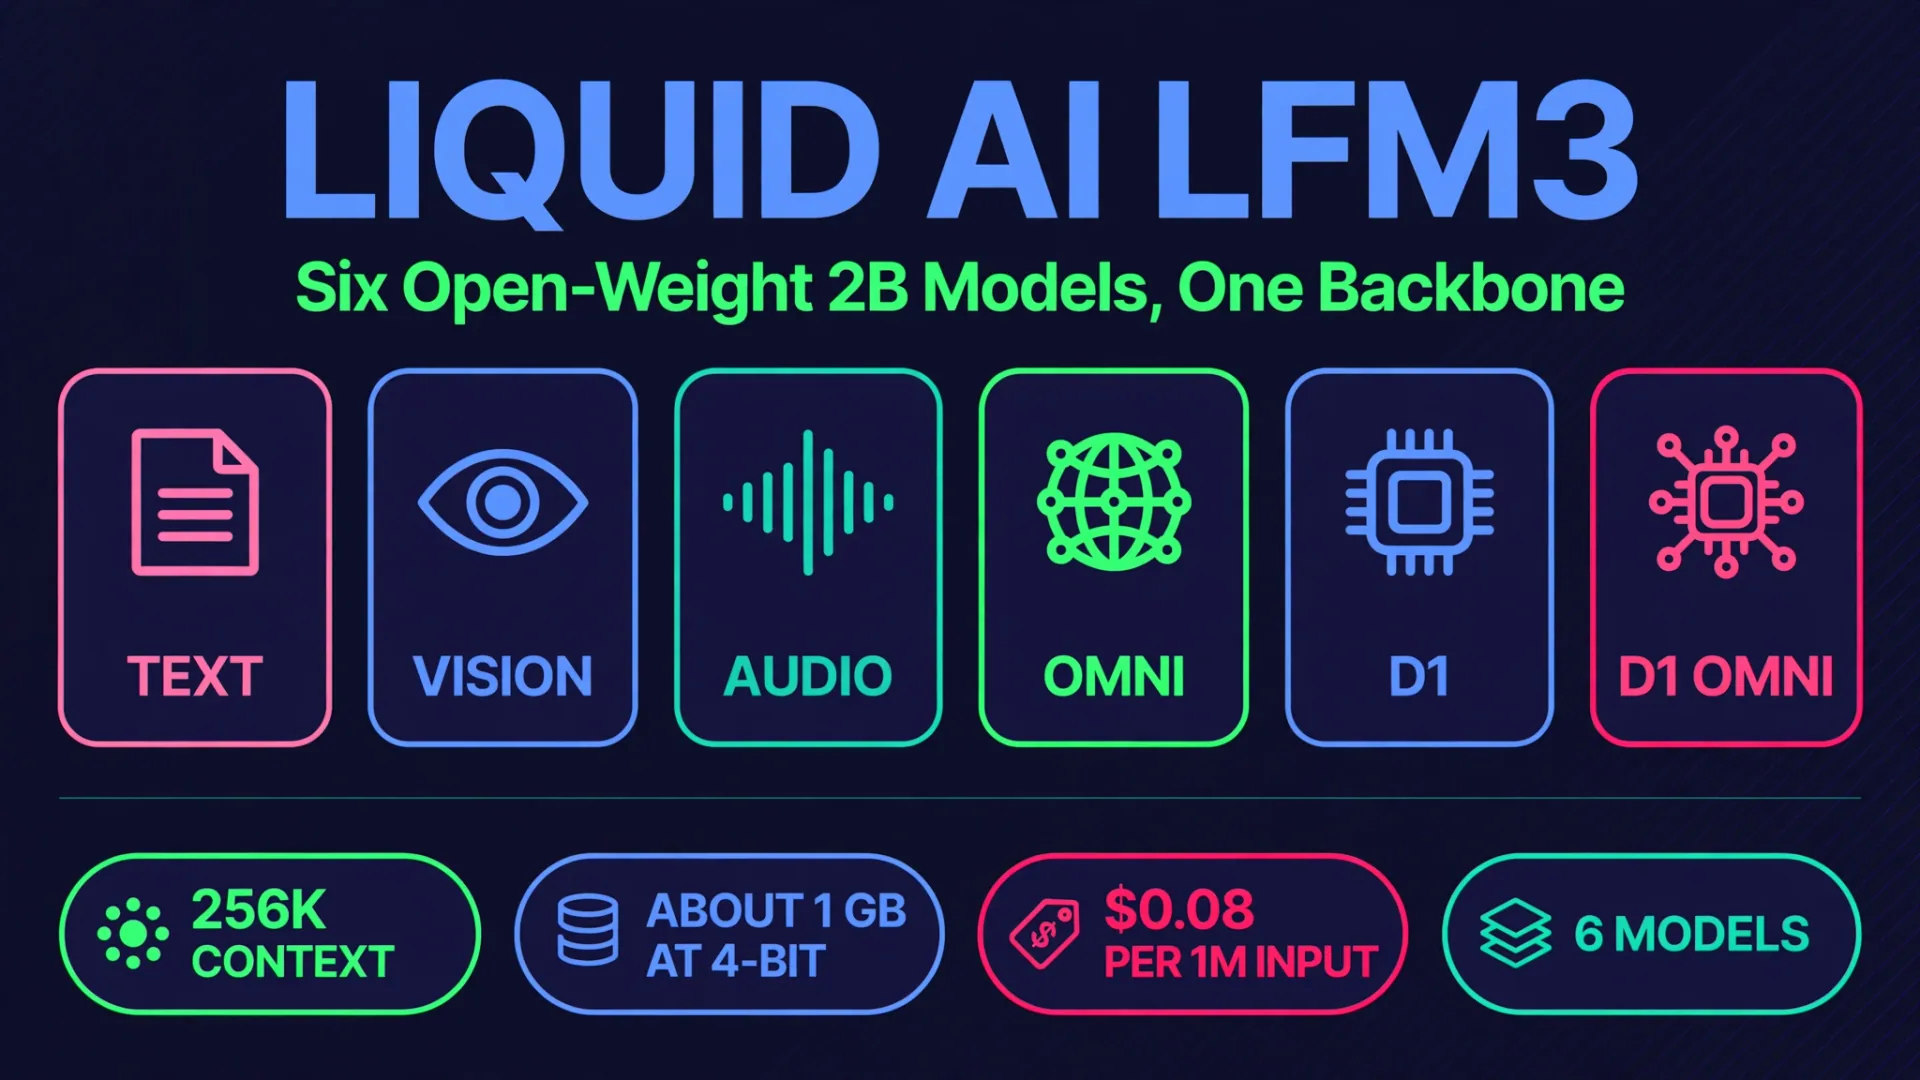
Liquid AI lanzó LFM3 el 27 de octubre de 2026, y es un tipo diferente de lanzamiento de modelo. En lugar de un gran buque insignia, LFM3 es una familia de seis modelos de peso abierto en la clase de parámetros 2B, todos ramificados desde la misma columna vertebral de 1,7B. Texto, visión, audio, omni y dos modelos de decisión comparten una arquitectura, por lo que un equipo puede elegir la modalidad que necesita sin necesidad de aprender una nueva pila para cada uno. La presentación no es potencia bruta. Es la huella: un modelo pequeño capaz que funciona en teléfonos, portátiles, una Raspberry Pi 5 y hardware edge, y que puede ajustarse finamente en una sola GPU.
El momento importa. Los modelos frontera siguen creciendo y siendo más caros de ejecutar, mientras que la mayoría de las tareas empresariales reales, leer un documento, revisar una foto, responder a comandos de voz, puntuar una lista de opciones, no necesitan un modelo gigante. Necesitan un modelo pequeño, rápido y privado que funcione donde ya están los datos. LFM3 es la apuesta de Liquid AI de que aquí es donde ocurre la próxima oleada de despliegue de IA: en dispositivos, en instalaciones y dentro de sistemas controlados por la empresa.
El veredicto rápido
| Pregunta | Respuesta |
|---|---|
| ¿Qué pasa? | LFM3, una familia de seis modelos de la clase 2B de peso abierto de Liquid AI |
| Botado | 27 de octubre de 2026 |
| Columna vertebral compartida | LFM3-1.7B-Base, parámetros 1.73B |
| Contexto | 256K tokens en la tarjeta modelo (la API alojada lista 128K, ver la nota de precios más abajo) |
| Datos de entrenamiento | Fichas 22T de pre-entrenamiento |
| Huella | Unos 1 GB de memoria con precisión de 4 bits para el modelo de texto |
| Licencia | LFM Open License v1.0, peso abierto |
| Disponible en | Hugging Face, Liquid AI Playground, Liquid AI API, OpenRouter, Qualcomm AI Hub, Vercel |
| Mejor para | Agentes en el dispositivo, inspección visual, voz y decisiones calibradas |
| No para | Codificación agentica pesada o razonamiento complejo de varios pasos (la IA líquida lo dice por sí misma) |
Los seis modelos, una columna vertebral
Cada modelo LFM3 se ramifica desde LFM3-1.7B-Base. Esa columna vertebral compartida es lo que hace inusual a la familia: una arquitectura, seis especializaciones.
| Modelo | Entradas | Salidas | Para qué sirve |
|---|---|---|---|
| LFM3-1.7B | Texto | Texto | Texto general, agentes, uso de herramientas |
| LFM3-VL-2B | Texto, imágenes, vídeo | Texto | Visión y comprensión de vídeo, inspección |
| LFM3-Audio-2B | Texto o audio | Texto o voz | Comandos de voz, transcripción, voz |
| LFM3-Omni-2B | Texto, imágenes, vídeo, audio | Texto y voz | Asistentes multimodales completos |
| d1-2B | Preguntas (lista) | Respuestas calibradas | Decisiones con probabilidades, no texto generado |
| d1-omni-2B | Preguntas multimodales | Respuestas calibradas | Decisiones basadas en imágenes, audio y documentos |
Los modelos de decisión merecen una mención especial porque funcionan de forma diferente a un chatbot normal. En lugar de generar un párrafo, d1 responde a toda una lista de preguntas en una sola pasada hacia adelante, cada una con una probabilidad calibrada. También puede devolver respuestas tecleandas: señalar un objeto, leer un valor de un documento, estimar un número con un rango o elegir todas las opciones que se apliquen. Para flujos de trabajo empresariales como triaje, puntuación y enrutamiento, ese resultado estructurado suele ser más útil que una prosa fluida.
Dentro de la columna vertebral: una arquitectura tri-híbrida
LFM3-1.7B-Base tiene 24 capas: 13 convoluciones cortas con puerta, cinco capas de atención con ventana deslizante y una ventana de 256 tokens, y seis capas globales de atención. Las convoluciones usan un tamaño de kernel de 7, frente a 3 en LFM2. Tres cambios definen el diseño: atención con puerta de cabeza a cabeza, que puede suprimir valores atípicos de activación que perjudican la cuantización; ROPE parcial, donde las capas de atención global solo rotan la mitad de mayor frecuencia de cada cabezal; y una norma sándwich que normaliza la entrada y salida de cada bloque.
Liquid AI afirma que esta arquitectura surgió de una búsqueda hardware-in-the-loop en 14 combinaciones de dispositivos y backend, incluyendo el Samsung Galaxy S26 Ultra, OnePlus 15, Raspberry Pi 5, Apple M4 Max, AMD Ryzen AI, CPUs en la nube, GPUs y la NPU Qualcomm Hexagon. Los resultados prácticos, todos informados por el fabricante: LFM3-1,7B supera a su predecesor LFM2,5-2,6 mil millones utilizando un 35 % menos de parámetros, funciona aproximadamente un 25 % más rápido con tokens de 8K en contexto y decodifica entre 1,8 y 2,8 veces más rápido que el siguiente modelo en las tres configuraciones en el dispositivo que probó Liquid AI. En un solo NVIDIA B300, Liquid AI afirma que LFM3-1,7B puede producir 3,6 mil millones de tokens al día con 1.024 solicitudes concurrentes.
El preentrenamiento se ejecutó con tokens de 22T, con los últimos 3,5T formando una etapa intermedia de entrenamiento sobre datos curados con una mayor cuota de trazas agenticas y llamadas a herramientas, lo que también amplió la ventana de contexto a 256K tokens. El postentrenamiento se realizó en cuatro etapas: ajuste fino supervisado en tokens de 1,75T, aprendizaje por refuerzo mixto, destilación multidominio en políticas por seis profesores especialistas en aprendizaje por refuerzo, y aprendizaje por refuerzo agentico dentro de los arneses reales de agentes.
Referencias: fuerte en agentes y herramientas, honesto con los límites
Todos los números de referencia a continuación son reportados por el proveedor de Liquid AI, a partir de su postproducción y tarjeta modelo. Trátalos como mediciones propias de Liquid AI, no como resultados independientes.
| Índice de referencia | LFM3-1.7B | Lo que prueba |
|---|---|---|
| LiveClaw | 45.60 | Tareas agenticas |
| WebArena-Verified | 38.42 | Tareas de agentes web |
| BFCL V4 | 71.39 | Llamada de herramientas |
| Caja de Arena de Herramientas | 80.36 | Uso de herramientas |
| IFEval | 96.66 | Instrucción posterior |
| SWE-bench verificado | 43.40 | Codificación agente |
| GPQA Diamond | 63.37 | Conocimiento experto |
| El último examen de la humanidad (sin herramientas) | 7.17 | Conocimiento duro |
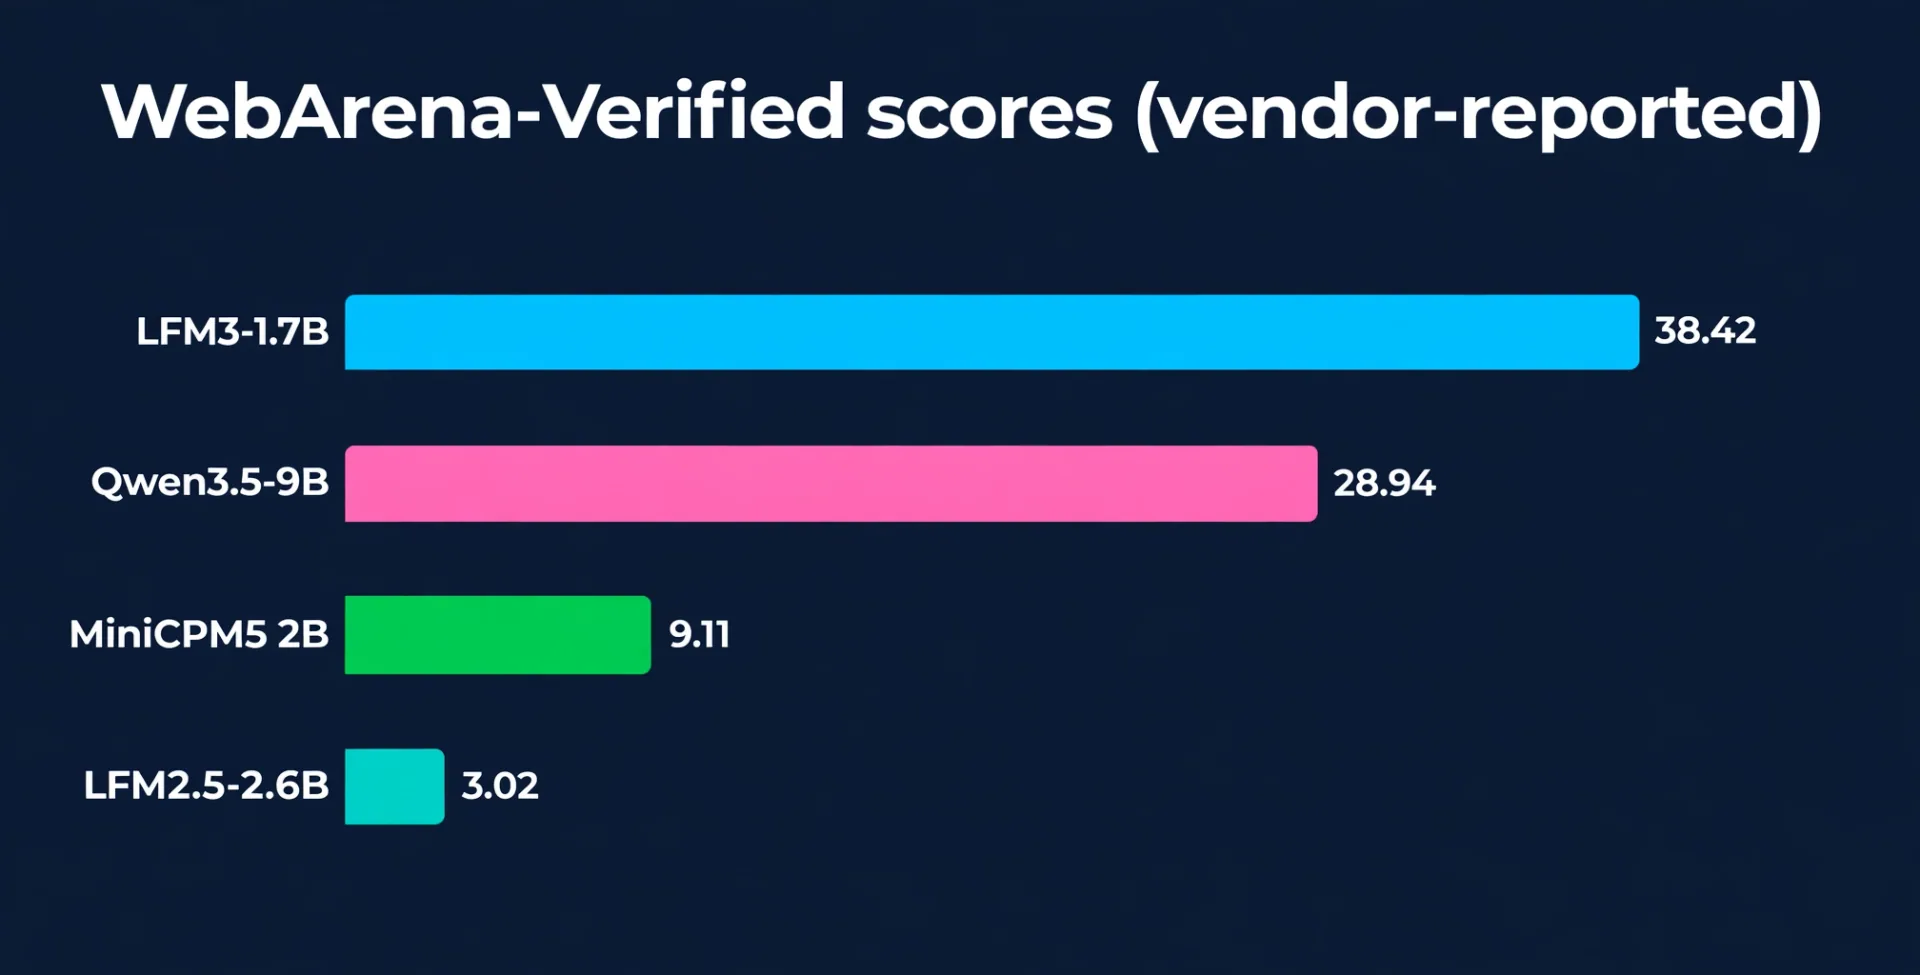
El salto en WebArena-Verified es el titular: 38,42 para LFM3-1,7B frente a 3,02 para su predecesor LFM2,5-2,6B. Eso es un cambio real de tipo para un modelo 1,7B, y encaja con el énfasis en el entrenamiento agentivo. Pero la misma tabla muestra los límites: un 7,17 en Humanity's Last Examination sin herramientas es débil, y la propia tarjeta modelo de Liquid AI indica que el modelo no es recomendado para codificación agentica ni para razonamientos complejos de varios pasos debido a su pequeño tamaño. Los modelos pequeños son un intercambio, no un almuerzo gratis.
Las demás modalidades tienen sus propios números. LFM3-VL-2B es el primer modelo de visión LFM en aceptar entrada de vídeo, y Liquid AI informa que eleva la media en 62 benchmarks de visión de 57,6 a 71,4 frente a LFM2,5-VL-3B, mientras que utiliza parámetros de 1,9B frente a 3,1B. LFM3-Audio-2B soporta 18 idiomas, con una calidad de voz de 3,83 en UTMOSv2 frente a 3,22 de su predecesor, tiempo para el primer token tan bajo como 50 ms, y generación de voz a aproximadamente 87 veces en tiempo real en un solo hilo de CPU en un Apple M4 Max. LFM3-Omni-2B, con parámetros de 2,2B, se informa que supera a modelos de hasta 10,7B parámetros en los benchmarks audiovisuales Daily-Omni, WorldSense y AV-SpeakerBench. El modelo de decisión d1-2B reemplaza a d1-3B con un tercio menos de parámetros y obtiene una puntuación de 75,5 frente a 64,0 en ImajevBench.
Precios: algunos de los tokens alojados más baratos que existen
La valoración de las APIs alojadas proviene del catálogo de modelos de Liquid AI, según informa VentureBeat. Los precios están en USD por millón de tokens.
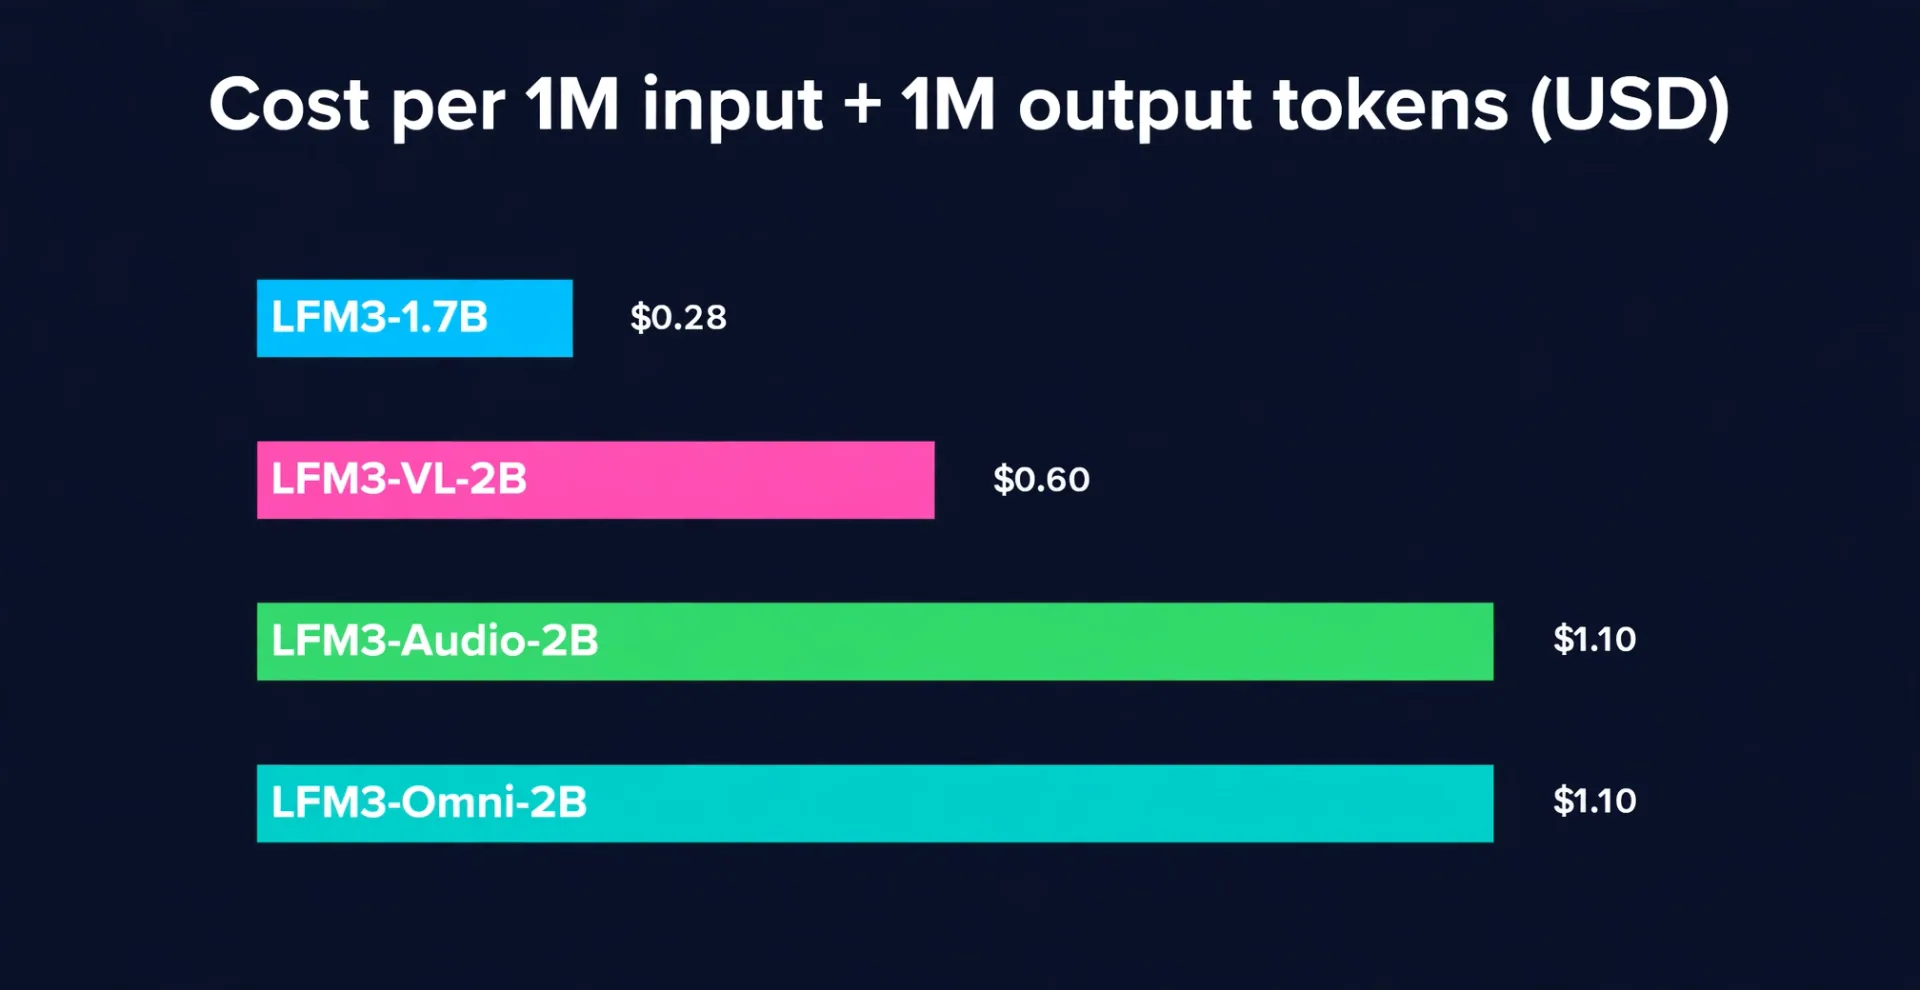
| Modelo | Entrada | Entrada en caché | Producción | 1M de entrada + 1M de salida |
|---|---|---|---|---|
| LFM3-1.7B | $0.08 | $0.02 | $0.20 | $0.28 |
| LFM3-VL-2B | $0.10 | $0.02 | $0.50 | $0.60 |
| LFM3-Audio-2B | $0.10 | $0.02 | $1.00 | $1.10 |
| LFM3-Omni-2B | $0.10 | $0.02 | $1.00 | $1.10 |
Los tokens de audio cuestan un extra en los modelos Audio y Omni: 2,00 $ por millón de tokens de entrada de audio y 10,00 $ por millón de tokens de salida de audio. Dos cosas que debes comprobar antes de presupuestar: la API alojada indica un límite de contexto de 128.000 tokens, mientras que la tarjeta modelo anuncia 256K, así que confirma qué límite se aplica a tu ruta de despliegue. Y para compradores sensibles a la privacidad, Liquid AI indica cero retención de datos en sus modelos alojados: el material enviado se usa para satisfacer solicitudes y no se retiene, registra ni se usa para entrenamiento.
Para comparar, el modelo de texto a 0,28 dólares por millón de tokens de entrada más un millón de tokens de salida está muy por debajo del nivel insignia. Ese es el objetivo de esta clase: cuando ejecutas millones de tareas pequeñas, el precio por token decide si el producto es viable en absoluto. Si comparas los precios de modelos pequeños alojados de forma más amplia, nuestro desglose reciente de GPT-6.1 Terra muestra cómo OpenAI valora su propio modelo rápido de gama media, y nuestra publicación sobre Kimi K3.1 Pro cubre otro lanzamiento a peso abierto del mismo mes.
¿Qué modelo deberías elegir?
Elige LFM3-1.7B para agentes de texto, trabajo documental y flujos de trabajo de llamada de herramientas donde el coste y la velocidad importan más que el razonamiento de frontera. Es la opción predeterminada y la que tiene más cobertura de benchmarks.
Elige LFM3-VL-2B para cualquier cosa que revise imágenes o vídeos: inspección de calidad, lectura de documentos, evaluación de daños, comprobaciones de estantería. El propio ejemplo de Liquid AI es revelador: afinar VL-2B en unas 3.000 fotos públicas de palas de aerogeneradores durante unas horas en un A100 elevó la precisión de clasificación de defectos al 67 por ciento. Ese es el manual de modelos pequeños: empieza desde un modelo general decente, ajusta tus propias imágenes, despliega en tu propio hardware.
Elige LFM3-Audio-2B para interfaces de voz, gestión de llamadas y transcripción cuando la baja latencia importe. Un tiempo de 50 ms para la primera generación de token y voz en el dispositivo lo convierte en candidato para quioscos, coches y fábricas sin necesidad de ir ida y vuelta a la nube.
Elige LFM3-Omni-2B cuando un solo asistente debe manejar texto, imagen, vídeo y audio juntos, por ejemplo un asistente de servicio de campo que ve la máquina, escucha al técnico y responde.
Elige d1-2B o d1-omni-2B cuando necesites decisiones, no prosa: colas de triaje, puntuación de leads, enrutamiento de contenido o cualquier flujo de trabajo donde una probabilidad calibrada y una respuesta estructurada superen a un párrafo. Esta es la idea más empresarial de la familia y la menos parecida a un chatbot.
Cada modelo de LFM3 puede ajustarse en una sola GPU, con portátiles publicados para ajuste supervisado, DPO, GRPO y preentrenamiento continuo. Los runtimes incluyen llama.cpp, MLX, vLLM, SGLang y Ollama, con variantes de checkpoint en BF16, FP8, NVFP4, GGUF, MLX y ONNX. Los socios de lanzamiento del día 0 incluyen Ambarella, AMD, Arm, Intel a través de OpenVINO, NVIDIA, OpenRouter, Qualcomm y Vercel, y Liquid AI dice que Mercedes-Benz y Shopify colaboran en pruebas y evaluaciones previas.
Liquid AI también adaptó VL-2B en tres modelos robóticos para orquestación, navegación y manipulación, reportando un éxito medio del 96,2 % en las cuatro suites LIBERO y del 45,7 % en tareas de mesa RoboCasa-GR1, con fragmentos de acción generados en menos de 50 ms en un Jetson AGX Orin. La robótica aún es temprana para un modelo 2B, pero la parte interesante es el número de latencia: los modelos pequeños pueden cerrar el ciclo lo suficientemente rápido para un control real.
Los límites honestos
Ningún modelo 1.7B sustituye a un modelo frontera, y LFM3 no pretende hacerlo. Las preguntas con mucho conocimiento, las matemáticas difíciles y el razonamiento largo de varios pasos son puntos débiles, y la propia guía de Liquid AI aleja a los usuarios de la codificación agentica con esta clase de tamaño. Si tu tarea requiere investigación profunda o planificación compleja, aún quieres un modelo más grande, posiblemente con LFM3 manejando la capa barata, rápida y de alto volumen que lo rodea. Esa configuración en capas, modelos pequeños en el borde y modelos frontera para los casos duros, es también cómo se construyen la mayoría de los proyectos serios de desarrollo de agentes de IA . Si planeas ese tipo de sistema, nuestro equipo construye agentes de esta manera; mira cómo contratar una agencia de automatización de IA para saber qué comprobar antes de comprometerte.
Otra cosa a verificar es la licencia. LFM3 se distribuye bajo la Licencia Abierta LFM v1.0 como open-weight, pero las licencias "abiertas" difieren en sus términos comerciales, así que lee el texto real de la licencia para tu nivel de ingresos y caso de uso antes de lanzar un producto comercial en él.
Preguntas frecuentes
¿Qué es Liquid AI LFM3?
LFM3 es una familia de seis modelos de IA de peso abierto lanzados por Liquid AI el 27 de octubre de 2026. Los seis se ramifican de la misma columna vertebral LFM3-1.7B-Base y cubren texto, visión, audio, omni y toma de decisiones, en la clase de parámetros 2B.
¿Qué tamaño tiene realmente LFM3-1.7B?
El modelo de texto tiene 1,73 mil bitos, una ventana de contexto de 256.000 tokens en su tarjeta modelo y un vocabulario de 128.000 tokens, con soporte para 16 idiomas. Con precisión de 4 bits requiere aproximadamente 1 GB de memoria, por lo que puede funcionar en teléfonos y dispositivos pequeños en el edge.
¿Puede funcionar LFM3 en un teléfono?
Sí, ese es el objetivo de diseño. Liquid AI lo probó en el Samsung Galaxy S26 Ultra, OnePlus 15, Raspberry Pi 5, Apple M4 Max, AMD Ryzen AI y el NPU Qualcomm Hexagon, y reporta que decodifica entre 1,8 y 2,8 veces más rápido que el siguiente modelo en sus configuraciones probadas dentro del dispositivo.
¿Cuánto cuesta la API de LFM3?
El modelo de texto cuesta 0,08 $ por millón de tokens de entrada, 0,02 $ almacenados en caché y 0,20 $ por millón de tokens de salida, lo que equivale a 0,28 $ por un millón de tokens de entrada más un millón de tokens de salida. Vision cuesta 0,60 $ en la misma base, y Audio y Omni cuestan 1,10 $ antes de los cargos de tokens de audio.
¿Está realmente abierto LFM3?
Los pesos son de peso abierto bajo la Licencia Abierta de LFM v1.0 y disponibles en Hugging Face, Liquid AI Playground y la API de Liquid AI. Consulta los términos de licencia para tu caso de uso comercial, ya que las licencias de peso abierto varían.
¿Qué modelo de LFM3 debería elegir?
Elige 1.7B para agentes de texto, VL-2B para imágenes y vídeo, Audio-2B para voz, Omni-2B para asistentes multimodales combinados y d1-2B o d1-omni-2B cuando necesites decisiones calibradas con probabilidades en lugar de texto generado.
¿Cómo se compara LFM3 con Kimi K3.1 Pro o GPT-6.1 Terra?
Están dirigidos a diferentes niveles. Kimi K3.1 Pro es un modelo abierto mucho más grande orientado a la frontera, y GPT-6.1 Terra es el modelo de uso medio de OpenAI para uso de nivel medio y alojado. LFM3 es más pequeño, barato y está diseñado para funcionar en un dispositivo. Compáralos con tu propia tarea y hardware, no con un único benchmark, ya que diferentes benchmarks miden distintas habilidades.
¿Dónde puedo probar LFM3?
En Hugging Face, el Liquid AI Playground, la Liquid AI API, y a través de socios como OpenRouter, Qualcomm AI Hub y Vercel.
Fuentes: Lanzamiento de Liquid AI, cobertura de lanzamiento Unite.AI, cobertura de precios de VentureBeat y la tarjeta modelo LFM3-1.7B en Hugging Face.
- liquid ai lfm3
- lfm3
- open weight models
- on-device ai
- liquid ai
- ai agents
- small language models