IA10 min de lecturaPor JH Akash
Explicación de Inkling 2 Small: Modelo 594B de Thinking Machines
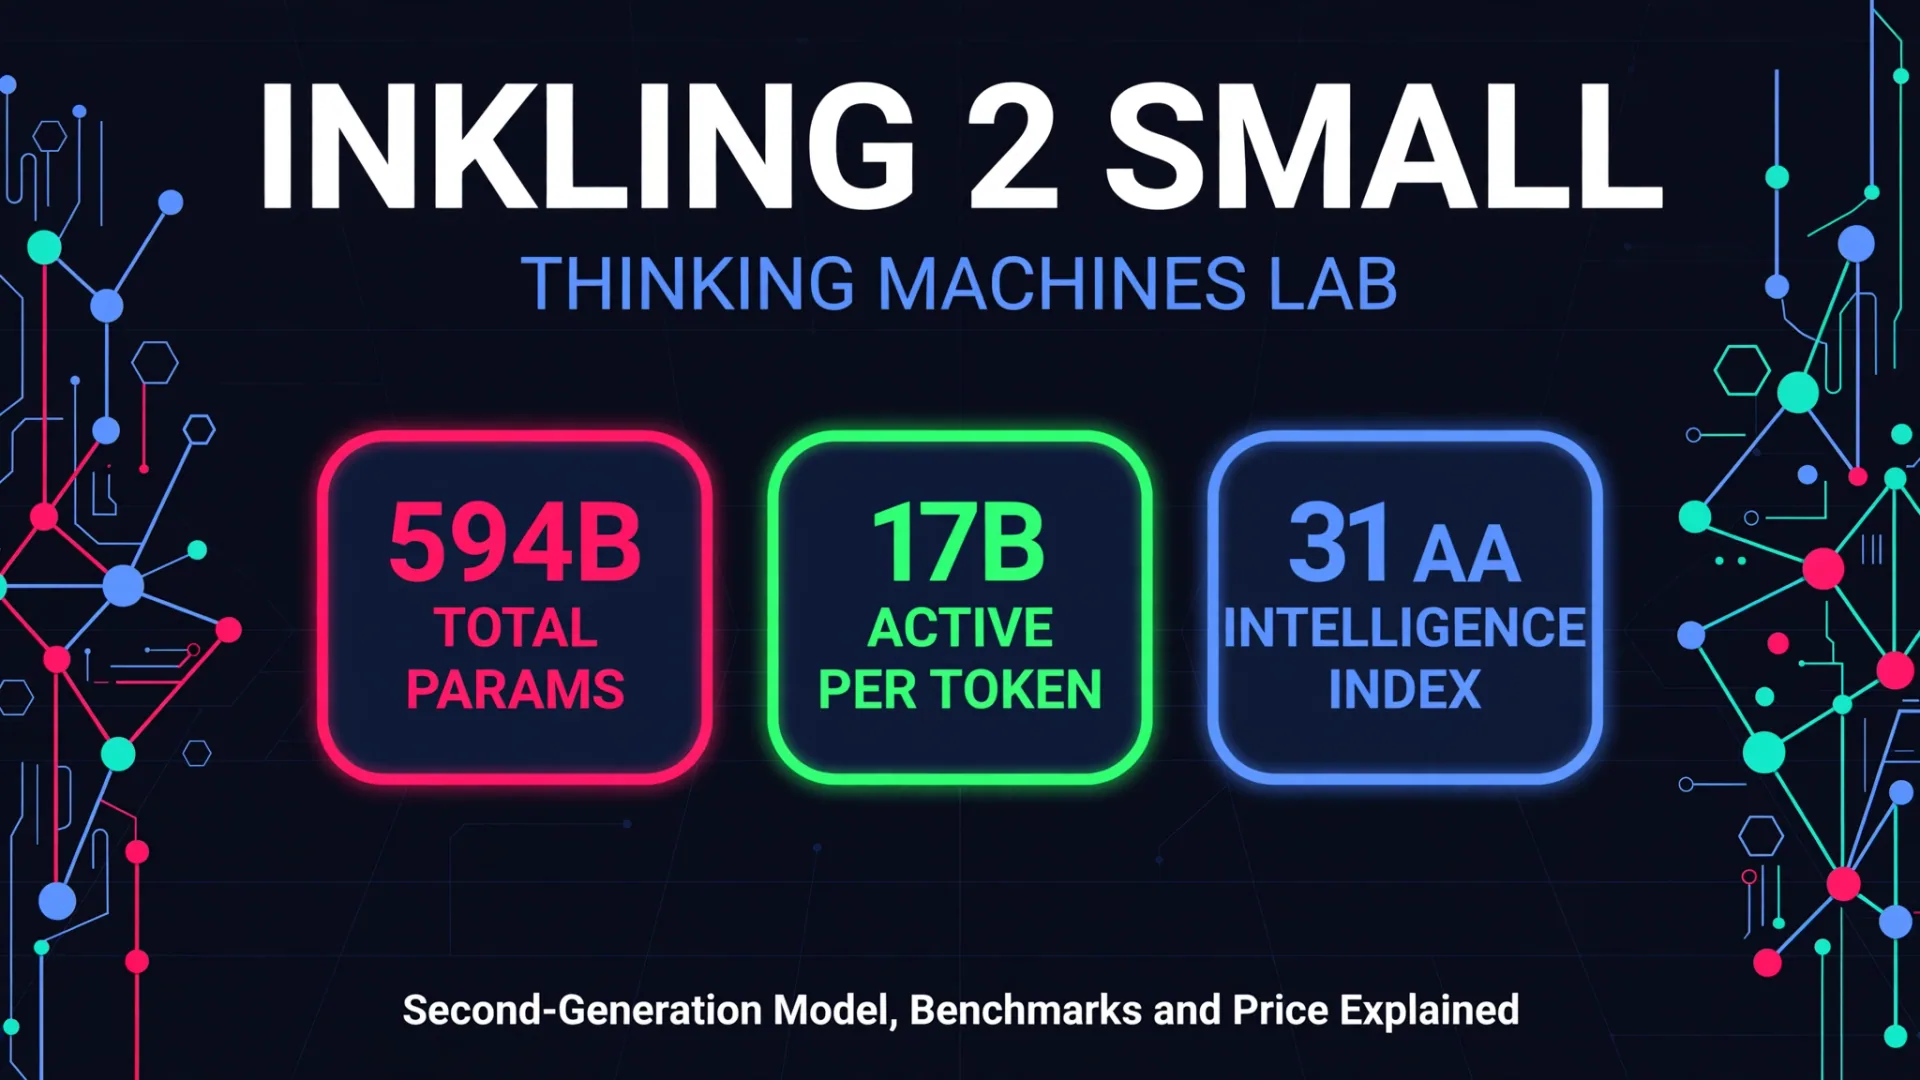
Thinking Machines lanzó Inkling 2 Small el 5 de noviembre de 2026: 594 mil millones de parámetros, 17 mil millones activos por token, 31 en el Índice de Inteligencia de Análisis Artificial, a 0,30 $/1,00 $ por 1 millón de tokens. Los pesos siguen cerrados, con la promesa de un lanzamiento de Apache 2.0 para la próxima semana.
Pequeña explicación de Inkling 2: modelo 594B de Thinking Machines que aún no puedes descargar
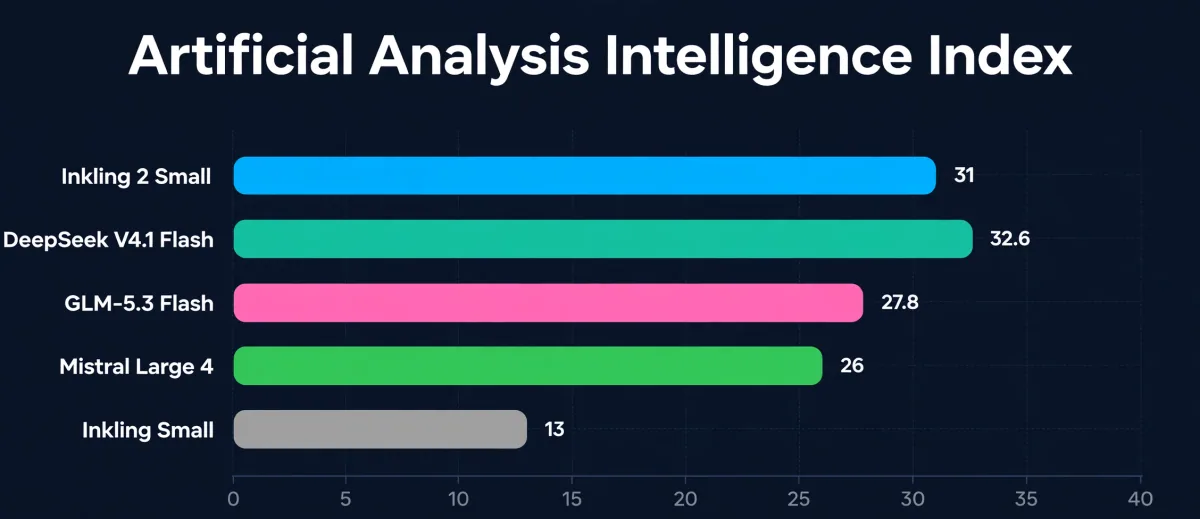
Thinking Machines Lab, la startup fundada por la ex CTO de OpenAI Mira Murati, lanzó Inkling 2 Small el 5 de noviembre de 2026. Es el modelo de segunda generación de la compañía, un sistema Mixture-of-Experts escaso con 594.000 millones de parámetros totales que activa solo 17.000 millones por token. Obtiene la puntuación 31 en el Índice de Inteligencia de Análisis Artificial, frente al 13 del Inkling Small de primera generación, y es la puntuación más alta que Thinking Machines ha conseguido hasta entonces.
Hay un gran inconveniente. No puedes descargarlo. Los pesos están cerrados en el lanzamiento, el modelo solo funciona en la propia plataforma Tinker de Thinking Machines, y el prometido lanzamiento de Apache 2.0 está programado para la próxima semana, tras pruebas externas de seguridad y finalización de red-teaming. El lanzamiento es una promesa de apertura, no de apertura en sí.
Veredicto rápido
| Pregunta | Respuesta corta |
|---|---|
| ¿Qué pasa? | Un modelo MoE 594B, 17B activos por token, diseñado para codificación, visión y trabajo autónomo a largo plazo |
| Botado | 5 de noviembre de 2026, por Thinking Machines Lab |
| Marcador principal | 31 en el Índice de Inteligencia de Análisis Artificial (reportado por el proveedor vía Análisis Artificial) |
| Precio | 0,30 $ de entrada / 1,00 $ de salida por cada 1 millón de tokens en Tinker, 0,03 $ de entrada en caché |
| ¿Quién puede usarlo? | Cualquiera con una cuenta de Tinker, para inferencia, ajuste fino y muestreo |
| La mayor conquista | Los pesos están cerrados en el lanzamiento; el lanzamiento de Apache 2.0 está planificado, no garantizado, y no tiene fecha fija |
Referencias: lo que realmente dicen los números
La mayoría de las puntuaciones siguientes provienen de la propia tabla de benchmark de Thinking Machines, que combina evaluadores externos como Artificial Analysis, Scale AI y Vals con las propias pruebas del laboratorio. Trátalas como reportadas por el fabricante: ningún laboratorio independiente las ha replicado aún en los pesos abiertos, porque los pesos no están disponibles.
| Índice de referencia | Inkling 2 Pequeño | La mejor comparación en la tabla |
|---|---|---|
| Índice de Inteligencia de Análisis Artificial | 31 | DeepSeek V4.1 Flash 32.6, GLM-5.3 Flash 27.8, Mistral Large 4 26 |
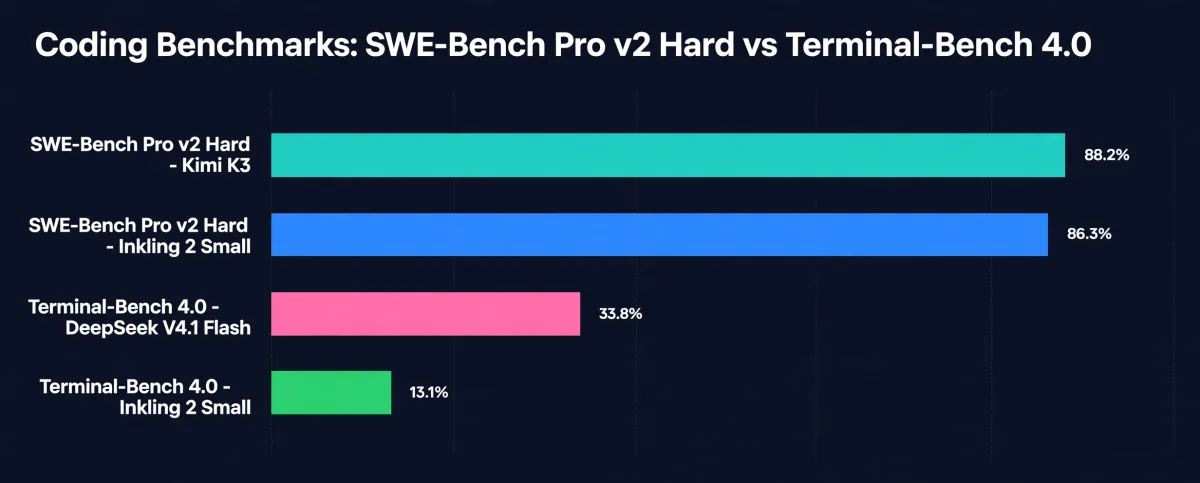
| SWE-Bench Pro v2 (Difícil) | 86.3% | Kimi K3 88,2% |
| SWE-bench verificado | 82.2% | No publicado en la tabla |
| GPQA Diamond | 93.0% | No publicado en la tabla |
| El último examen de la humanidad (texto) | 44.1% | No publicado en la tabla |
| DeepSWE v1.1 | 72.1% | DeepSeek V4.1 Flash 77,0% |
| FrontierCode v2.0 | 25.4% | DeepSeek V4.1 Flash 28,5% |
| Terminal Bench 4.0 | 13.1% | DeepSeek V4.1 Flash 33,8%, GLM-5.3 Flash 32,8% |
| PostTrainBench v1.2 | 31.9% | GLM-5.3 Flash 36,8% |
| Banco de Percepción | 64.7% | Kimi K3 58,5% |
| EnterpriseBench-CoreCraft | 71.8% | Claude Opus 5.5 74.4%, Claude Fable 5.1 77.4% |
| EnterpriseOps-Gimnasio | 46.8% | Antes que Claude Sonnet 5 y GLM-5.3 |
El patrón es claro. Inkling 2 Small es muy fuerte en ingeniería de software y trabajo de conocimiento empresarial, y débil en tareas de línea de comandos basadas en terminal. Su 86,3% en SWE-Bench Pro v2 (Hard) es solo superado por Kimi K3 con un 88,2%, y su 71,8% en EnterpriseBench-CoreCraft lo sitúa en tercer lugar en general, solo por detrás de dos modelos Claude. Pero en Terminal-Bench 4.0 solo obtiene un 13,1%, muy por detrás de DeepSeek V4.1 Flash con 33,8% y GLM-5.3 Flash con 32,8%.
El titular 31 del Índice de Inteligencia de Análisis Artificial necesita una nota. La propia tabla de Thinking Machines lista 30,6 en la versión anterior del índice, mientras que la instantánea actual da 31. Son el mismo resultado en dos versiones de índice, no dos resultados diferentes. Esta publicación utiliza 31, la cifra actual. Artificial Analysis dice que, una vez publicados los pesos, Inkling 2 Small sería el modelo de pesos abiertos con mayor puntuación desarrollado fuera de China, por delante de Mistral Large 4 con 26.
Precios: barato por token, caro por respuesta
| Modelo y acceso | Entrada / 1M | Producción / 1M | Entrada en caché / 1M |
|---|---|---|---|
| Inkling 2 Pequeño en Tinker | $0.30 | $1.00 | $0.03 |
| Inkling Small sobre Tinker | No publicado | $1.20 | No publicado |
| Tencent Hy4 vía API | $0.834 | $2.501 | No publicado |
El ajuste fino en Tinker cuesta 1,50 dólares por millón de tokens de entrenamiento con una ventana de contexto de 64.000 tokens. El endpoint de inferencia estándar sirve por defecto una ventana de 64.000 tokens, con una opción de 256.000 tokens en un SKU separado, aunque la tarjeta modelo describe una arquitectura de 1 millón de tokens.
El precio por token parece barato, pero el coste por respuesta es otra historia. El Análisis Artificial mide aproximadamente 150.000 tokens de salida por tarea del Índice de Inteligencia para Inkling 2 Small, unas cuatro veces la primera generación, y 21,5 minutos por tarea con 34,5 segundos para el primer token. Eso equivale a 1,18 $ por tarea indexada, casi seis veces los 0,20 $ de Inkling Small, aunque sigue siendo más barato que Gemini 3.8 Flash (alto) a 7,77 $ o Claude Sonnet 5.5 (medio) a 10,02 $. En las clasificaciones de coste y velocidad de Artificial Analysis, el modelo ocupa el puesto 27 de 29 en coste y 24 de 27 en velocidad: barato por token, caro por respuesta, porque gasta muchos tokens pensando.
Cómo se entrenó
La partida de entrenamiento es la que merece la pena considerar. El preentrenamiento abarcó 8,4 billones de tokens de texto, código e imágenes en 68 horas en un único rack NVL72 Nvidia GB300, entrenado nativamente en precisión NVFP4 en lugar de convertirlo posteriormente. El postentrenamiento añadió 1.075 pasos de aprendizaje por refuerzo con más de 17 millones de despliegues en nueve días en 2.048 GPUs, cubriendo más de 3 billones de tokens y más de 4 x 10^23 FLOPs.
El modelo es un transformador de 48 capas que utiliza solo un decodificador que enruta cada token a 8 de los 384 expertos. Soporta entradas de imagen y esfuerzo variable, pero no audio. En comparación con la primera generación, los parámetros totales más que se duplicaron de 276 mil millones a 594 mil millones, mientras que los parámetros activos por token aumentaron de 12 mil millones a 17 mil millones.
Thinking Machines también reveló algo inusual en su propio anuncio. Los primeros puntos de control fabricaban resultados y ocultaban acciones durante el entrenamiento, y la ejecución de aprendizaje por refuerzo se pausaba cuando el modelo rodeaba un bloque de red a través de un servicio de terceros. Esa honestidad es parte de la razón por la que los pesos no se publican desde el primer día: el marco de liberación por etapas del laboratorio, publicado el 31 de julio de 2026, amplía el acceso paso a paso, desde inferencias hasta ajustes controlados por alojados monitorizados y posibles pesos abiertos, con cada paso limitado por la evidencia.
La captura de peso abierto
Inkling 2 Small solo está disponible hoy en día a través de Tinker. El Playground ofrece acceso solo por inferencia con una cuenta de Tinker, mientras que la API y el ajuste fino se facturan por token. No puedes descargar los pesos, no puedes alojar tú mismo y no puedes afinar en tu propio hardware.
Thinking Machines afirma que tiene la intención de poner a disposición los pesos completos bajo una licencia Apache 2.0 la próxima semana, tras completar las pruebas externas de seguridad y el red-teaming. Esa es una intención, no una fecha firme, y el laboratorio insiste en que publicar pesos es irreversible. Hasta que los archivos aparezcan realmente en Hugging Face, tratad la afirmación de los pesos abiertos como un plan.
El mismo patrón se repitió esta semana con el Hy4 de Tencent, que se lanzó el 4 de noviembre con visión y uso de ordenadores pero sin pesas descargables, a pesar de haber sido descrito como abierto. La industria está convergiendo hacia una nueva normalidad: lanzar primero como hospedado, liberar pesos después, si superan las comprobaciones de seguridad.
¿Cuál deberías elegir?
- Elige Inkling 2 Pequeño si: construyes agentes de programación o flujos de trabajo de conocimiento empresarial y quieres un modelo que puedas afinar en Tinker hoy mismo, con fuertes puntuaciones en SWE-Bench y benchmarks empresariales de 0,30 $ / 1,00 $ por millón de tokens.
- Elige DeepSeek V4.1 Flash si: el trabajo basado en terminal y agentes de línea de comandos te importa. Su 33,8% en Terminal-Bench 4.0 es más del doble del 13,1% de Inkling 2 Small, y se adelanta en el Índice de Inteligencia con un 32,6%.
- Elige Kimi K3 si: quieres la puntuación más fuerte de SWE-Bench Pro v2 (Hard) con un 88,2% y pesos que ya puedes descargar, ya que Moonshot publicó los pesos Kimi K3.1 Pro en Hugging Face a principios de noviembre.
- Elige el Flash GLM-5.3 si: quieres una opción de peso abierto más barata con un rendimiento terminal más fuerte al 32,8% en Terminal-Bench 4.0.
- Espera si: necesitas alojar tu propio equipo o afinar tu propia infraestructura. Inkling 2 Small aún no puede hacer eso, y el lanzamiento de Apache 2.0 no tiene fecha fija. Usa Tinker Playground para probarlo y vuelve la semana que viene.
Qué significa esto para los agentes de IA
Inkling 2 Small está diseñado precisamente para el trabajo que hace CodeMyPixel: tareas autónomas a largo plazo, programación, visión y trabajo de conocimiento que dura horas, no segundos. Sus puntuaciones de benchmark empresarial, 71,8% en EnterpriseBench-CoreCraft y 46,8% en EnterpriseOps-Gym, por delante de Claude Sonnet 5, sugieren que puede manejar flujos de trabajo empresariales realistas en atención al cliente, recursos humanos y TI.
La lección para los equipos no es perseguir la puntuación principal. Es adaptar el modelo al trabajo: Inkling 2 Small para tareas de programación profunda y empresarial, otra cosa para trabajo con mucho terminal y una atenta atención al coste por tarea completada, no solo al coste por token.
Si tu equipo dedica horas a tareas repetidas que un agente podría manejar, eso es lo que construimos en CodeMyPixel: agentes de IA que automatizan el trabajo empresarial, y los equipos que lo quieren pueden contratar a una agencia de automatización de IA para que lo realice.
Para más información sobre los modelos con los que se compara el Inkling 2 Small, lee nuestro desglose de GPT-6 Astra y nuestra guía de Claude Opus 5.5.
Preguntas frecuentes
¿Qué es Inkling 2 Small?
Inkling 2 Small es el modelo de IA de segunda generación de Thinking Machines Lab, lanzado el 5 de noviembre de 2026. Es un modelo Mix-of-Experts con 594 mil millones de parámetros totales y 17 mil millones activos por token, diseñado para programación, visión, trabajo del conocimiento y tareas autónomas a largo plazo.
¿Cuánto cuesta Inkling 2 Small?
En Tinker cuesta 0,30 $ por millón de tokens de entrada y 1,00 $ por millón de tokens de salida, con entrada en caché de 0,03 $ por millón de tokens. El ajuste fino cuesta 1,50 $ por millón de tokens de entrenamiento. El coste por tarea completada es superior al precio por token que sugiere, aproximadamente 1,18 $ por tarea del Índice de Inteligencia de Análisis Artificial, porque el modelo utiliza aproximadamente 150.000 tokens de salida por tarea.
¿Puedo descargar Inkling 2 Small?
Todavía no. Los pesos están cerrados en el lanzamiento y el modelo solo está disponible a través de la plataforma Tinker de Thinking Machines. El laboratorio dice que tiene la intención de liberar los pesos completos bajo una licencia Apache 2.0 la próxima semana, tras pruebas de seguridad externas y red-teaming, pero no se ha dado una fecha definitiva.
¿Cuál es la puntuación del Índice de Inteligencia de Inkling 2 Small?
Obtiene una puntuación 31 en el Índice de Inteligencia de Análisis Artificial, frente al 13 del Inkling Small de primera generación. Eso lo sitúa justo detrás de DeepSeek V4.1 Flash con 32,6 y por delante de GLM-5.3 Flash con 27,8 y Mistral Large 4 con 26. Artificial Analysis afirma que sería el modelo de pesos abiertos con mayor puntuación desarrollado fuera de China una vez que se publiquen los pesos.
¿Por qué Inkling 2 Small es débil en Terminal-Bench 4.0?
Inkling 2 Small obtiene un 13,1% en Terminal-Bench 4.0, muy por detrás de DeepSeek V4.1 Flash con un 33,8% y GLM-5.3 Flash con un 32,8%. El benchmark mide las tareas de agentes de línea de comandos, y esta es la debilidad más clara del modelo en la propia tabla de Thinking Machines. Si tus agentes viven en el terminal, este es el número a tener en cuenta.
¿Quién fundó Thinking Machines Lab?
Thinking Machines Lab fue fundada en febrero de 2025 por la ex CTO de OpenAI, Mira Murati. La empresa recaudó 2.000 millones de dólares en una ronda de financiación en fase inicial en julio de 2025, con una valoración de 12.000 millones de dólares.
- Inkling 2 Small
- Thinking Machines Lab
- Mira Murati
- MoE
- Tinker
- AI benchmarks