KI8 Min. LesezeitVon JH Akash
LongCat 2.5 erklärt: Meituans 1,6T multimodales Codierungsmodell
Meituans LongCat 2.5 ging am 2. November 2026 online: 1,6 T Parameter, 1 Million Kontext, native Bild- und Videoeingänge, zu 0,30 $/1,20 $ pro Million Tokens. Benchmarks, Preise und die Haken, die man vor dem Wechsel kennen sollte.
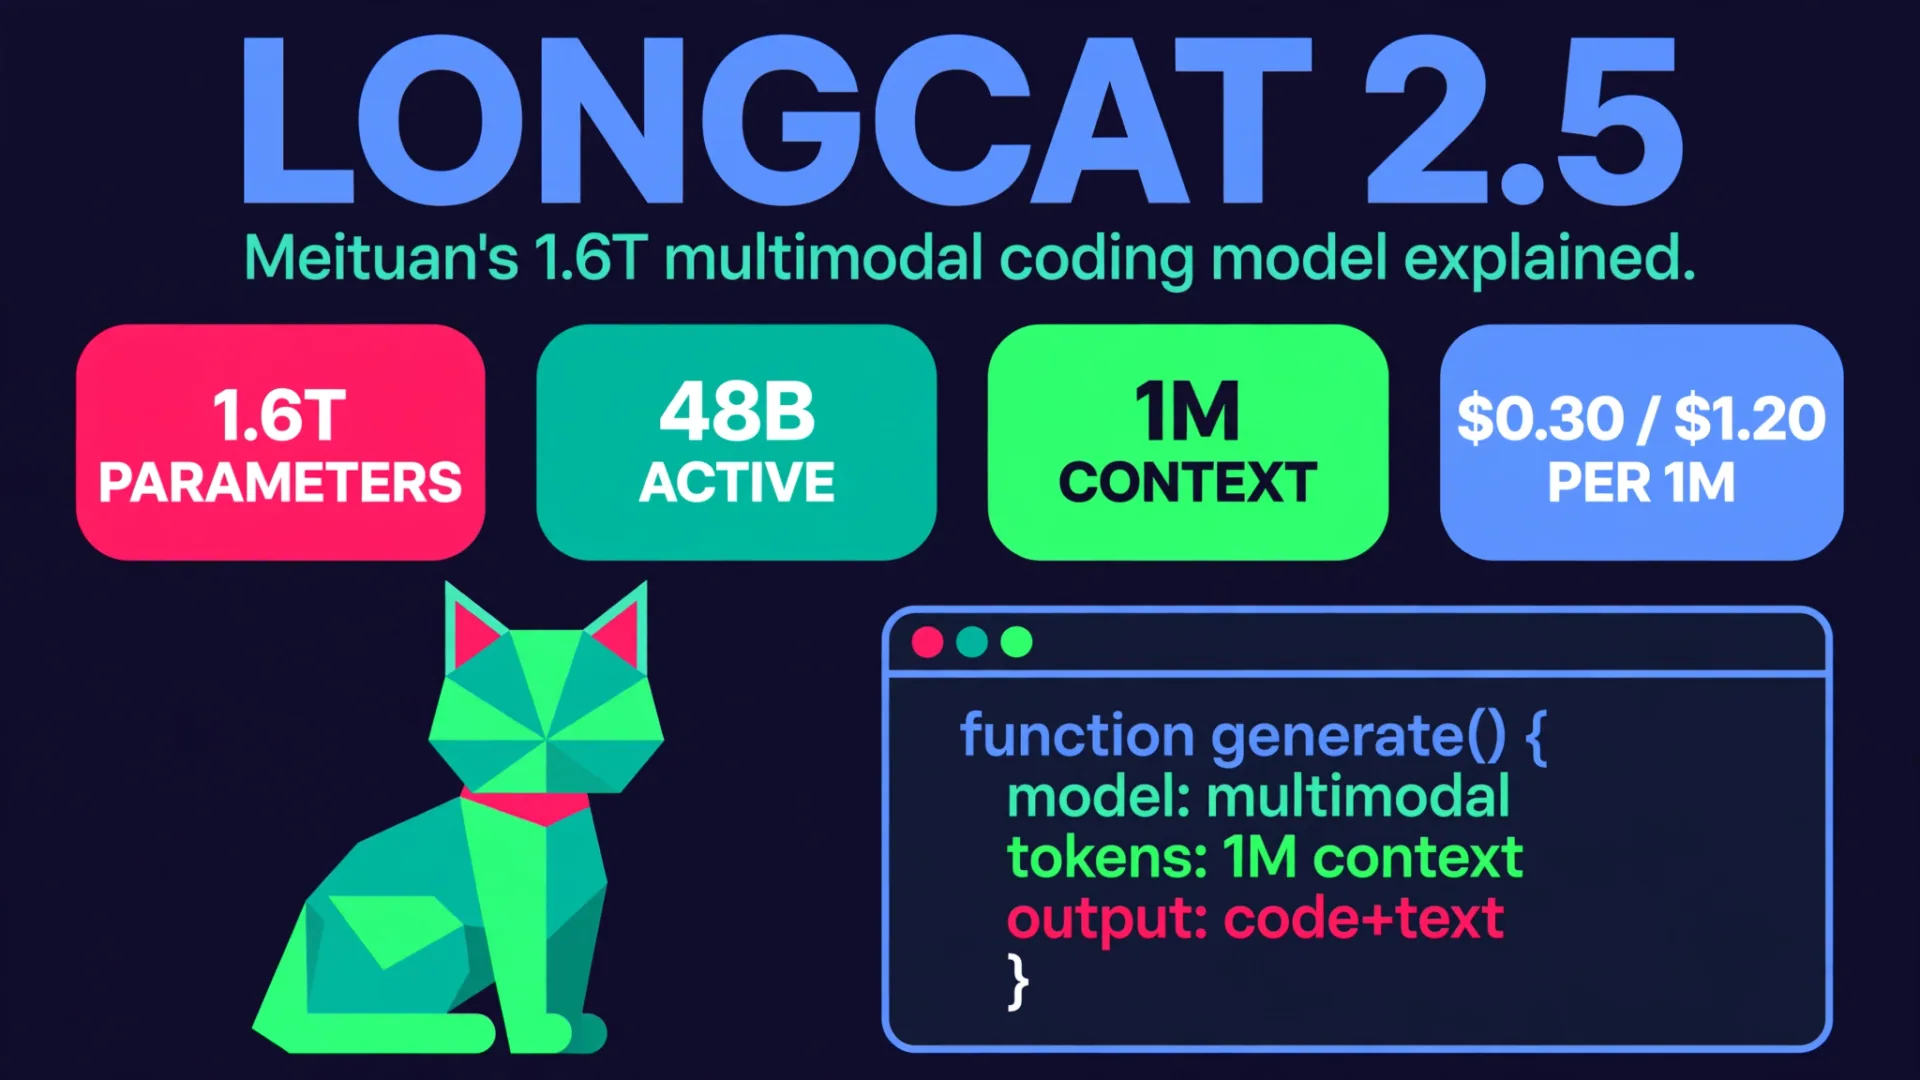
Das LongCat-Team von Meituan brachte LongCat 2.5 am 2. November 2026 heraus, und der Pitch ist leicht verständlich: ein Modell, das Text, Bilder und Videos lesen, lange Coding-Agenten-Aufgaben ausführen kann und dies zu 0,30 $ pro Million Input-Token und 1,20 $ pro Million Output-Token leisten kann. Die Zahlen unter diesem Pitch sind interessanter als die Überschrift. LongCat 2.5 ist ein großer Sprung gegenüber LongCat 2.0, es entspricht DeepSeek V4.1 Flash preismäßig, und die eigene Benchmark-Tabelle zeigt, wo ein günstigerer Konkurrent beim reinen Codieren immer noch führend ist.
Dies ist kein neues, größeres Modell. LongCat 2.5 baut auf LongCat 2.0 auf, einem 1,6-Billionen-Parameter-Mix-of-Experten-Modell mit etwa 48 Milliarden aktiven Parametern pro Token. Die Änderung hängt davon ab, was das Modell sehen kann und wie viel Agententraining es erhalten hat. Alle Benchmark-Scores in diesem Beitrag werden von Meituan vom Anbieter berichtet, sofern nicht anders angegeben, und zum Zeitpunkt des Schreibens hatte keine unabhängige Bestenliste LongCat 2,5 bewertet.
Kurzes Urteil
| Gegenstand | LongCat 2.5 |
|---|---|
| Veröffentlichung | 2. November 2026, allgemeine Verfügbarkeit auf der LongCat API Platform |
| Größe | 1,6 Billionen Parameter insgesamt, etwa 48 Milliarden aktive pro Token |
| Eingabe | Text, Bilder und Video. Ausgabe ist nur Text |
| Kontext | 1 Million Token. Plane etwa 128.000 Token mit maximalem Output |
| Preis | 0,30 $ pro Million nicht gecachte Eingabetokens, 0,006 $ pro Million zwischengespeicherte Eingabetoken, 1,20 $ pro Million Ausgabetoken, alle mit einem zeitlich begrenzten Rabatt gekennzeichnet |
| Gewichte | Nicht veröffentlicht. GitHub und Hugging Face sind als "bald verfügbar" markiert. |
| Am besten für | Budget-Codierer, die Screenshots oder Bildschirmaufnahmen lesen müssen |
| Pass auf | Kein Listenpreis, keine veröffentlichte Datenaufbewahrungspolitik und noch keine unabhängigen Bewertungen |
Was hat sich von LongCat 2.0 geändert
LongCat 2.0 war nur Text und Open Weight und wurde unter einer MIT-Lizenz mit Gewichten auf Hugging Face veröffentlicht. LongCat 2.5 behält das gleiche 1.6T / 48B-Skelett bei und fügt native Vision plus Long-Horizon-Agententraining hinzu. Die Vorschau erschien am 25. September 2026, und die allgemeine Verfügbarkeit folgte am 2. November 2026 mit Videoeingang und Codex-Unterstützung.
Vision ist die Schlagzeilenfunktion. LongCat 2.5 wandelt Bilder in diskrete Tokens im selben Strom wie Wörter um, anstatt einen Bildencoder an ein Textmodell anzubinden. In der Praxis bedeutet das native Auflösung: Ein hoher Screenshot wird zu mehr Tokens statt zu einem zusammengedrückten Vorschaubild. Die Dokumente erlauben bis zu 50 Bilder pro Anfrage mit jeweils bis zu 10 MB und bis zu 10 Videos mit jeweils 100 MB und unter 3.600 Sekunden. Es gibt keine separate Preisgrenze für Bilder oder Videos. Sie bezahlen für die Tokens, in die sie sich verwandeln.
Auf der Agentenseite beschreibt Meituan groß angelegtes Long-Horizon-Reinforcement Learning bei Aufgaben, die aus gefilterten GitHub-Pull Requests erstellt wurden, mit Strafen für wiederholtes Schließen und wiederholte Toolaufrufe. Das ist wichtig, weil das Schleifen bei langen Aufgaben die lauteste Beschwerde der Preview-Nutzer war. Ob die allgemeine Verfügbarkeit das Problem behoben hat, ist das Erste, was man im eigenen Repository testen sollte.
LongCat 2.5 funktioniert auch über Agenten-Harnesses hinweg, mit Anleitungen für Claude Code, Codex, OpenCode, Cline, Kilo Code und Hermes Agent, unter anderem. Es unterstützt OpenAI- und Anthropic-kompatible Endpunkte, sodass das Wechseln von Harnesses meist eine Basis-URL und Modellnamensänderung ist: LongCat-2.5.
Benchmarks: ein echter Sprung, mit einem Fang
Meituans eigene Tabelle zeigt einen großen Sprung gegenüber LongCat 2.0 bei Agentenaufgaben. Dies sind vom Anbieter berichtete Werte, die mit aktiviertem Denken durchgeführt werden.
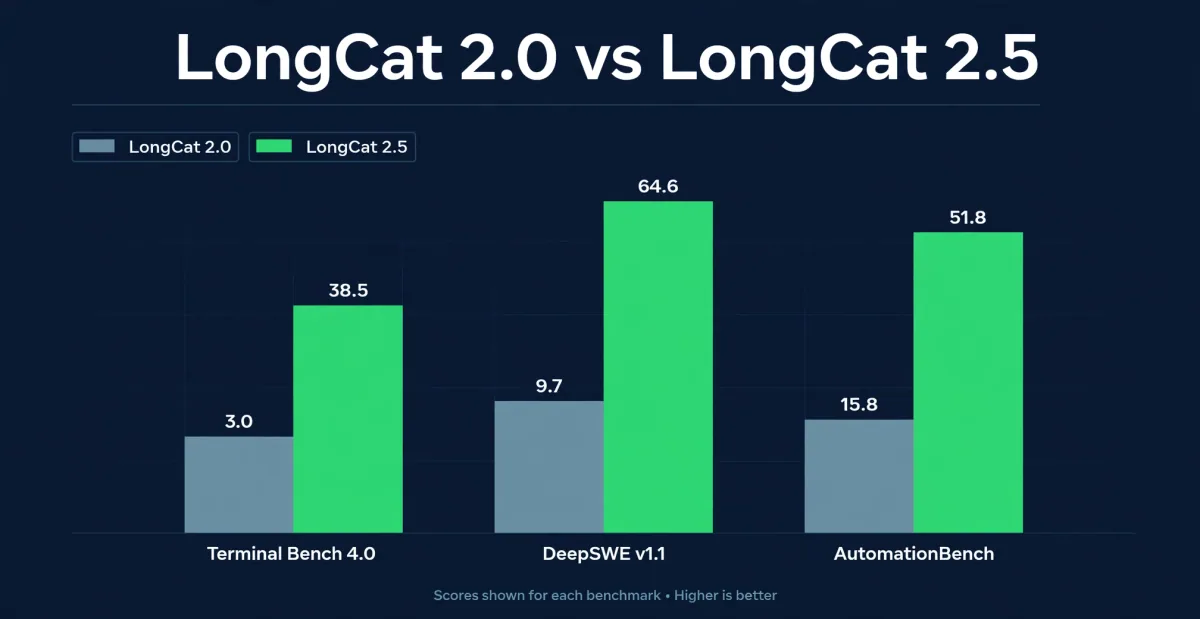
| Benchmark | LongCat 2.5 | LongCat 2.0 | DeepSeek V4.1 Flash | Kimi K3 | Claude Opus 5 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 | 90.6 | 88.3 | 89.1 |
| Terminal Bench v4.0 | 38.5 | 3.0 | 31.2 | 12.6 | 53.9 |
| DeepSWE v1.1 | 64.6 | 9.7 | 74.2 | 67.5 | 68.8 |
| NL2Repo | 60.5 | 40.9 | 65.4 | 58.0 | 75.3 |
| BrowseComp | 91.9 | 79.9 | 91.5 | 91.2 | 90.8 |
| MCP Atlas | 83.1 | 61.8 | 84.4 | 84.2 | 85.8 |
| 3DCodeBench Text in 3D | 55.4 | Nicht gemeldet | 53.4 | 49.3 | 54.3 |
| Vision2Web | 78.6 | Nicht gemeldet | Nicht gemeldet | 79.0 | 80.2 |
Quelle: Meituan LongCat 2.5 Tech-Blog-Bewertungstabelle. Die Bewertungen für andere Modelle sind eine Mischung aus Meituans eigenen Runs und Zahlen aus öffentlichen Berichten, die laut Meituan nur indikativ sind. Verschiedene Benchmarks verwenden unterschiedliche Gurte, daher sollten Sie die Werte zwischen den Benchmarks nicht vergleichen, als wären sie ein einziges Ranking.
Klar zu lesen: LongCat 2.5 führt seinen Preiskonkurrenten auf Terminal Bench 4.0 (38,5 gegenüber 31,2), BrowseComp (91,9 gegenüber 91,5) und 3DCodeBench Text zu 3D (55,4 gegenüber 53,4). DeepSeek V4.1 Flash führt bei Terminal Bench v2.1, DeepSWE v1.1, NL2Repo, MCP Atlas und AutomationBench (54,8 gegenüber 51,8). LongCat 2.5 ist eines der beiden mit veröffentlichten Video-Scores, und seine BrowseComp- und 3D-Ergebnisse passen zu seinem vision-first-Pitch.
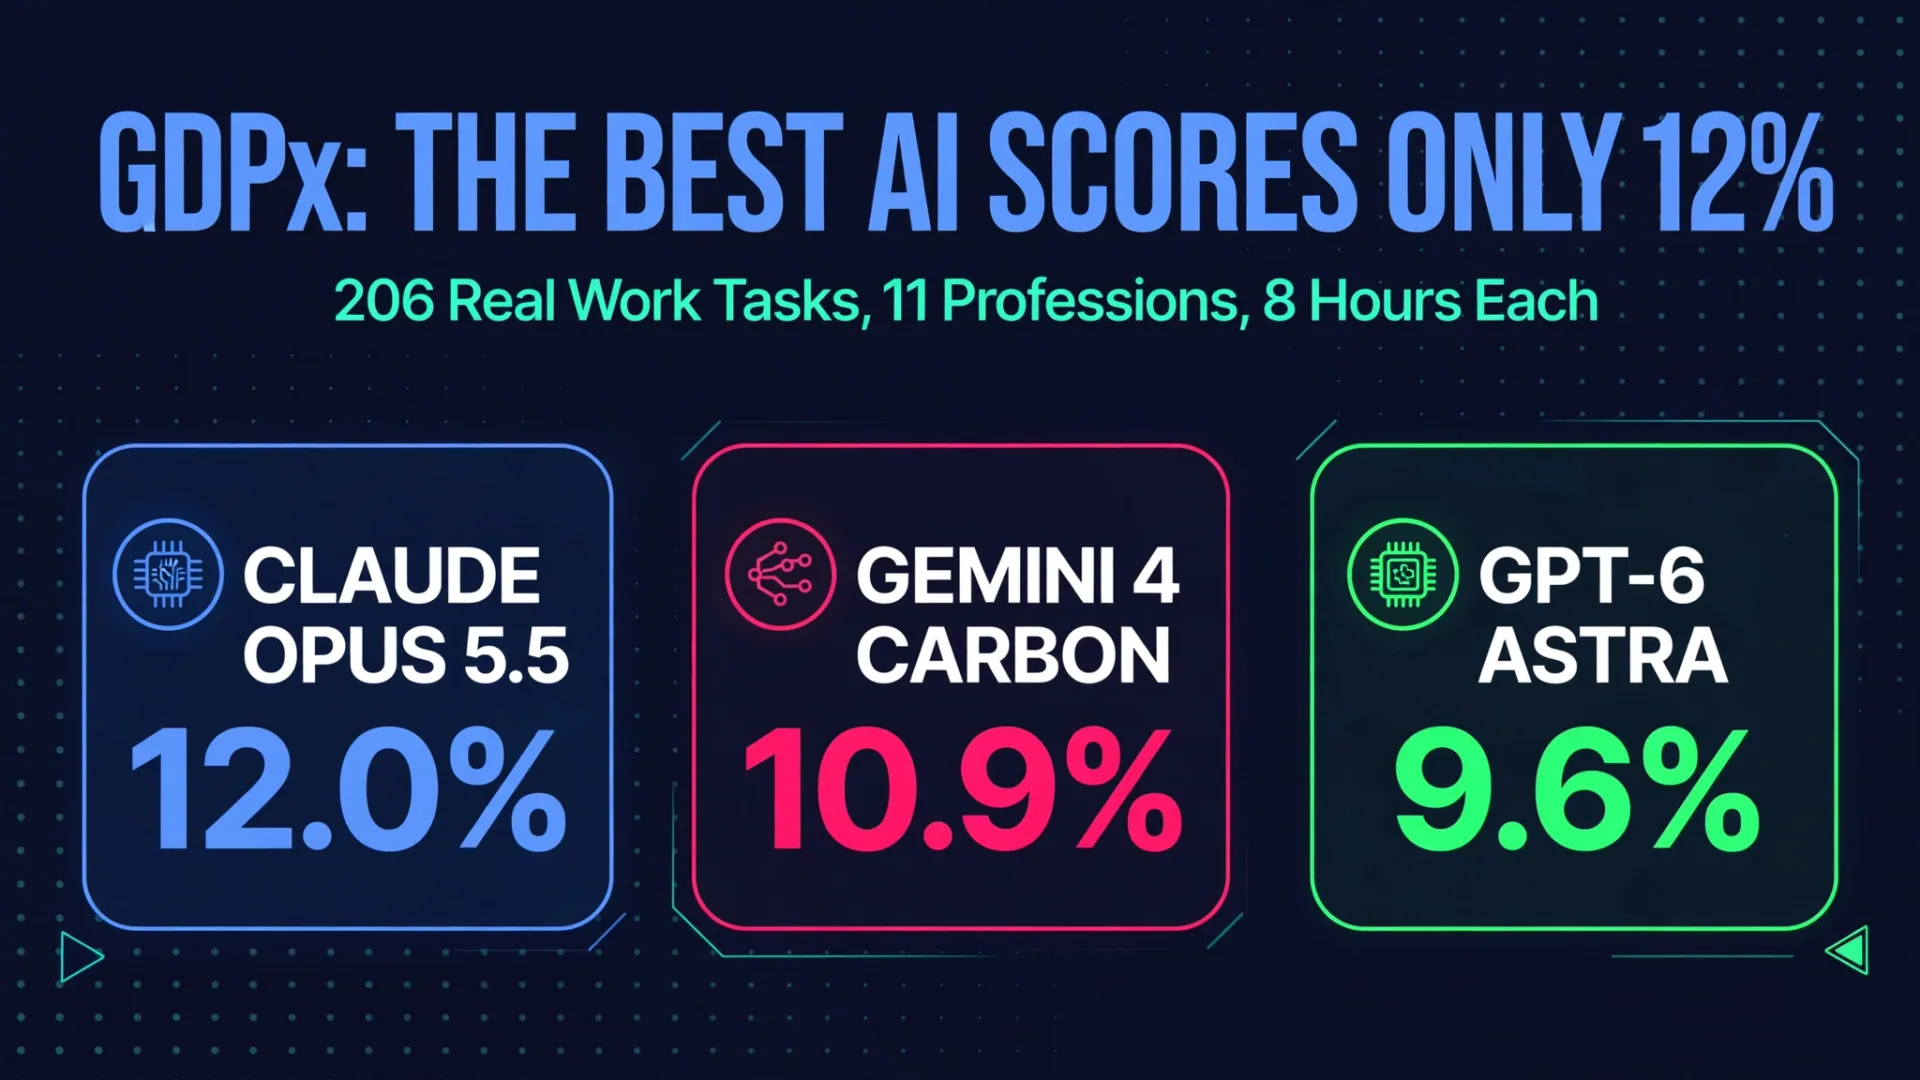
Der Vergleichssatz ist ebenfalls erwähnenswert. Meituans Überschriftendiagramme vergleichen mit Claude Opus 5, GPT-5.6-Sol, Claude Opus 4.8 und GPT-5.5. Sie enthalten nicht Claude Opus 5.5, GPT-6.1 Sol oder Kimi K3.1 Pro. Für das neueste Frontier-Bild siehe unsere früheren Beiträge zu Claude Opus 5.5 und GPT-6 Astra sowie unsere GDPx-Benchmark-Aufschlüsselung, bei der Opus 5.5 mit 12,0 % führt.
Preis: günstig, aber vergünstigt und vorübergehend
| Modell | Eingabe pro 1M Token | Zwischengespeicherte Eingabe pro 1M Token | Ausgabe pro 1M Token |
|---|---|---|---|
| LongCat 2.5, zeitlich begrenzter Rabatt | $0.30 | $0.006 | $1.20 |
| DeepSeek V4.1 Flash, Gipfel | $0.30 | $0.006 | $1.20 |
| DeepSeek V4.1 Flash, außerhalb der Spitzenzeiten | $0.15 | $0.003 | $0.60 |
| Qwen 3.8 Max | $2.00 | $0.25 | $6.00 |
| Kimi K3.1 Pro | $2.00 | $0.20 | $10.00 |
| Kimi K3 | $3.00 | $0.30 | $15.00 |
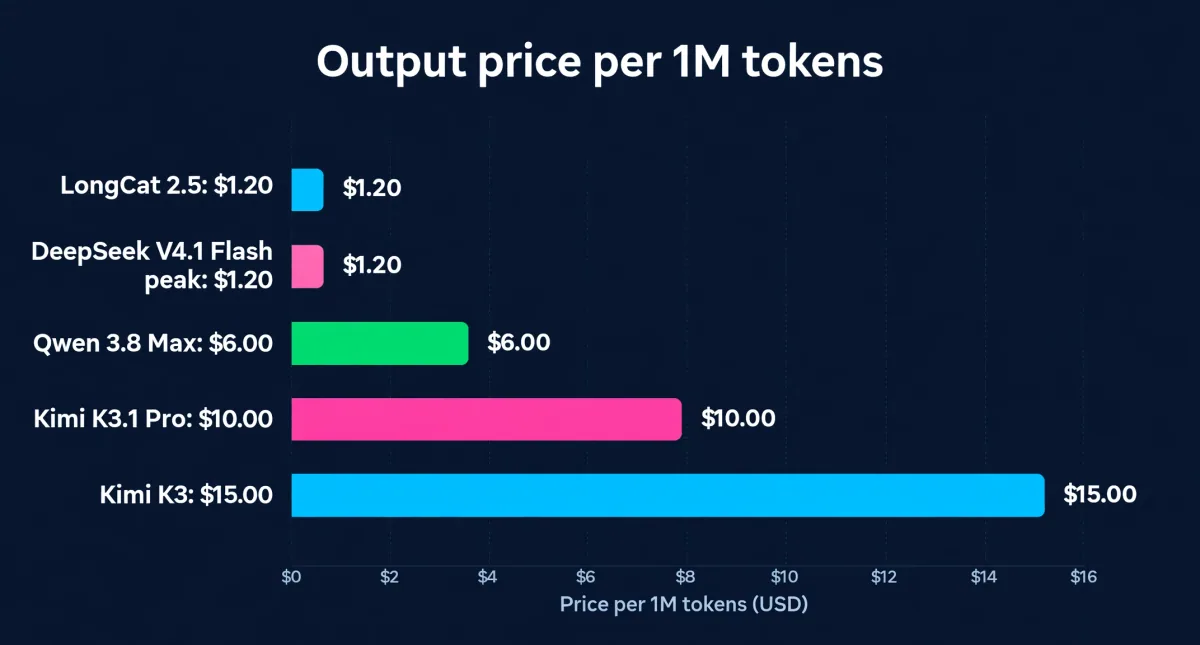
Zwei Details machen den Preis nützlicher als die Überschrift. Zwischengespeicherte Eingaben kosten nur 2 % der nicht zwischengespeicherten Eingabe, was für Codieragenten relevant ist, die dieselben Dateien jede Runde erneut senden. Und es gibt keinen Kontextzuschlag, sodass eine lange Anfrage pro Token genauso viel kostet wie eine kurze.
Eine einfache Rechnung hilft. Eine Aufgabe mit 800.000 nicht gecacheten Eingabetoken und 200.000 Ausgabetoken kostet auf LongCat 2,5 $0,48: 0,8 mal $0,30 plus 0,2 mal $1,20. Meituans eigenes Beispiel, 600.000 nicht gezwischente Eingabetoken, 400.000 zwischengespeicherte Eingabetoken und 500.000 Ausgabetoken, kostet 0,7824 $.
Das Risiko ist das Rabattetikett. Jeder LongCat 2.5-Preis trägt die Worte "zeitlich begrenzter Rabatt", ohne Listenpreis und ohne veröffentlichtes Enddatum. Eine ältere LongCat 2.0-Seite zeigte einen Listenpreis von 0,75 $ Input, 0,015 $ im Cache und 2,95 $ Output neben demselben Rabatt. Meituan hat nicht gesagt, dass LongCat 2.5 auf diesen Listenpreis umsteigen wird, sondern nur dann auf den reduzierten Preis einplanen wird, wenn Sie eine Erhöhung aufnehmen können.
Welche soll ich wählen
Probieren Sie LongCat 2.5 aus, wenn Sie Coding-Agenten mit begrenztem Budget betreiben und eines möchten, das Screenshots oder Bildschirmaufnahmen lesen kann. Bei 0,30 $ / 1,20 $ mit 2 % gecachtem Input kostet ein Nachmittag des Tests auf Ihrem eigenen Repository ein paar Dollar. Vergleichen Sie es direkt mit DeepSeek V4.1 Flash zum gleichen Preis, bei Ihren eigenen Aufgaben, nicht auf Launch-Charts.
Wählen Sie stattdessen DeepSeek V4.1 Flash, wenn Long-Horizon-Codierung das Ganze ist. Auf Meituans eigener Tabelle führt es bei mehr Coding-Zeilen an und halbiert den Preis außerhalb der Spitzenzeit. Außerdem hat es in Drittanbieter-Vergleichen eine längere maximale Ausgabe, mit 384.000 Token gegenüber den geplanten 128.000 von LongCat 2.5.
Warte, wenn du offene Gewichte, eine Lizenz oder Self-Hosting brauchst. LongCat 2.5 ist vorerst nur API, und selbst wenn Gewichte ankommen, benötigt ein 1,6T-Modell ein Multi-GPU-Setup. LongCat 2.0 bleibt die herunterladbare Option.
Überspringen Sie es vorerst, wenn Ihre Prompts Kunden- oder regulierte Daten enthalten. Die LongCat-FAQ- und Abrechnungsseiten sagen nichts darüber, wie lange Prompts gespeichert werden oder ob API-Verkehr für das Training verwendet wird. Dieses Schweigen ist die Entscheidung, egal zu welchem Preis.
Wenn Sie Agenten für Kunden erstellen, anstatt Modelle selbst zu testen, ist das Modell nur ein Teil des Systems. Unsere AI-Agentenentwicklungsdienste und KI-Automatisierungsagenturen decken die umgebenden Aufgaben ab: Tools, Prüfungen, Eskalationsregeln und Deployment.
Fänge, die man vor dem ersten Durchlauf kennen sollte.
- Verwirrung mit der Ausgabe-Grenze. Die Modellparameter-Seite erlaubt maximal 262.144 Token, aber der Schnellstart, die FAQ und Meituans eigene Claude Code-Konfiguration deuten alle auf 128.000 hin. Plane etwa 128.000 und behandle alles darüber als Bonus zum Testen.
- Die Temperatur ist festgelegt. Sie ist 1,0 mit eingeschaltetem Denken und 0,7 bei ausgeschaltetem Denken, und andere Werte werden stillschweigend übersteuert statt verworfen. Wenn dein Evaluierungsgeschirr die Temperatur erfasst, macht er nicht das, was du denkst.
- Ratenbeschränkungen sind unveröffentlicht. Die Limits sind pro API-Schlüssel angegeben und geben eine 429 mit einem 60-sekündigen Wiederholungshinweis zurück, aber es wird keine Zahl für Anfragen pro Minute oder Token pro Minute veröffentlicht.
- Alte Modell-IDs können verschwinden. LongCat 2.0 und 2.5-Preview sind aus den Tabellen der unterstützten Modelle verschwunden, ohne eine datierte Rückzugsbenachrichtigung. Wenn du eine alte ID gepinnt hast, teste sie heute.
- Noch keine unabhängigen Bewertungen. Artificial Analysis listet nur LongCat 2.0 auf, und OpenRouter gibt nur LongCat 2.0 zurück. Ein unabhängiger Vorschau-Test berichtete ein ganz anderes Terminal Bench 2.1-Ergebnis als Meituans 88.4 auf einem anderen Kabelbaum. Führe deinen eigenen Test durch, bevor du dich festlegst.
FAQ
Was ist LongCat 2.5?
LongCat 2.5 ist Meituans neuestes großes Sprachmodell, das seit dem 2. November 2026 allgemein auf der LongCat-API-Plattform verfügbar ist. Es nimmt Text, Bilder und Video als Eingabe, ist auf langlebige Codieragenten optimiert und löst das Openweight-Modell LongCat 2.0 ab.
Wie viel kostet LongCat 2.5?
LongCat 2.5 kostet 0,30 $ pro Million nicht gecachte Eingabetokens, 0,006 $ pro Million zwischengespeicherte Eingabetoken und 1,20 $ pro Million Ausgabetokens. Meituan kennzeichnet alle drei als zeitlich begrenzten Rabatt und veröffentlicht keinen Listenpreis oder Enddatum, sodass der Preis steigen könnte. Das entspricht dem gleichen Satz wie DeepSeek V4.1 Flash zu Spitzenzeiten.
Ist LongCat 2.5 Open Source?
Noch nicht. Der Launch-Blog von Meituan markiert die GitHub- und Hugging Face-Links als "bald erschienen", und bis zum 3. November 2026 war kein LongCat 2.5-Repository oder eine Lizenz erschienen, daher ist es vorerst nur API. LongCat 2.0 bleibt das neueste LongCat-Modell mit offenen MIT-Gewichten.
Kann ich LongCat 2.5 in Claude Code oder Codex verwenden?
Ja. Die Meituan-Dokumentation zeigt, wie man Claude Code auf den Anthropic-Format-Endpunkt mit dem Modell auf LongCat-2.5 verweisen kann, und es gibt eine passende Anleitung für Codex mit der Responses-API. Erwarten Sie Eigenheiten: Die Temperatur ist von der Plattform festgelegt und die Ausgabe ist in der Dokumentation auf 128.000 Token begrenzt.
Wie schneidet LongCat 2.5 im Vergleich zu DeepSeek V4.1 Flash ab?
Preismäßig stimmen sie zu Spitzenzeiten überein: 0,30 $ in und 1,20 $ pro Million Token. Auf Meituans eigener Benchmark-Tabelle führt LongCat 2.5 bei Terminal Bench 4.0, BrowseComp und 3DCodeBench Text zu 3D, während DeepSeek V4.1 Flash bei mehr Long-Horizon-Coding-Zeilen führt und außerhalb der Spitzenzeiten günstiger ist. LongCat 2.5 fügt Videoeingang hinzu, was DeepSeek V4.1 Flash in diesem Vergleich nicht erreicht.
Ist LongCat 2.5 gut für den Kundensupport?
Heute nicht als erste Wahl. Die LongCat-Dokumentation sagt nichts über Datenspeicherung oder Training bei API-Daten, was relevant ist, wenn Abfragen Kundendaten enthalten. Für Support-Arbeit ist ein erprobter Helpdesk-Mitarbeiter mit klarer Datenverarbeitung der sicherere Weg, als ein Rohmodell in eine Warteschlange zu verdrahten.
Fazit
LongCat 2.5 ist ein echtes Upgrade gegenüber 2.0, mit Vision, die eingebaut statt angeschraubt ist – zu einem Preis, der sich nicht verändert hat. Es ist nur nicht die offensichtliche Wahl zu seinem Preis für reines Coding, und seine eigene Benchmark-Tabelle ist der Ort, an dem man das sehen kann. Teste es an visionsintensiver Agentenarbeit, vergleiche es mit DeepSeek V4.1 Flash in deinem eigenen Repository und halte Kundendaten heraus, bis Meituan eine klare Datenrichtlinie veröffentlicht.
- LongCat 2.5
- Meituan
- AI coding agents
- multimodal AI
- DeepSeek
- AI benchmarks