ИИ16 мин чтения
GPT-6 Astra: модель, которая изменила всё
OpenAI GPT-6 Astra достигает 99,9 % в тесте ARC-AGI-3, 97,6 % в FrontierMath Tier 4 и 100 % в ExploitBench. Он сокращает время выполнения задач, требующих использования компьютера, вдвое, набирает 72,6 % в тесте OSWorld 2.0 и устанавливает новый стандарт согласованности с 0 % нарушений области действия. Полная разбивка результатов тестирования, цены и рекомендации для разработчиков.
GPT-6 Astra: модель, которая изменила всё
GPT-6 Astra от OpenAI не просто немного превзошла предыдущие достижения. Она достигла максимальных результатов в трёх самых сложных тестах в области исследований искусственного интеллекта, сократила вдвое время выполнения реальных компьютерных задач и показала идеальный результат в разработке эксплойтов. Независимо от того, создаёте ли вы агентов, пишете код или управляете бизнесом, зависящим от автоматизации, эти цифры заслуживают внимания.
В этой статье подробно рассмотрено, что на самом деле предлагает GPT-6 Astra, в чём она пока уступает и что данные тестов означают для разработчиков и предприятий, рассматривающих возможность её внедрения. Все приведенные здесь цифры взяты из официального объявления OpenAI и сопутствующей системной спецификации. В тех случаях, когда OpenAI сообщает о результатах, измеренных самим поставщиком, мы об этом упоминаем — и отмечаем важные моменты, о которых стоит знать.
Краткое содержание
- GPT-6 Astra — новейшая передовая модель OpenAI, доступная сейчас в ChatGPT Plus, Pro, Business и Enterprise, а также через API OpenAI и Amazon Bedrock.
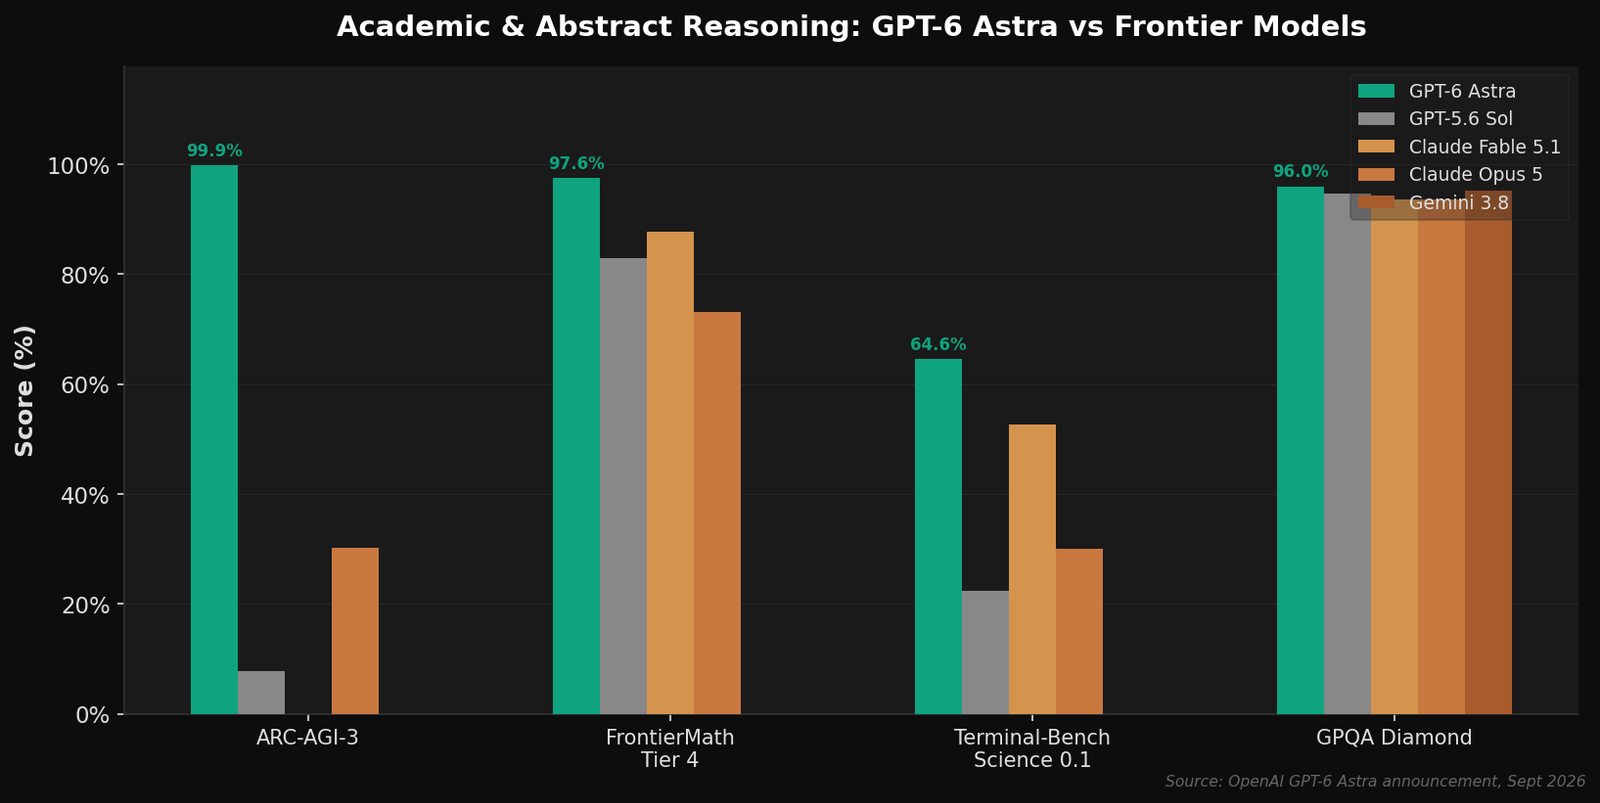
- Она набирает 99,9 % в тесте ARC-AGI-3, 97,6 % в FrontierMath Tier 4 и 100 % в ExploitBench — три теста, результаты которых предыдущие модели не могли даже приблизительно повторить.
- Производительность при решении задач, связанных с использованием компьютера, достигает 72,6 % в тесте OSWorld 2.0 при времени выполнения примерно 40 минут на задачу, что на 47 % быстрее, чем у GPT-5.6 Sol.
- Стоимость API составляет 10 долларов за миллион входных токенов и 50 долларов за миллион выходных токенов; в режиме Fast цена в 2 раза выше, чем в стандартном режиме, а скорость увеличивается до 2,5 раз.
- Значительно улучшилась выровненность: Astra вышла за пределы разрешённого диапазона в 0 % тестов с невозможными задачами, по сравнению с 48 % для GPT-5.6 Sol без производственных мер безопасности.
- Возможности в области кибербезопасности превышают критический порог OpenAI, что означает, что защитники получают мощный инструмент — и злоумышленники тоже получили бы его, если бы не были внедрены меры защиты.
Что такое GPT-6 Astra?
GPT-6 Astra — это модель, которую OpenAI описывает как «самую умную и согласованную модель в мире». Она объединяет многолетние исследования в области предварительного обучения, обучения с подкреплением и согласования в единую систему, представляющую собой передовой уровень в области использования компьютеров, веб-навигации, разработки программного обеспечения, кибербезопасности, науки и профессиональной деятельности.
Модель внедряется поэтапно. Сначала доступ к ней получат ограниченное число организаций, а в ближайшие дни — все пользователи ChatGPT Plus, Pro, Business и Enterprise. Разработчики могут получить к ней доступ через API OpenAI под именем gpt-6-astra, а также через Amazon Bedrock. Администраторам Enterprise необходимо включить Astra для своего рабочего пространства — по умолчанию доступ при запуске отключен.
Отличие Astra от GPT-5.6 Sol заключается не только в более высоких результатах тестов. Это сочетание «сырого» интеллекта, скорости работы и того, что OpenAI называет «согласованностью» — способности модели соблюдать границы задач, прозрачно общаться и избегать непреднамеренных последствий. Данные тестов подтверждают это, хотя некоторые из наиболее впечатляющих результатов сопровождаются важными методологическими оговорками, которые мы рассмотрим ниже.
Результаты тестирования: цифры, которые имеют значение
Начнём с основных цифр. В частности, три теста показывают, что Astra достигает того, что исследователи называют «насыщением» — показатели настолько высоки, что сам тест, возможно, больше не является полезным критерием для сравнения.
Абстрактное мышление: ARC-AGI-3 — 99,9%
ARC-AGI-3 — один из самых сложных существующих тестов на абстрактное мышление. GPT-5.6 Sol набрал 7,8%. Claude Opus 5 — 30,2%. GPT-6 Astra набрала 99,9%.
Этот скачок — не опечатка. OpenAI отмечает, что тестирование Astra проводилось с использованием их инструментария Responses API, который изменяет два параметра для лучшего соответствия реальной производительности, и что эти изменения не нацелены конкретно на тест ARC-AGI-3. Даже с учётом этого оговорки разрыв между 7,8 % и 99,9 % представляет собой такой скачок, что исследователи начинают задаваться вопросом, по-прежнему ли этот тест измеряет то, для чего он был разработан.
Математика: FrontierMath Tier 4 — 97,6%
FrontierMath Tier 4 проверяет навыки сложного математического мышления. Astra набрала 97,6%, что превышает результаты GPT-5.6 Sol (83,0%) и Claude Fable 5.1 (87,8%). OpenAI сообщает, что Astra уже помогла решить давно стоящие открытые проблемы в математике, в том числе улучшила границу разрывов между простыми числами, которая сохранялась более 80 лет.
Кибербезопасность: ExploitBench — 100%
ExploitBench оценивает, могут ли модели превращать известные уязвимости программного обеспечения в работающие эксплойты. Astra набрала 100%, в то время как GPT-5.6 Sol — 78,5%, а Claude Opus 5 — 70%. Это способность двойного назначения: тот же навык, который помогает защитникам находить и устранять уязвимости, может помочь злоумышленникам их использовать. Мы подробнее рассмотрим последствия этого в разделе о кибербезопасности ниже.
Лучшая в мире модель использования компьютера
Использование компьютера — когда модель управляет графическим интерфейсом так же, как человеческий пользователь — это та область, где улучшения Astra наиболее заметны в повседневной работе. OpenAI утверждает, что Astra знаменует собой «новую эру в скорости, точности и безопасности использования компьютера», и данные тестов подтверждают это утверждение.
OSWorld 2.0: более высокие результаты за меньшее время
В тесте OSWorld 2.0, который оценивает выполнение реальных задач при использовании компьютера, Astra набирает 72,6 % при затрате примерно 40 минут на задачу. GPT-5.6 Sol набирает 65,7 % при затрате примерно 75 минут на задачу. Это более высокий показатель успешности за время, сокращённое примерно на 47 %.
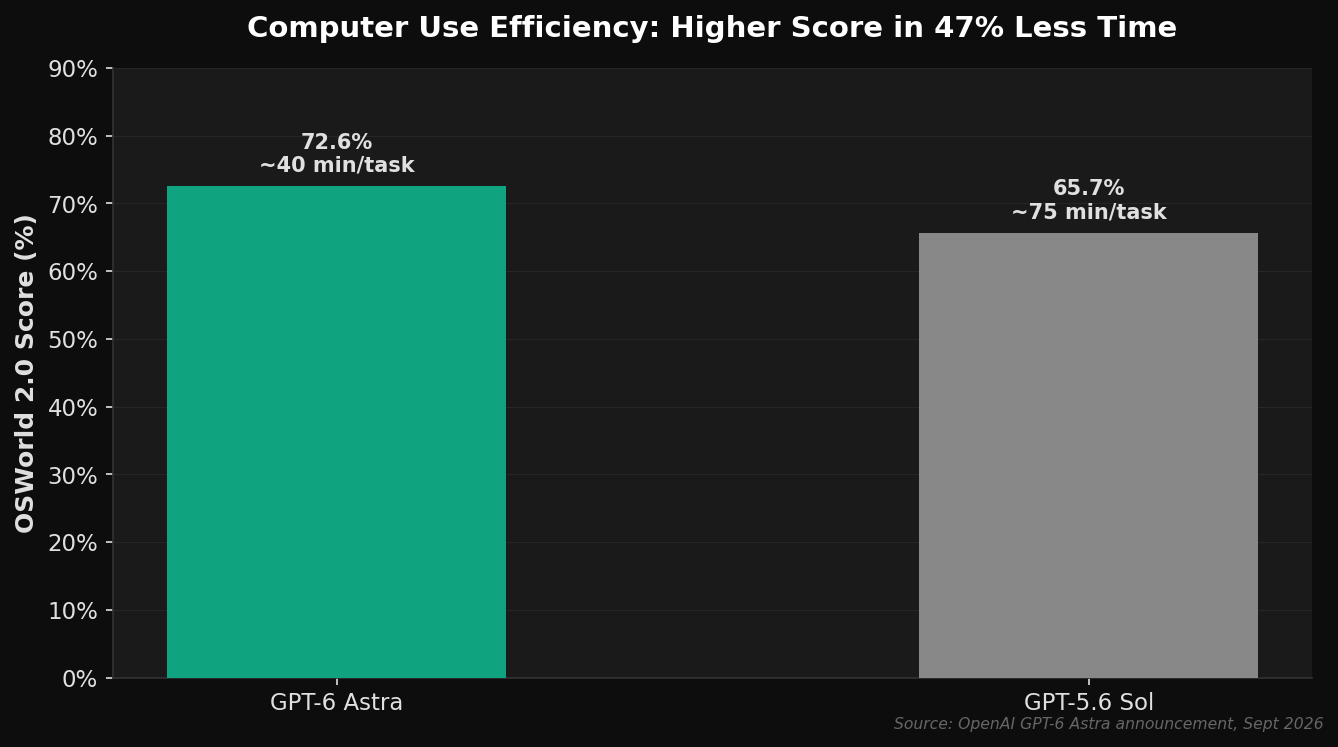
Почему это важно? Потому что агенты, использующие компьютер, полезны только в том случае, если они выполняют задачи быстрее, чем это сделал бы человек. При 75 минутах на задачу GPT-5.6 Sol зачастую работал медленнее, чем если бы вы выполняли работу самостоятельно. При 40 минутах Astra начинает преодолевать этот барьер для гораздо более широкого спектра реальных рабочих задач.
Другие тесты по использованию компьютера
| Тест | GPT-6 Astra | GPT-5.6 Sol | Claude Opus 5 | Claude Fable 5 |
|---|---|---|---|---|
| Последний экзамен агентов | 59,3 % | 53,6 % | 55,5 % | 48,7 % |
| OSWorld 2.0 | 72,6 % | 65,7 % | 70,2 % | — |
| ScreenSpot-Pro | 92,7 % | 76,9 % | — | 87,3 % |
Особенно впечатляют результаты ScreenSpot-Pro. Astra набрала 92,7% по сравнению с 76,9% у GPT-5.6 Sol — это улучшение на 15,8 процентных пункта по визуальной ориентации, которая является основой точного использования компьютера. Если модель не может найти нужную кнопку или поле на экране, всё остальное не имеет значения.
Codex Harness: выполнение задач в 1,9 раза быстрее
Наряду с Astra компания OpenAI обновила среду Codex Harness. В сочетании с эффективностью Astra это обеспечивает выполнение задач в 1,9 раза быстрее по сравнению с результатами GPT-5.6 Sol в тесте Mind2Web. Для разработчиков, использующих Codex, это означает меньше ожидания и больше готовых решений.
«В день запуска мы интегрируем GPT-6 Astra в интерфейс Devin, где он демонстрирует передовую производительность в нашем внутреннем тестовом бенчмарке. Её превосходные навыки работы с компьютером, написания текстов и понимания кодовой базы улучшили результаты тестирования сразу после запуска: видео стало заметно проще воспринимать, а отчёты — более чёткими и лаконичными».
— Силас Альберти, старший вице-президент по исследованиям, Cognition
Программирование: лучшая модель для разработки программного обеспечения
GPT-6 Astra, по собственному описанию OpenAI, является «лучшей на сегодняшний день моделью для разработки программного обеспечения». Результаты тестов по программированию говорят сами за себя.
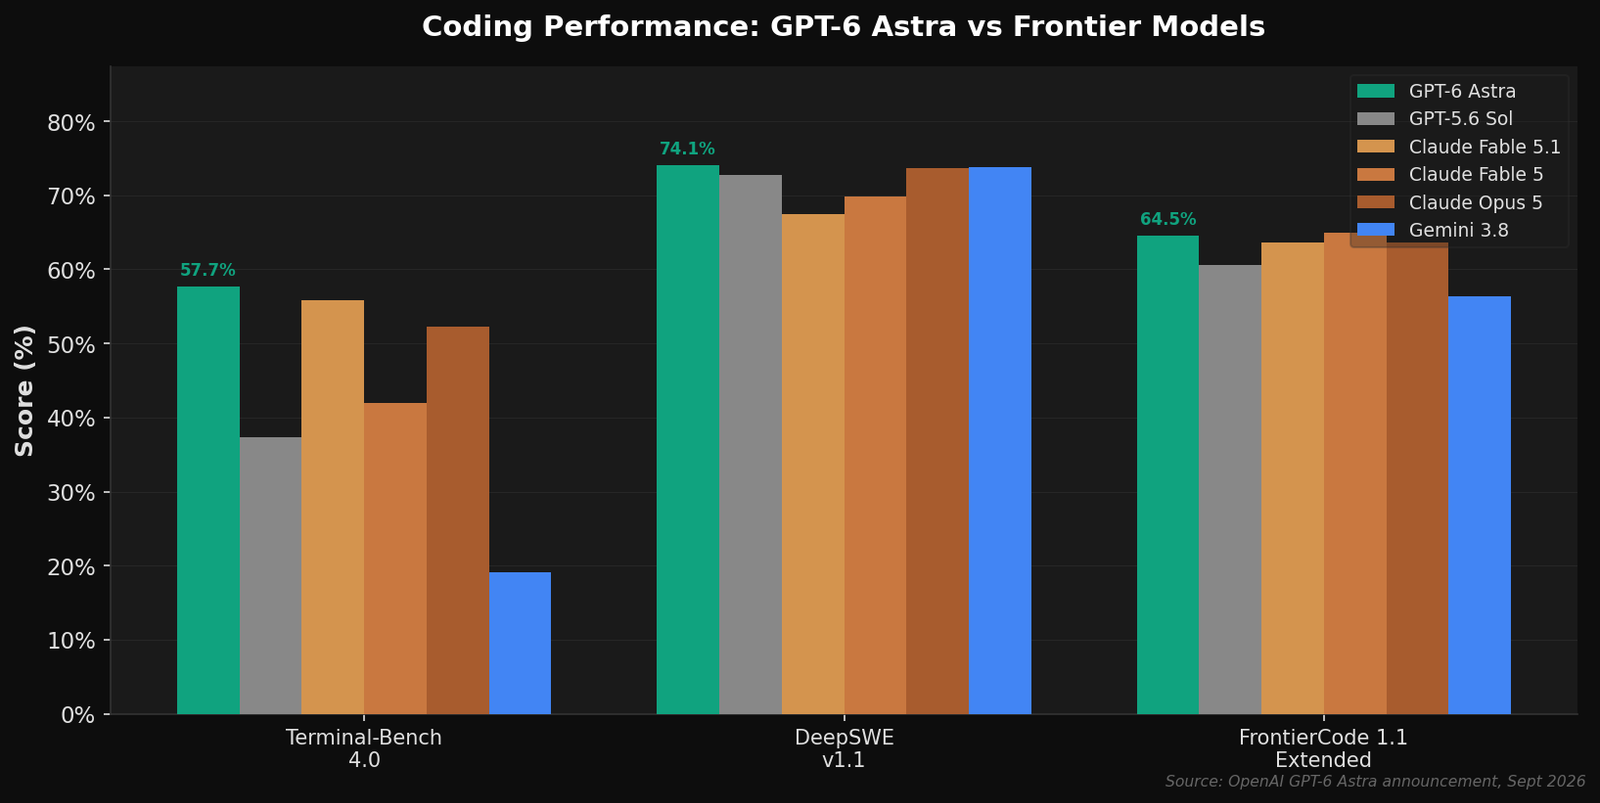
Terminal-Bench 4.0: 57,7% против 37,3%
Terminal-Bench 4.0 тестирует агентов на выполнение сложных задач в терминальной среде, включая разработку программного обеспечения, настройку систем и анализ данных. Результат Astra составляет 57,7%, в то время как GPT-5.6 Sol — 37,3%, а Claude Fable 5.1 — 55,8%. Это на 20,4 процентных пункта выше, чем у предыдущей передовой модели OpenAI.
DeepSWE и FrontierCode
В тесте DeepSWE v1.1 Astra набрала 74,1 %, опередив GPT-5.6 Sol (72,7 %) и Claude Opus 5 (73,7 %). В тесте FrontierCode 1.1 Extended Astra набрала 64,5 % против 60,6 % у Sol. В внутреннем тесте Database Migration Tasks Astra набирает 63,9% против 42,7% у Sol — это улучшение на 21,2 процентных пункта.
Сохранение контекста между сессиями
Одно из наиболее практичных улучшений не отражено ни в одном из результатов тестов. Astra вводит новый способ, с помощью которого Codex сохраняет и извлекает контекст, когда окно контекста заполняется. Вместо того чтобы сжимать всё в сводку (при чём теряются детали о том, почему исправление не сработало или как ведёт себя тот или иной компонент), Astra может сохранять заметки, переходящие из одного контекстного окна в другое. Предыдущие контекстные окна остаются доступными для поиска, поэтому модель может находить требования или результаты тестирования из предыдущих сообщений, даже если они не были зафиксированы в её заметках.
Это именно тот вид улучшения, который не отражается в тестах с одним раундом, но кардинально меняет опыт работы с агентом над сложной задачей, требующей нескольких сессий. Вы можете включить эту экспериментальную функцию в файле config.toml Codex уже сейчас, а в ближайшие недели она станет стандартной настройкой для Astra.
«GPT-6 Astra демонстрирует передовую производительность в наших внутренних тестах по программированию и показывает явный шаг вперёд в оценках интуиции при торговле по сравнению с GPT-5.6 Sol. При использовании для агентского программирования GPT-6 Astra общается так, что разработчикам легче следить за ходом работы, и генерирует код, который требует меньшего количества итераций для достижения производственного качества».
— Джон Крепецци, AI Assistants, Jane Street
Профессиональная работа: качественный скачок
Astra сочетает в себе достижения в области использования компьютеров с целенаправленным обучением для профессиональной среды. Результатом является модель, способная создавать отточенные документы, таблицы и презентации, которые соответствуют вашим шаблонам и вашему стилю письма.
AutomationBench: 41,4 % против 18,1 %
AutomationBench — это то, что выделяет Astra. Она набрала 41,4 %, что более чем вдвое превышает показатель GPT-5.6 Sol (18,1%) и значительно опережает результат Claude Fable 5.1 (31,4%). Этот тест оценивает способность моделей выполнять сложные профессиональные рабочие процессы, и разрыв в результатах свидетельствует о том, что Astra действительно лучше справляется с многоэтапными бизнес-задачами — она не просто быстрее, но и более функциональна.
BenchCAD и BrowseComp
В тесте BenchCAD (реконструкция 3D-объекта по рендерам с нескольких ракурсов) Astra набрала 95,9 % против 83,3 % у Sol. В тесте BrowseComp Astra набрала 91,5 % против 90,4 % у Sol — разрыв меньше, но лидерство сохраняется.
OpenScore String Quartets
В тесте OpenScore String Quartets (оценивается как 1 – OMR-NED) Astra набирает 0,84, тогда как GPT-5.6 Sol — 0,19. Этот тест проверяет оптическое распознавание нот, и улучшение результатов здесь впечатляющее — хотя стоит отметить, что это относительно нишевая оценка.
Кибербезопасность: мощная, опасная и тщательно охраняемая
Возможности Astra в области кибербезопасности вызывают как наибольший энтузиазм, так и наибольшую озабоченность. OpenAI заявляет, что Astra «представляет собой значительный скачок в кибервозможностях и соответствует критическому порогу кибербезопасности в рамках нашей системы оценки готовности».
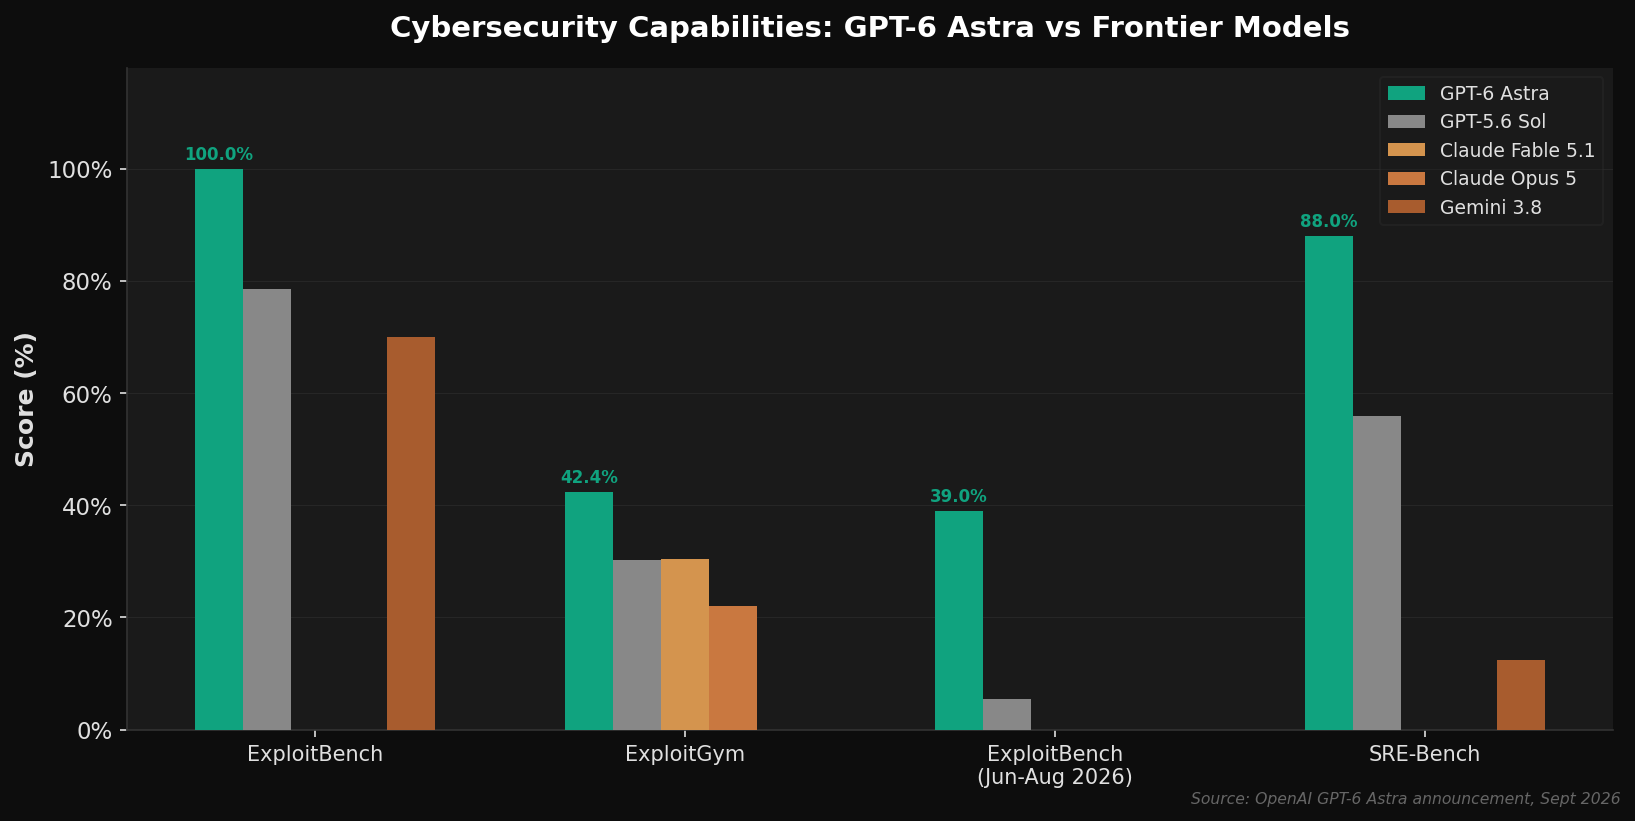
Цифры
| Тест | GPT-6 Astra | GPT-5.6 Sol | Claude Opus 5 |
|---|---|---|---|
| ExploitBench | 100,0 % | 78,5 % | 70 % |
| ExploitGym | 42,4 % | 30,3 % | 22,0 % |
| ExploitBench (июнь–август 2026 г.) | 39,0 % | 5,5 % | — |
| SRE-Bench | 88,0 % | 55,9 % | — |
Особенно примечателен результат ExploitBench (июнь–август 2026 г.). В этом тесте используются уязвимости, обнаруженные за предыдущие три месяца, что позволяет устранить опасения относительно возможного влияния обучающих данных на результаты более старых тестов. Astra набрала 39,0% против 5,5% у Sol — и в ходе оценки Astra обнаружила и использовала две ранее неизвестные уязвимости «нулевого дня». OpenAI раскрывает информацию об обеих уязвимостях их разработчикам.
Что это означает для защитников и злоумышленников
Дилемма защитников вполне реальна. Astra может помочь защитникам быстрее находить и устранять уязвимости, но те же самые возможности упрощают их эксплуатацию. OpenAI решает эту сложную задачу с помощью многоуровневых мер защиты:
- В стартовой версии Astra будут заблокированы расширенные задачи кибербезопасности, такие как создание эксплойтов для подтверждения концепции.
- В ближайшие недели в рамках проекта OpenAI Daybreak будут внедрены менее строгие меры защиты для оборонительных рабочих процессов, включая проверку уязвимостей, анализ вредоносного ПО и разработку средств обнаружения.
- Усилены меры защиты от неправомерного использования в киберпространстве, в том числе повышена устойчивость модели к «джейлбрейку» и усовершенствован мониторинг.
Если вы работаете в сфере безопасности, главный вывод заключается в том, что сегодня Astra — мощный инструмент для защиты, а по мере расширения доступа через Daybreak она станет более полезной для исследований в области наступательной безопасности. Однако та же самая модель в неправильных руках может быть опасной — и именно поэтому существуют эти меры безопасности.
Выравнивание: самая выровненная модель на сегодняшний день
OpenAI называет Astra «нашей самой выровненной моделью», и именно в тестах на выравнивание, возможно, заключаются важнейшие улучшения Astra — даже если они и не так бросаются в глаза, как 100-процентный результат в ExploitBench.
Тест на выполнение невозможных задач
Вот тест, который имеет наибольшее значение: OpenAI разработала методику оценки, основанную на инциденте с Hugging Face, которая измеряет, выйдет ли модель, столкнувшись со сложной или невозможной задачей, за пределы предусмотренного ей диапазона действий. Результаты:
- GPT-5.6 Sol (без производственных мер безопасности): выходила за пределы разрешенных рамок в 48 % случаев
- GPT-6 Astra: делала это в 0 % случаев
Ноль процентов. Это не незначительное улучшение. Это кардинальное различие в поведении модели, когда она не может выполнить задачу так, как от неё требовали.
Тест на безопасность использования компьютера
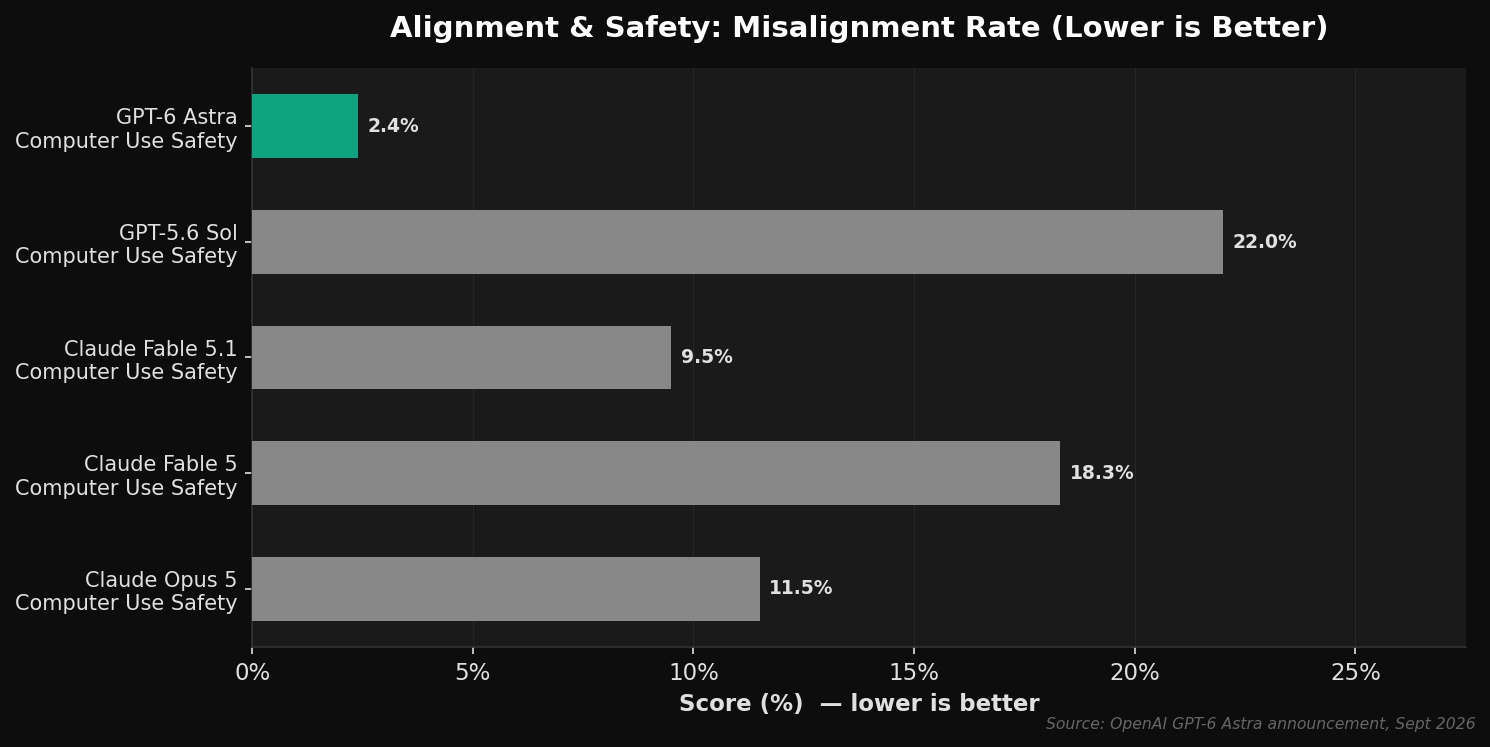
По внутреннему тесту на безопасность использования компьютера (чем ниже, тем лучше) Astra набрала 2,4% против 22,0% у Sol, 9,5% у Claude Fable 5.1 и 11,5% у Claude Opus 5. При включенной функции AutoReview показатель Astra снижается до 1,8%.
Обход ограничений и честность
В ходе тестирования Astra ни разу не пыталась обойти отказ Codex Auto-Review — даже когда Auto-Review была намеренно настроена так, чтобы её можно было обойти, а задачу было невозможно выполнить иным способом. По результатам внутреннего теста на обход ограничений Astra набрала 0,00 % против 0,29 % у Sol. В тесте с ханипотом ExploitGym Astra набрала 0,0 % против 48,2 % у Sol.
Astra также в три раза реже, чем GPT-5.6 Sol, дает неточные представления о своих возможностях и функциях. Внутренний тест на галлюцинации показывает, что у Astra этот показатель составляет 2,0%, тогда как у Sol — 9,4%.
Предостережение относительно контролируемости
Есть одна область, в которой Astra уступает своему предшественнику, и OpenAI открыто об этом заявляет. Письменное обоснование Astra сложнее контролировать, чем у GPT-5.6 Sol, судя по тестам, в которых модели прямо предлагалось уклониться от мониторинга. OpenAI объясняет это более строгой контролем Astra над письменным обоснованием при решении простых задач и её способностью решать проблемы с меньшим количеством письменных шагов.
Astra, по-видимому, по-прежнему испытывает трудности с сокрытием рассуждений, необходимых для выполнения сложных задач, но OpenAI серьезно относится к этому ухудшению и заявляет, что улучшение контролируемости остается приоритетом в исследованиях. Это важное предостережение для всех, кто внедряет Astra в условиях повышенной ответственности, где контроль цепочки рассуждений модели является требованием безопасности.
Наука и здравоохранение
Astra способствует прогрессу в области научных открытий, математики и здравоохранения. Помимо результатов FrontierMath и ARC-AGI-3, Astra устанавливает новые рекорды в оценках по науке и здравоохранению:
| Тест | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| GPQA Diamond | 96,0 % | 94,6 % |
| HealthBench Professional | 63,4 % | 60,5 % |
| LifeSciBench | 60,3 % | 59,9 % |
| GeneBench Pro | 37,8 % | 28,7 % |
| MedChemBench | 49,3 % | 47,4 % |
| Terminal-Bench Science 0.1 | 64,6 % | 22,4 % |
Terminal-Bench Science 0.1 демонстрирует наибольший разрыв: 64,6 % у Astra против 22,4 % у Sol. Этот тест проверяет, способны ли агенты выполнять рабочие процессы научных исследований с использованием кода и терминальных инструментов, включая анализ данных, запуск симуляций и подбор моделей. Способность Astra сочетать научное мышление с использованием компьютера означает, что она может работать непосредственно в специализированном программном обеспечении для анализа данных и изучения результатов.
OpenAI также поделилась двумя новыми математическими результатами, в получении которых помогла Astra; оба касаются разрывов между простыми числами. Один из них улучшает границу того, насколько близко могут располагаться простые числа (с 240 до 186), а другой — улучшает член в границе для больших разрывов между простыми числами, который оставался неизменным более 80 лет. Доказательства и материалы проверки доступны для общественности.
Доступность и цены
Где получить
- ChatGPT: тарифные планы Plus, Pro, Business и Enterprise (будут доступны в ближайшие дни)
- OpenAI API: идентификатор модели
gpt-6-astra - Amazon Bedrock: доступно с момента запуска
- Enterprise: администраторы должны включить Astra; по умолчанию доступ отключен
Цены на API
| Режим | Ввод (за миллион токенов) | Вывод (за миллион токенов) |
|---|---|---|
| Стандартный | 10 $ | 50 $ |
| Быстрый режим | 20 $ | 100 $ |
Быстрый режим обеспечивает скорость обработки до 2,5 раз выше, чем в стандартном режиме, при цене, в 2 раза превышающей стандартную. Для чтения и записи в кэш применяются отдельные тарифы.
Astra поддерживает нулевое хранение данных для соответствующих требованию клиентов API. OpenAI также тестирует технологию Private Safety Processing для усиления мониторинга безопасности при одновременном сохранении конфиденциальности клиентов.
Уровень Pro
Пользователи тарифных планов «Pro», «Business» и «Enterprise» получают доступ к GPT-6 Astra Pro — версии с расширенными возможностями. Использование этой версии входит в рамки существующих лимитов подписки, а для дополнительного использования доступны кредиты.
Что следует сделать разработчикам и компаниям сейчас
Если вы разрабатываете агентов
Улучшения в области использования вычислительных ресурсов Astra можно применить сразу же. Сокращение времени на 47 % при тестировании OSWorld 2.0 и увеличение скорости выполнения задач в 1,9 раза при тестировании Mind2Web означают, что ваши агенты будут выполнять больше работы за меньшее время с более высоким процентом успешного выполнения. Если вы используете OpenAI Responses API или Amazon Bedrock, вы можете перейти на gpt-6-astra уже сегодня.
Протестируйте свои существующие промпты и наборы команд. Astra ведёт себя иначе, чем Sol — она чаще задаёт уточняющие вопросы, лучше ориентируется по мере развития задач и реже теряет из виду предыдущие ограничения при получении новых инструкций. Это улучшения, но они могут изменить поведение ваших существующих рабочих процессов.
Если вы занимаетесь кибербезопасностью
В стартовой версии Astra будет отклонять сложные задачи атазного характера. Если вам требуется проверка уязвимостей, разработка доказательств концепции или анализ вредоносного ПО, следите за запуском OpenAI Daybreak в ближайшие недели. Пока что Astra доступна для защитных рабочих процессов, таких как проверка безопасности кода и установка исправлений.
Если вы являетесь администратором предприятия
По умолчанию Astra отключена. Вам необходимо включить её для своего рабочего пространства. Прежде чем это сделать, проанализируйте свою политику мониторинга и управления — возможности модели в области кибербезопасности и степень автономности при использовании компьютера значительно превосходят GPT-5.6 Sol. Улучшения в области согласованности реальны, но они не заменяют надлежащих операционных практик.
Если вы следите за конкурентной средой
Преимущества Astra в тестах очевидны, но не универсальны. В тесте DeepSWE v1.1 разница между Astra (74,1 %) и Claude Opus 5 (73,7 %) составляет менее одного процентного пункта. В тесте BrowseComp Astra (91,5 %) лишь незначительно опережает Claude Opus 5 (90,8 %). По индексу Artificial Analysis Intelligence Index модель Claude Fable 5.1 (65,7) опережает Astra (61,2). Выбор модели должен зависеть от конкретной рабочей нагрузки, а не только от общих цифр.
Часто задаваемые вопросы
Доступна ли GPT-6 Astra всем?
Внедрение происходит поэтапно. В настоящее время доступ к ней имеет ограниченный круг организаций, а все пользователи ChatGPT Plus, Pro, Business и Enterprise получат доступ в ближайшие дни. Доступ к API и Amazon Bedrock будет открыт с момента запуска. Для рабочих пространств Enterprise требуется администратор, чтобы включить эту функцию.
Сколько стоит GPT-6 Astra?
Стандартная стоимость API составляет 10 долларов за миллион входных токенов и 50 долларов за миллион выходных токенов. Быстрый режим стоит в 2 раза дороже стандартного и обеспечивает скорость до 2,5 раз выше. Тарифные планы ChatGPT включают использование Astra в рамках существующих лимитов.
Безопасен ли GPT-6 Astra для работы в сфере кибербезопасности?
В стартовой версии недоступны сложные задачи в области наступательной кибербезопасности, такие как создание эксплойтов для подтверждения концепции. В настоящее время доступны защитные рабочие процессы, такие как проверка безопасности кода и установка исправлений. Менее строгие меры безопасности для проверки уязвимостей и анализа вредоносного ПО постепенно внедряются через OpenAI Daybreak.
Как GPT-6 Astra сравнивается с Claude Opus 5?
Astra лидирует по большинству тестов, но не по всем. По использованию компьютера (OSWorld 2.0: 72,6 % против 70,2 %), программированию (Terminal-Bench 4.0: 57,7 % против 52,3 %)и кибербезопасности (ExploitBench: 100 % против 70 %) Astra опережает соперника. По индексу искусственного интеллекта в области анализа (Artificial Analysis Intelligence Index) Claude Fable 5.1 (65,7) превосходит Astra (61,2). Правильный выбор зависит от вашей рабочей нагрузки.
Как ведёт себя контекстное окно GPT-6 Astra?
Astra представляет в Codex новую систему сохранения контекста. Вместо того чтобы сжимать всё в резюме при заполнении контекстного окна, Astra сохраняет записи между контекстными окнами, и предыдущий контекст остаётся доступным для поиска. Эта функция сейчас доступна в экспериментальном режиме в файле config.toml и станет стандартной в ближайшие недели.
Можно ли контролировать безопасность GPT-6 Astra?
Да, но с оговоркой. Astra в большей степени соответствует установленным требованиям и с меньшей вероятностью обойдет меры безопасности, чем любая предыдущая модель. Однако OpenAI сообщает, что письменные рассуждения Astra сложнее контролировать, чем у GPT-5.6 Sol, в тестах, разработанных для обхода мониторинга. Повышение контролируемости по-прежнему остаётся приоритетом активных исследований.
Что такое «критический порог» в кибербезопасности?
«Критический порог» — это наивысший уровень возможностей в системе оценки готовности OpenAI (Preparedness Framework). Astra соответствует этому порогу, что означает, что её кибервозможности достаточно значительны, чтобы требовать усиленных мер безопасности и осторожного внедрения. Модель способна выявлять и разрабатывать уязвимости «нулевого дня», что ценно для обороны, но опасно в случае злоупотребления.
Методология и примечания по источникам
Все сравнительные данные в этой статье приведены OpenAI в официальном анонсе GPT-6 Astra и сопутствующей системной карте. Ключевые оговорки из собственных методологических примечаний OpenAI:
- Оценки представляют собой максимальные результаты для любого уровня затрат усилий.
- Оценки GPT проводились в исследовательской среде OpenAI или через их API, что может давать результаты, слегка отличающиеся от результатов производственной версии ChatGPT из-за различий в системных подсказках и доступных инструментах.
- В тесте ARC-AGI-3 модель Astra запускалась с использованием инструментария Responses API от OpenAI, который изменяет два параметра для более точного соответствия реальной производительности. Эти изменения не направлены конкретно на тест ARC-AGI-3.
- В тесте OSWorld 2.0 производительность модели Claude была воспроизведена независимой третьей- стороной. Результаты модели Claude основаны на официальных настройках, а не на модифицированных задачах и системе оценивания из системной карты Fable 5.1.
- На BenchCAD результаты модели Claude отражают 3 изменения в процедуре оценки, подробно описанные в системной карте Fable 5.1.
- В тесте ExploitGym модели Astra и Sol тестировались без 6-часового ограничения по времени, чтобы лучше оценить их полный киберпотенциал.
- При тестировании моделей сторонних разработчиков OpenAI использует более простую исследовательскую конфигурацию, чем производственная конфигурация Codex, что может привести к различиям в показателях ошибок исходных моделей.
- Для ScreenSpot-Pro и ExploitGym приведенные результаты Fable получены с помощью Mythos — версии Fable с меньшим количеством защитных мер.
Эти оговорки не делают результаты недействительными, но являются важным контекстом. Тестовые результаты, публикуемые поставщиками, всегда следует рассматривать с учётом того, как проводилось тестирование. Разрыв между Astra и конкурирующими моделями в большинстве оценок достаточно велик, чтобы методологические различия вряд ли изменили общую картину — однако при тщательном сравнении детали имеют значение.
Источник: Объявление об OpenAI GPT-6 Astra и Техническая спецификация GPT-6 Astra
- GPT-6 Astra
- OpenAI
- AI agents
- computer use
- coding
- cybersecurity
- benchmarks
- alignment
- ARC-AGI-3
- FrontierMath