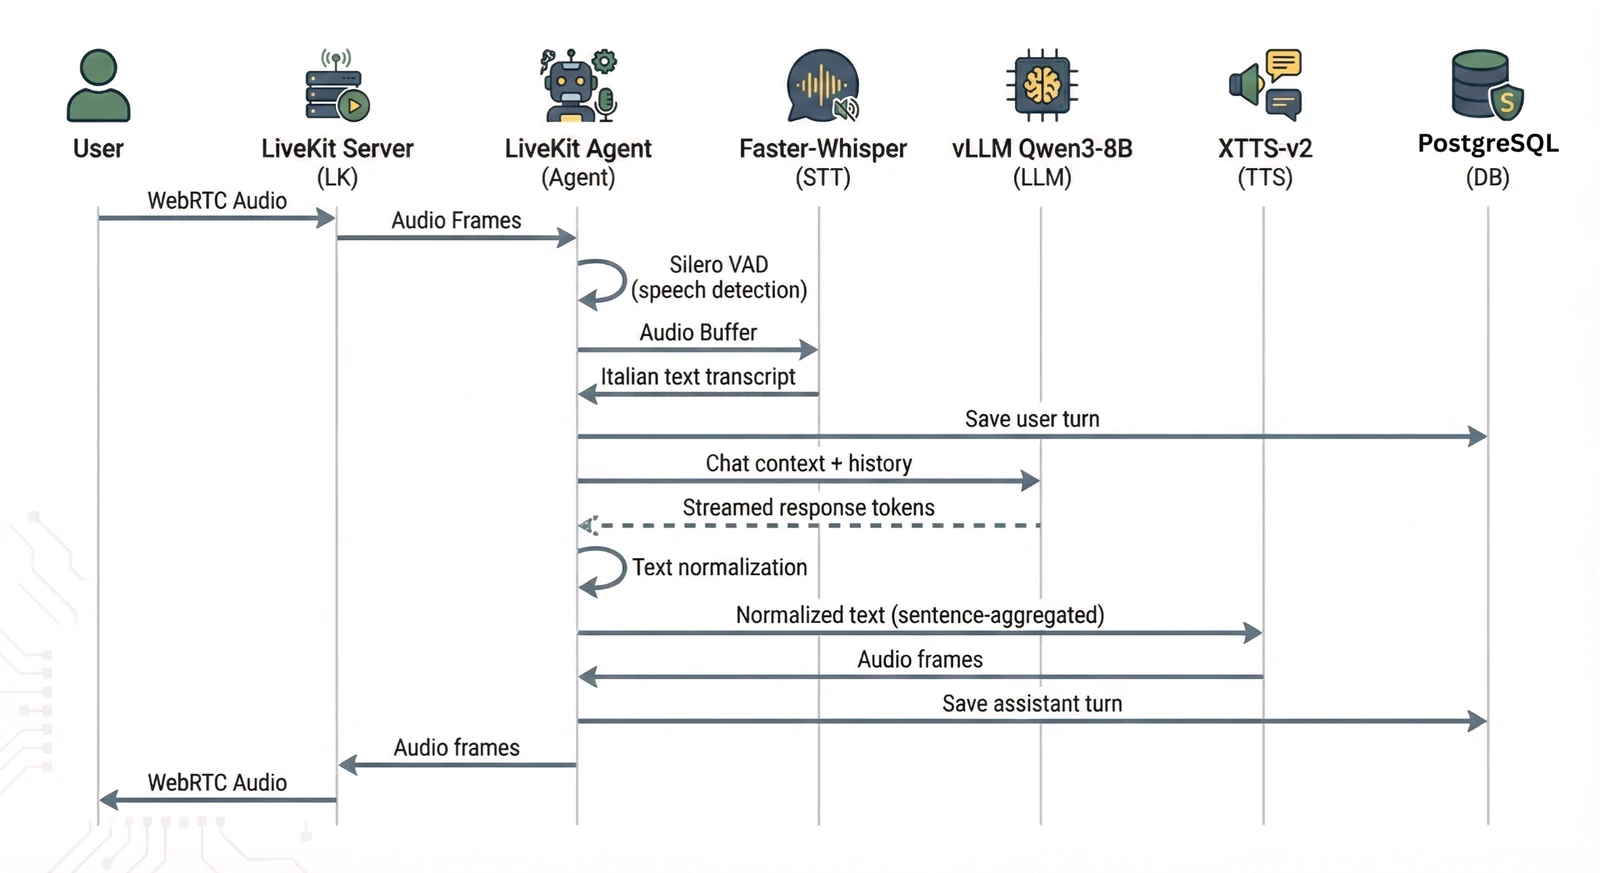
Bij managed voice-AI wordt per minuut gefactureerd, dus een agent die goed presteert, zorgt voor een hogere factuur. Door Vocale zo te ontwikkelen dat het zowel op een gehoste API als op een eigen GPU kan draaien, hebben we vier dingen geleerd over wat er daadwerkelijk lastig wordt wanneer de modellen intern worden ingezet.
Ontdek hoe u een AI-automatiseringsbureau kiest dat workflows kan controleren, systemen kan integreren, storingen kan oplossen en meetbare productieresultaten kan opleveren.
Een praktische gids voor AI-automatisering in het bedrijfsleven: ontdek waardevolle werkprocessen, verminder repetitief werk, zorg voor menselijk toezicht en meet de ROI op een veilige manier.
Ontdek wat diensten voor de ontwikkeling van AI-agenten moeten bieden, van RAG en toolintegraties tot evaluaties, machtigingen, goedkeuringen door mensen en onderhoud.
Bangladesh's best AI teams in 2026 ship agentic systems, RAG pipelines, and local LLMs with measured metrics. Here is how to identify the right AI team for your build.
Choosing an AI expert in Dhaka in 2026 means deciding between solo engineers and full teams. Compare rates, tech stacks, and the 6 questions that reveal real depth.
Building a RAG system in Dhaka in 2026 costs $8K-$25K with retrieval under 1s. Compare pgvector vs Pinecone, Llama 3 vs GPT-4, and the 5-step production process.
Bangladesh's AI solution providers in 2026 ship agentic systems, custom SaaS, and local LLMs with measured metrics. Compare the top 8, pricing, and the 8-step buyer process.