AI7 min leestijdDoor JH Akash
Mistral Voxtral 3 Uitgelegd: Voice Agent Stack versus ElevenLabs Realtime
Mistral leverde Voxtral 3 uit op 20 oktober 2026: 50+ transcriptietalen, een real-time voice agent SDK op LiveKit en TTS vanaf $13 per miljoen tekens. Op dezelfde dag bracht ElevenLabs Eleven Realtime uit, twee spraak-naar-spraak modellen met een responstijd van 0,57 seconden. Volledige uitsplitsing binnenin.
Mistral Voxtral 3 Uitgelegd: Full Voice Agent Stack versus ElevenLabs Realtime
Voice AI had een drukke dinsdag. Op 20 oktober 2026 bracht Mistral Voxtral 3 uit, een volledige voice agent-stack met drie transcriptielagen, een tekst-naar-spraakmodel en een real-time voice agent SDK. Diezelfde middag bracht ElevenLabs Eleven Realtime uit, twee spraak-naar-spraak modellen gebouwd voor live AI-gesprekken.
Twee labs, twee heel verschillende architecturen, één doel: AI die een echt telefoongesprek kan voeren. Hier is wat elk lab doet, wat elk kost, en hoe je tussen die labs kunt kiezen.
Snel oordeel
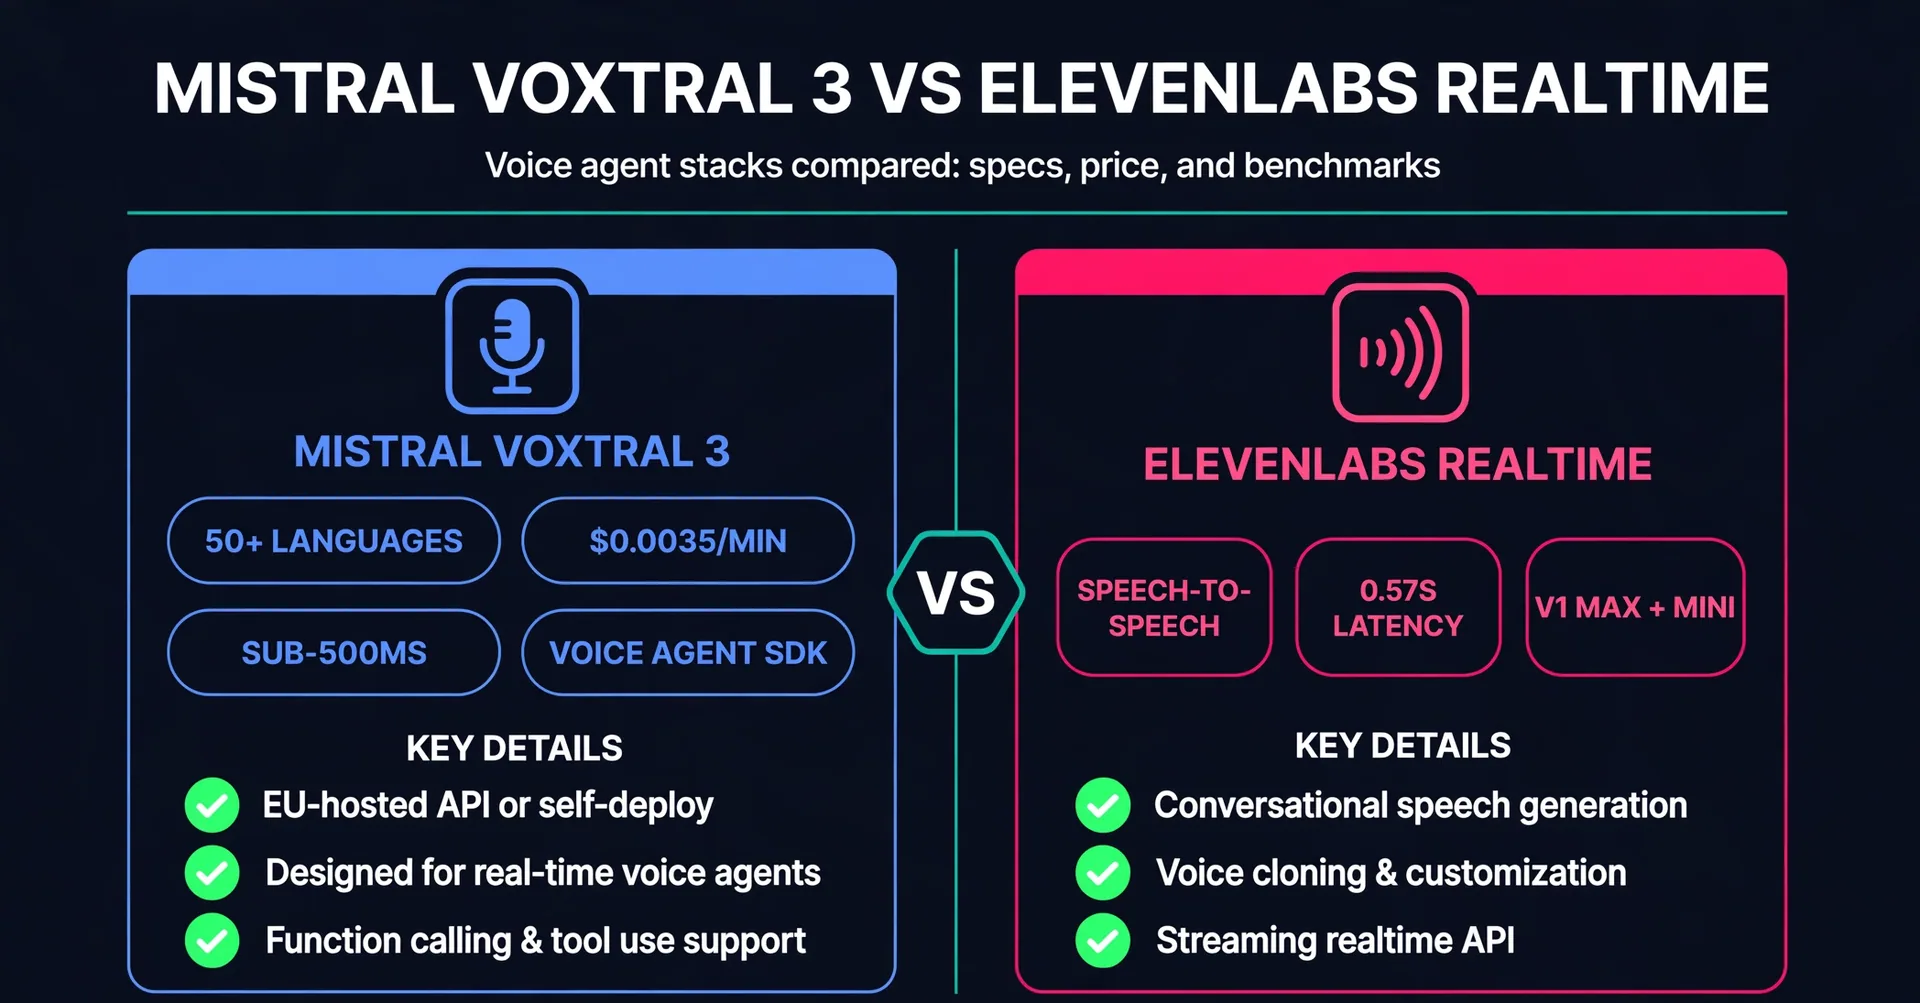
| Mistral Voxtral 3 | ElevenLabs Eleven Realtime | |
|---|---|---|
| Architectuur | Modulair: STT + LLM + TTS pijplijn met SDK | Van begin tot eind toespraak |
| Transcriptietalen | 50+ talen | Niet afzonderlijk gespecificeerd |
| TTS-talen | 35+ talen, 50+ dialecten | 90+ talen (Elf v4 familie) |
| Draailatentie | Minder dan 1 seconde per beurt, realtime transcriptie onder de 500ms | Ongeveer 0,57s respons (v1 Max) |
| Transcriptieprijs | Vanaf $0,0035/min | Niet gepubliceerd als vast tarief |
| TTS-prijs | $13 per 1 miljoen personages | Van $40/M karakters (Flash/Turbo, oktober 2026 prijs) |
| Stemklonen | Van 30+ minuten audio (Pro Voice) | Instant kloon vanaf 10 seconden (Eleven v4) |
| Inzet | EU-gehoste API of zelf-gehost | ElevenLabs cloud, OpenAI-compatibele API |
| Het beste voor | Gereguleerde sectoren, meertalige transcriptie, budget-stemagenten | Natuurlijke stemagenten en supportbots die op natuurlijkheid gericht zijn |
Kortom: kies Voxtral 3 wanneer dataresidentie, meertalige dekking of de kosten per minuut de beslissing bepalen. Kies Eleven Realtime wanneer de stem zelf foutloos moet klinken. Lees verder voor de volledige cijfers.
Wat Mistral Voxtral 3 eigenlijk bevat
Voxtral 3 is niet één model. Het is een familie van spraakmodellen plus een voice agent SDK die ze aan elkaar koppelt. Elk onderdeel is vandaag beschikbaar via de API van Mistral, gehost in de EU, of geïmplementeerd op je eigen infrastructuur.
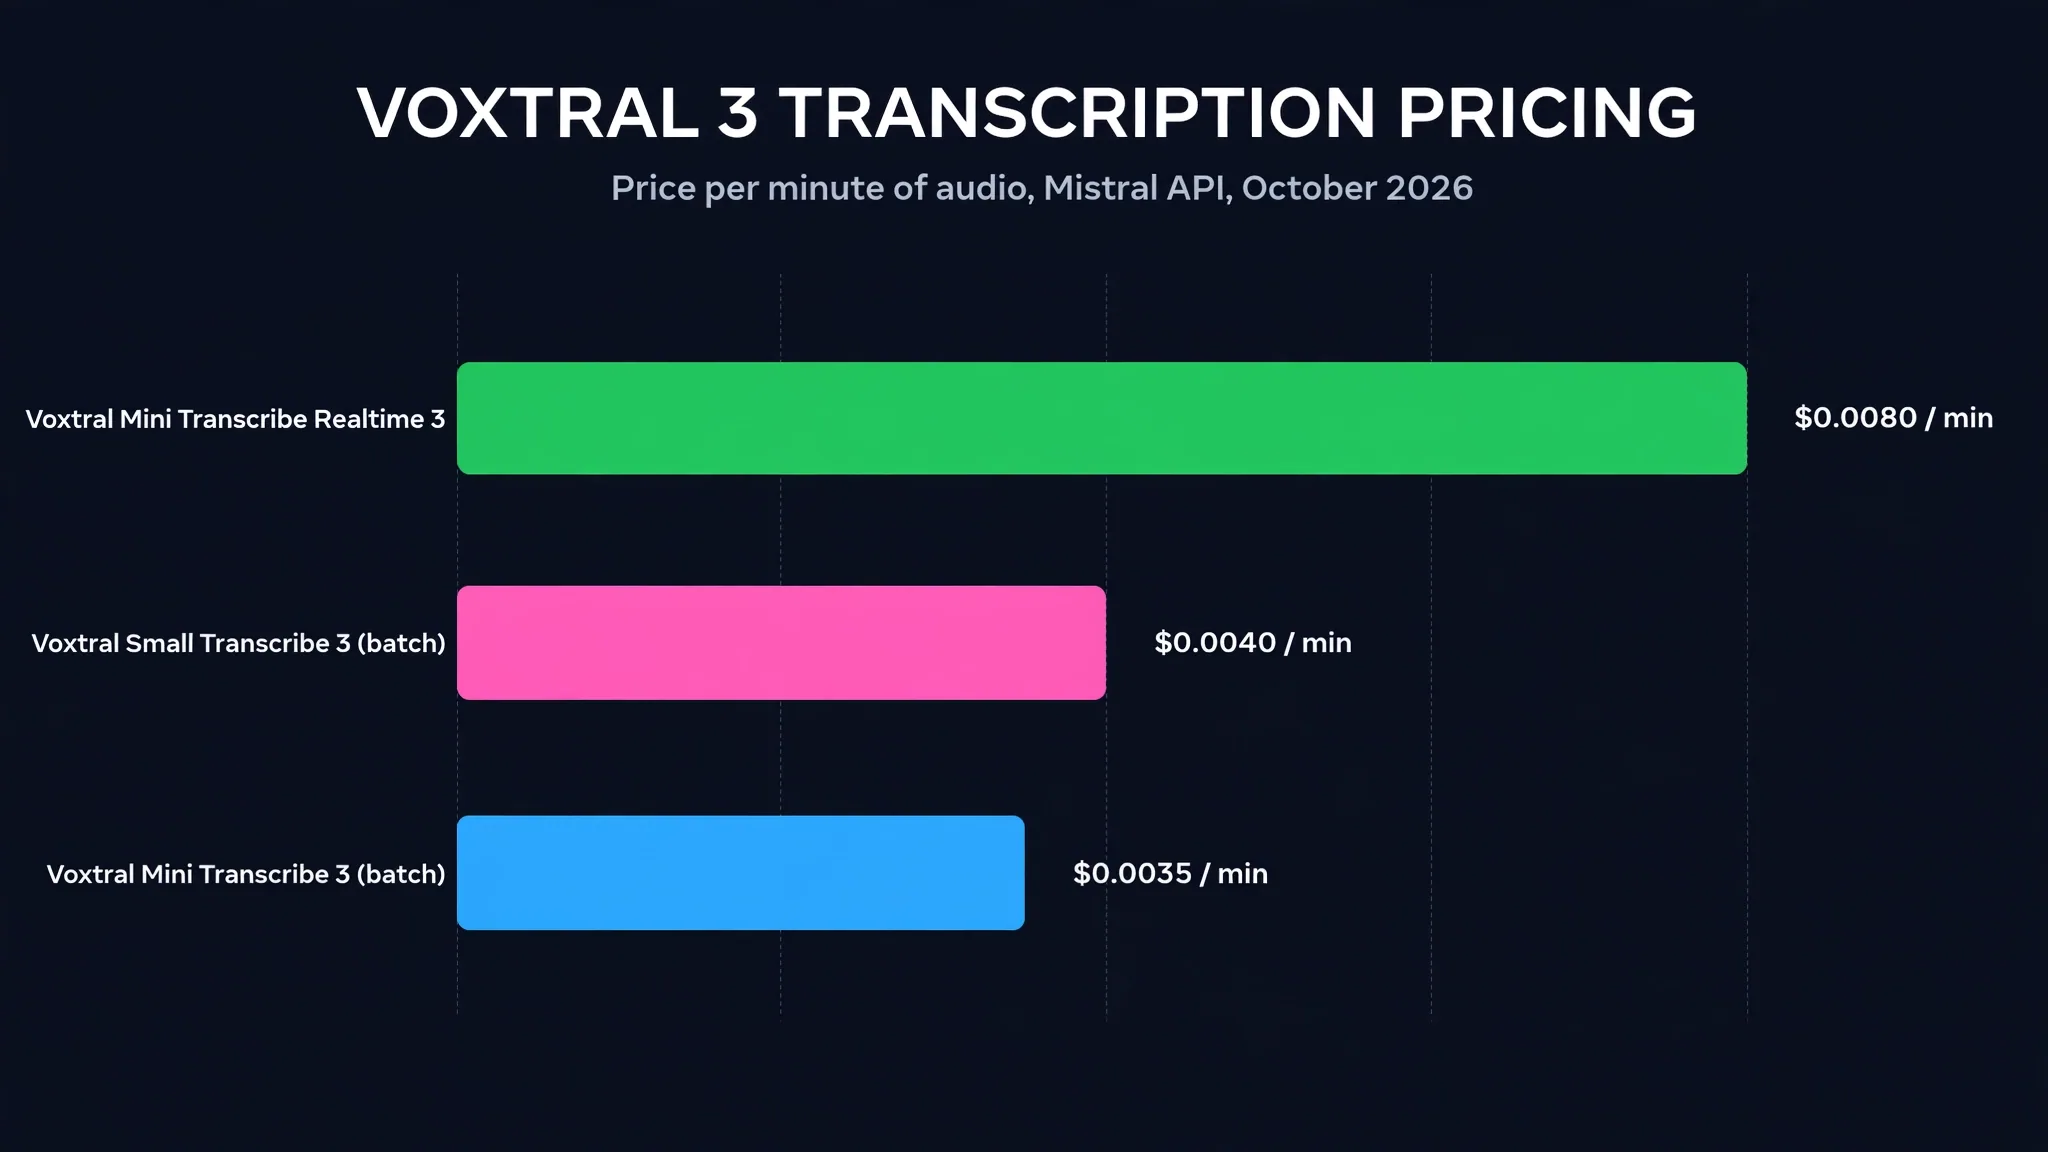
Voxtral Mini Transcribe 3: $0,0035 per minuut
De budgettranscriptie-niveau. Een spraak-naar-tekst model met 4 miljard parameters, gebouwd voor batchwerklasten, geprijsd op $0,0035 per minuut audio. Beide batchmodellen accepteren sleuteltermen en extra contexttekst, zodat domeinvocabulaire wordt herkend zonder fijn afstemming.
Voxtral Small Transcribe 3: $0,004 per minuut
Het vlaggenschip-transcriptiemodel: 50+ talen, waaronder alle 24 officiële EU-talen, plus Aziatische en Indische talen met minder bronnen. Het voegt spreker-diarisatie, einde-van-beurt detectie (het weet wanneer de beller stopte met praten) en contextbiasing voor gespecialiseerde termen. Mistral zegt dat het Whisper, Scribe v2 en Gemini 3.5 Transcribe verslaat op hun eigen meertalige tests. Meer over die cijfers hieronder.
Voxtral Mini Transcribe Realtime 3: $0,008 per minuut
De agentgerichte laag: 35+ talen met transcriptielatentie onder de 500 milliseconden, inclusief sprekeridentificatie en woordenschatgebruik. Dit is het model dat de voice agent SDK voedt.
Voxtral Speech 3: $13 per 1 miljoen tekens
Het tekst-naar-spraakmodel omvat 35+ talen en 50+ dialecten, waarbij emotie, tempo en nadruk als instructievariabelen kunnen worden insteld. Spraakpresets worden geleverd in 18 talen, van Arabisch en Hindi tot Vietnamees. Spraakklonen vereist 30 minuten of meer audio, en een Pro Voice-optie past het karakter en het emotionele bereik van een spreker over talen aan vanaf ongeveer 30 minuten opnames. Dezelfde prijs van $13 voor batch- en realtime gebruik via één API. Mistral positioneert het als goedkoper dan OpenAI TTS-1, Deepgram, ElevenLabs Flash en Gemini Flash.
De voice agent SDK: LiveKit, minder dan één seconde per beurt
Het hoofdstuk is de SDK, gebouwd op LiveKit. Voxtral Mini Transcribe Realtime 3 luistert, een algemeen model zoals Mistral Small redeneert en roept tools, en Voxtral Speech 3 reageert in de toon van het gesprek. Geen enkel podium wacht op het voorgaande, dus Mistral zegt dat elke beurt binnen één seconde voltooid is en de agent stopt met praten wanneer de beller tussenbeide komt.
Tijdens een gesprek kan de agent de identiteit van een beller verifiëren, een rekening controleren of een afspraak boeken, met behulp van functiebellen, webzoeken en ophalen via je eigen systemen. Het beantwoordt en plaatst oproepen via SIP, draait in browsers en apps via WebRTC, en sluit aan op telefonie-, IVR- en contactcentersoftware. Elke fase is een apart model, zodat je de LLM, de spraak of de taal kunt wisselen zonder de agent te herschrijven.
Deployment is de soevereiniteitspitch: run de stack op Mistral's EU API of op je eigen infrastructuur, met controle over waar gesprekken worden verwerkt en of audio wordt behouden. Let op dat de aankondiging geen downloadbare open weights koppelt; zelfhosting wordt aangeboden via Mistrals eigen deploymentkanaal.
Wat ElevenLabs heeft uitgebracht: Eleven Realtime v1 Max en v1 Mini
ElevenLabs ging end-to-end in plaats van modulair. Twee spraak-naar-spraakmodellen, uitgebracht op dezelfde dag:
- Eleven Realtime v1 Max: de nauwkeurigheidsstrategie. ElevenLabs rapporteert 98,8% op de Big Bench Audio benchmark met ongeveer 0,57 seconden responstijd, en zegt dat geen enkel model op de Artificial Analysis speech-to-speech leaderboard momenteel zowel sneller als nauwkeuriger is. Gericht op veeleisende taken zoals klantenservicebots.
- Eleven Realtime v1 Mini: de kost voor natuurlijke, alledaagse gesprekken. Het kan aangeven wanneer een spreker klaar is versus wanneer hij alleen "mm-hmm" zegt, wat veel uitmaakt voor natuurlijke beurten.
Beide werken via het ElevenAgents-platform en een OpenAI-compatibele Realtime API, zodat bestaande OpenAI voice-agentcode naar ElevenLabs-eindpunten kan wijzen. De prijs is per minuut audio plus tokengebruik, waarbij Max hoger is dan Mini; ElevenLabs heeft geen vast aantal per minuut gepubliceerd zoals Mistral dat wel heeft gedaan. Onafhankelijke benchmarks buiten de eigen beweringen van het bedrijf zijn nog niet gepubliceerd.
Benchmarks: wie transcribeert beter
Mistral publiceerde cijfers voor woordfouten op de FLEURS-benchmark over 45 talen, met afgeleide taal. Voxtral Small Transcribe 3 behaalt 4,0%, gelijk met Microsoft AI Transcribe 2 in Mistrals eigen cijfers, voor Gemini 3.5 Transcribe met 4,5%, Scribe v2 met 4,9%, GPT Transcribe met 5,6% en Whisper large-v3 met 14,9%.
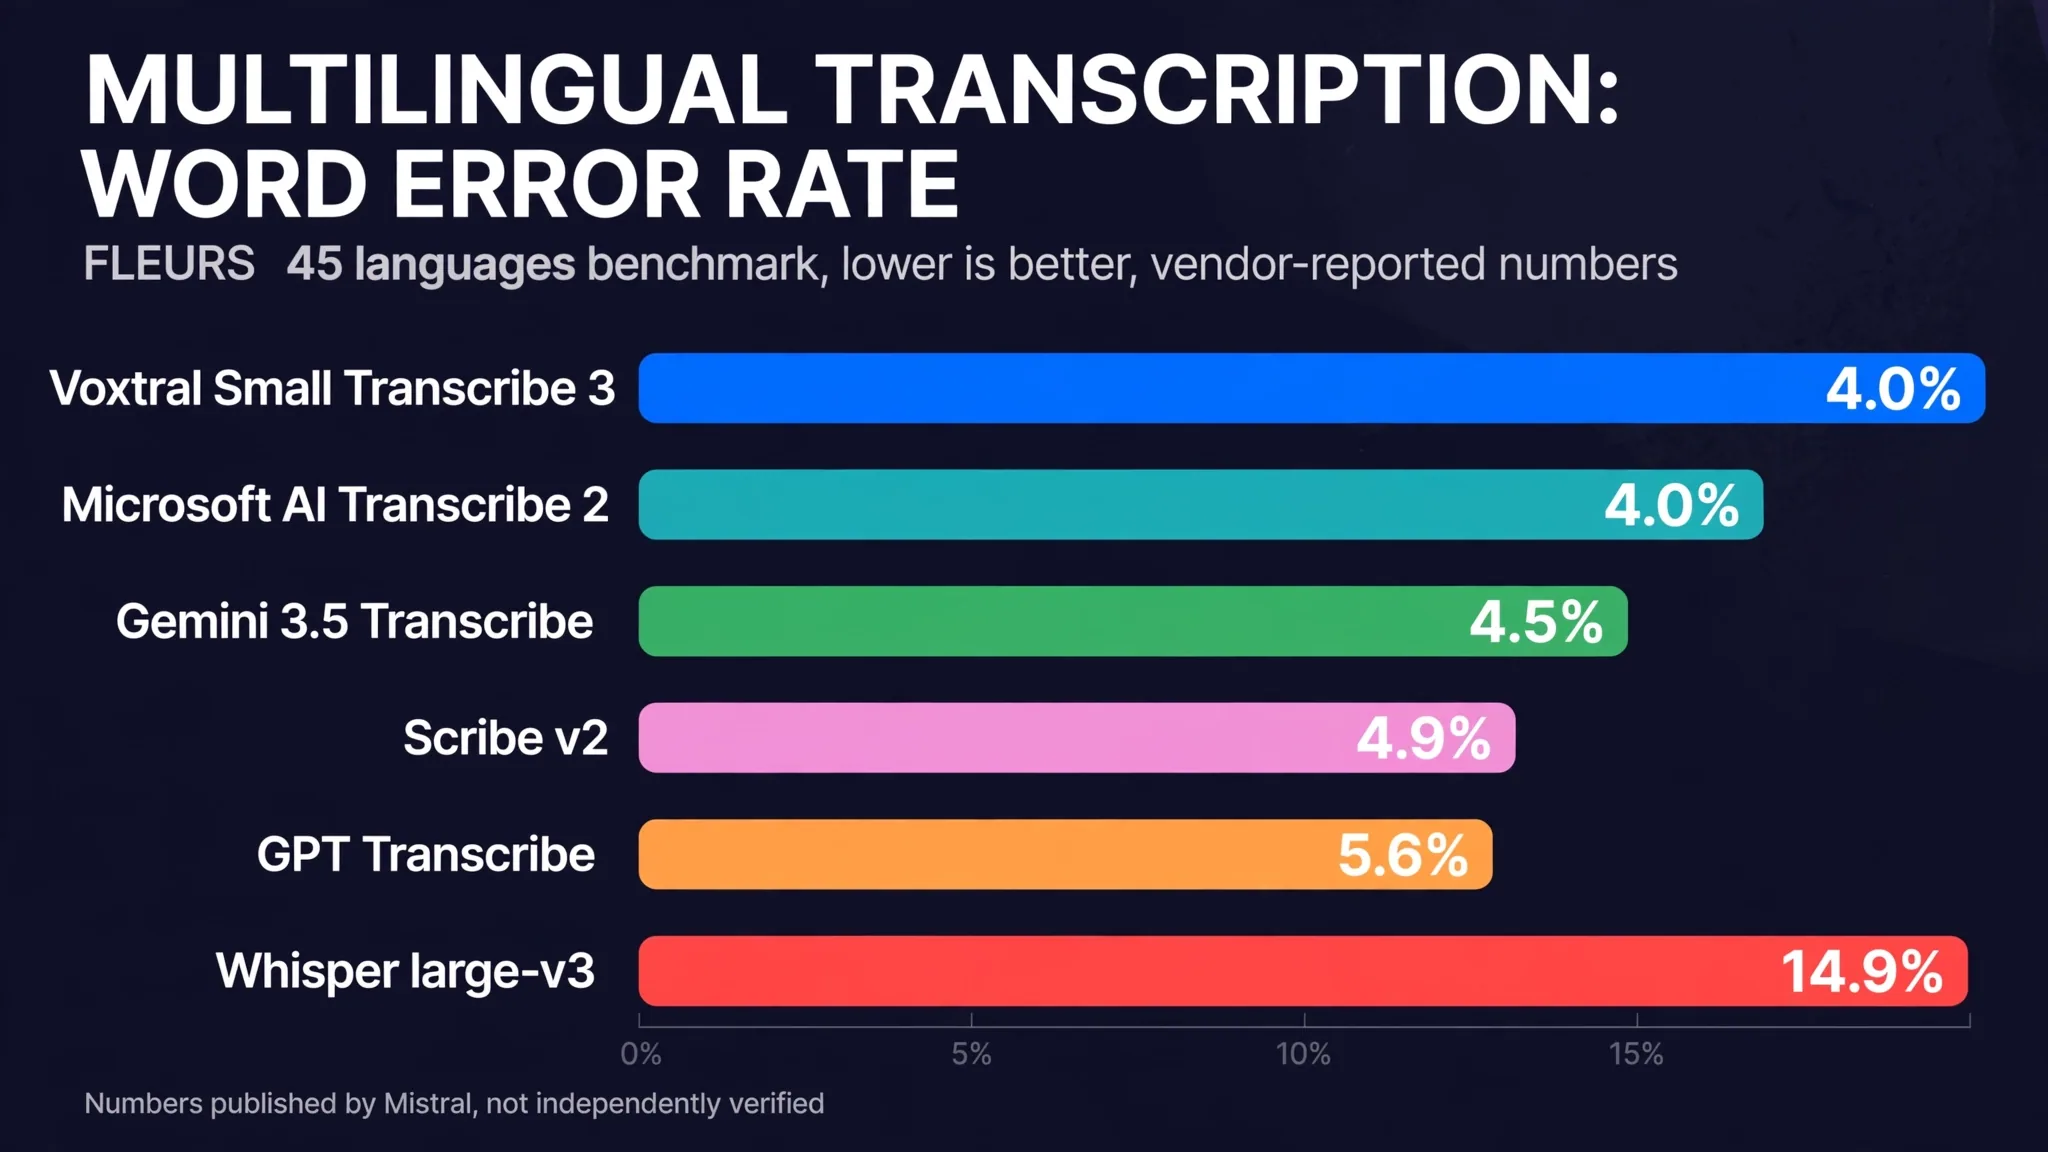
Twee belangrijke kanttekeningen. Ten eerste zijn dit door leveranciers gerapporteerde cijfers uit Mistrals lanceringsbericht, niet onafhankelijk geverifieerd, en het bericht publiceert geen taaloverzichten of klantnamen. Ten tweede, vergelijk deze grafiek niet met het Big Bench Audio 98,8%-cijfer van ElevenLabs: verschillende benchmarks meten verschillende dingen, en cross-benchmark winnaars worden hier om die reden niet bekendgemaakt.
Voor Eleven Realtime is de eerlijke uitspraak dat de eigen Big Bench Audio en Artificial Analysis-claims van ElevenLabs de enige beschikbare cijfers zijn. Beschouw de cijfers van beide leveranciers als marketing totdat derden ze reproduceren.
Op welke moet je bouwen?
Kies Voxtral 3 als:
- Je hebt EU-gegevensresidentie nodig of een zelfgehoste stack die je complianceteam kan auditen.
- Transcriptie is de werklast: 50+ talen van $0,0035 tot $0,004 per minuut is echt goedkoop.
- Je wilt een modulaire pijplijn waarin de LLM, de spraak en de taal onafhankelijk van elkaar kunnen worden uitgewisseld.
- Je hebt een tool nodig die je midden in het gesprek gebruikt: boeken, factuuropzoeken, identiteitsverificatie via SIP en WebRTC.
Kies Eleven Realtime als:
- De stem zelf is het product: premium natuurlijkheid, karakterstemmen, merkagenten.
- Je wilt een einde-tot-eind speech-to-speech zonder zelf STT en TTS aan elkaar te koppelen.
- Je bouwt al op ElevenAgents of wilt een OpenAI-compatibele Realtime API.
- Je hebt 10-seconden instant voice clones nodig in plaats van 30 minuten voice-adaptatie.
Overweeg beide als: je stemagenten voor klanten bouwt en de prijs per project is. Voxtrals batchtranscriptie van $0,0035/min en TTS van $13/M/character zetten een lage ondergrens voor werk met een hoog volume, terwijl ElevenLabs' 10-seconden klonen en spraak-naar-spraak natuurlijkheid een premie kunnen rechtvaardigen waarbij de stem het verschil maakt. CodeMyPixel bouwt precies dit soort evaluatie in elke AI-agentontwikkelingsopdracht: test beide stacks met je echte gesprekken voordat je committeert.
FAQ
Hoeveel kost Voxtral 3?
Transcriptie kost $0,0035 per minuut voor Voxtral Mini Transcribe 3 in batch, $0,0040 voor Voxtral Small Transcribe 3 en $0,008 voor Voxtral Mini Transcribe Realtime 3. Voxtral Speech 3 tekst-naar-spraak kost $13 per miljoen tekens, dezelfde prijs voor batch- en realtime gebruik.
Is Voxtral 3 open source?
De lanceringsaankondiging koppelt geen open weights of een downloadbare licentie. Mistral biedt de modellen via zijn API met EU-, Amerikaanse en wereldwijde eindpunten, en teams die audio nodig hebben om in hun eigen omgeving te blijven, kunnen Mistral vragen over zelfgehoste of private-cloud implementatie.
Hoe nauwkeurig is Voxtral Small Transcribe 3?
Op Mistrals FLEURS-test in 45 talen staat een foutpercentage van 4,0% bij afgeleide taal, tegenover 4,5% voor Gemini 3.5 Transcribe, 4,9% voor Scribe v2, 5,6% voor GPT Transcribe en 14,9% voor Whisper large-v3. Microsoft AI Transcribe 2 gelijk aan 4,0%. Dit zijn de gepubliceerde cijfers van Mistral, niet onafhankelijk geverifieerd.
Wat is het verschil tussen Voxtral 3 en ElevenLabs Eleven Realtime?
Voxtral 3 is een modulaire stack: aparte spraak-naar-tekst, LLM- en tekst-naar-spraak modellen, verbonden met een op LiveKit gebaseerde SDK. Eleven Realtime is end-to-end spraak-naar-spraak: één model neemt audio op en produceert audio uit, in twee lagen (v1 Max voor nauwkeurigheid, v1 Mini voor kosten).
Kan Voxtral Speech 3 een stem klonen?
Ja, vanaf 30 of meer minuten audio. Een Pro Voice-optie past het karakter, het emotionele bereik en de stijl van een spreker aan over talen uit ongeveer 30 minuten opnames. Spraakpresets zijn beschikbaar in 18 talen.
Wanneer is Voxtral 3 uitgebracht?
Mistral kondigde Voxtral 3 aan op 20 oktober 2026, één dag na het Timestral-tijdseriemodel. ElevenLabs bracht diezelfde middag Eleven Realtime uit.
Wat is beter voor een klantenservice-voiceagent?
Als supportgesprekken in veel talen worden uitgevoerd en de budgetten krap zijn, zijn de $0,004/min transcriptie van Voxtral 3 met speakerdiarisatie en de LiveKit SDK de praktische keuze. Als bellers nooit het gevoel willen hebben dat ze met een robot praten, is de 0,57 seconden durende spraak-naar-spraak pijplijn van Eleven Realtime v1 Max daarvoor gebouwd. De meeste teams zouden beide moeten testen op echte gespreksopnames voordat ze kiezen.
Waar kan ik een spraakagent laten bouwen voor mijn bedrijf?
CodeMyPixel ontwerpt en bouwt aangepaste AI-agenten die telefoontjes, boekingen en follow-ups voor echte bedrijven afhandelen, inclusief spraakagenten op stacks zoals Voxtral 3. Begin met een gratis AI Opportunity Review om te zien welke delen van je operatie een spraakagent kan overnemen.
Bronnen: Mistral AI lanceringspost (mistral.ai/news/voxtral-3), Technobezz, The Decoder, The Circuitry, ai-tldr, explainx.ai. Alle benchmark- en prijscijfers zijn zoals gerapporteerd door de leveranciers op 20 oktober 2026 en zijn niet onafhankelijk geverifieerd.
- mistral voxtral 3
- voice ai
- voice agents
- elevenlabs
- text to speech
- speech to text