KI-Tools & Updates3 Min. LesezeitVon JH Akash
Opus 5.5 vs GPT-6 Sol: Reale Tests bestimmen einen klaren Gewinner
Anthropic und OpenAI brachten am selben Tag neue Flaggschiffmodelle heraus. Bei Schreib-, Design- und Videobearbeitungstests hat ein Modell eindeutig gewonnen. Hier ist, was für Ihre Arbeit zählt.
Anthropic und OpenAI veröffentlichten am selben Tag dieser Woche neue Flaggschiff-Modelle: Claude Opus 5.5 und GPT-6 Sol. YouTuber Paul Lipsky hat beide durch echte Arbeit statt durch synthetische Benchmarks durchgeführt: ein Videoskript geschrieben, Motion Graphics erstellt und ein komplettes Video bearbeitet. Hier ist, was tatsächlich passiert ist.
Schreibtest: Opus 5.5 gewinnt eindeutig
Beide Modelle recherchierten im Internet und schrieben dann ein YouTube-Skript. GPT-6 Sol beendete seine Forschung in etwa 1,5 Minuten, Opus 5.5 in etwas mehr als 2 Minuten. Die Geschwindigkeit war nah dran. Die Qualität nicht.
Opus 5.5 webte eine klarere Geschichte mit einem stärkeren Erzählfaden, während das Skript von GPT-6 Sol hin und her sprang. Lipsky bezeichnet Opus 5.5 als das beste Schreibmodell, das er je verwendet hat, spürbar besser darin, seinen Tonfall zu treffen als jedes andere Modell.
Designtest: ein blindes Drei-Wege-Shootout
Die Aufgabe war Motion Graphics, die auf drei Modellen als blind bewertet wurden. GPT-6 Sol belegte den letzten Platz. Fable 5.1 kam zuerst. Opus 5.5 belegte einen knappen zweiten Platz und erreichte fast Fable. Da Opus 5.5 weniger kostet, wird es zur praktischen Wahl für die meisten zukünftigen Designarbeiten.
Videobearbeitungstest: Opus 5.5 dominiert
Das Schnitt-Setup wird in ChatGPT oder Claude eingeblendet und führt einen ersten Durchgang durch: Stille und schlechte Takes werden gestrichen, Zooms und Highlights hinzugefügt. GPT-6 Sol wählte ein seltsames Vollbild-Layout, zoomte in die falschen Stellen und machte die Zooms viel zu eng. Opus 5.5 traf das erwartete Layout, traf jeden Zoom genau und lieferte, was Lipsky als das beste KI-bearbeitete Ergebnis bezeichnet, das er je gesehen hat.
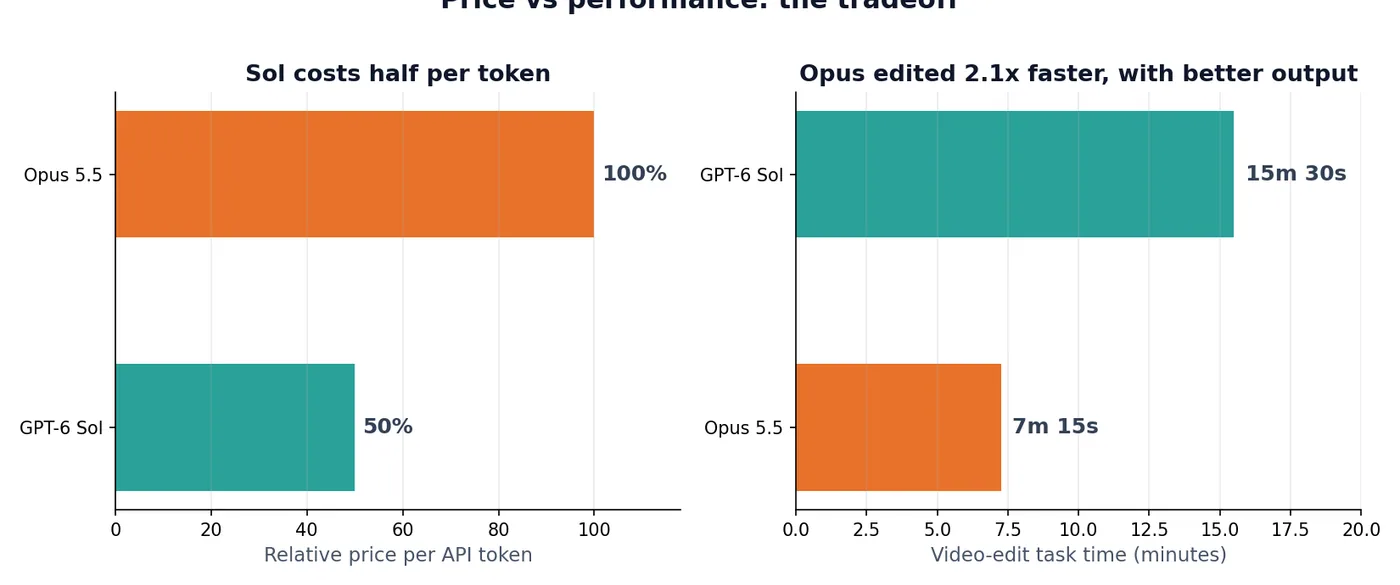
Der Clou: Opus 5.5 beendete den Schnitt in 7 Minuten und 15 Sekunden. GPT-6 Sol benötigte 15 Minuten und 30 Sekunden, mehr als doppelt so lange, für ein schlechteres Ergebnis.
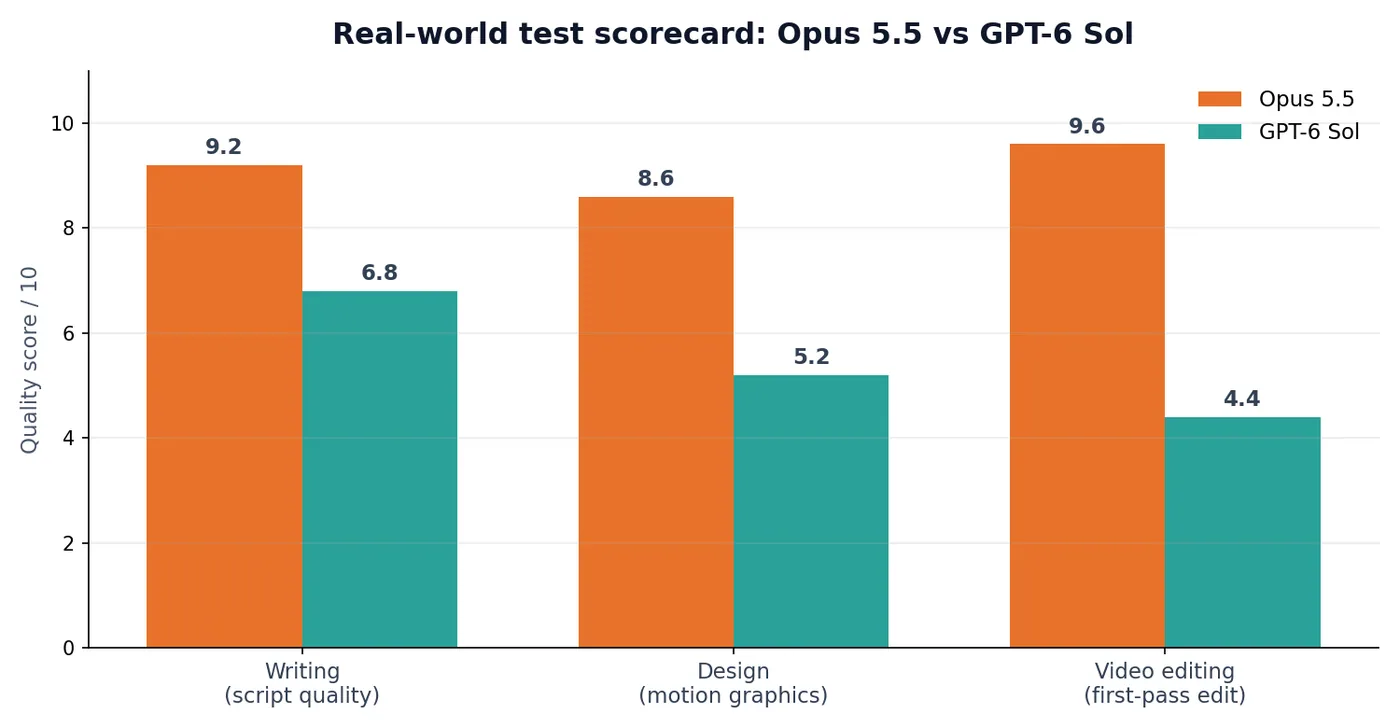
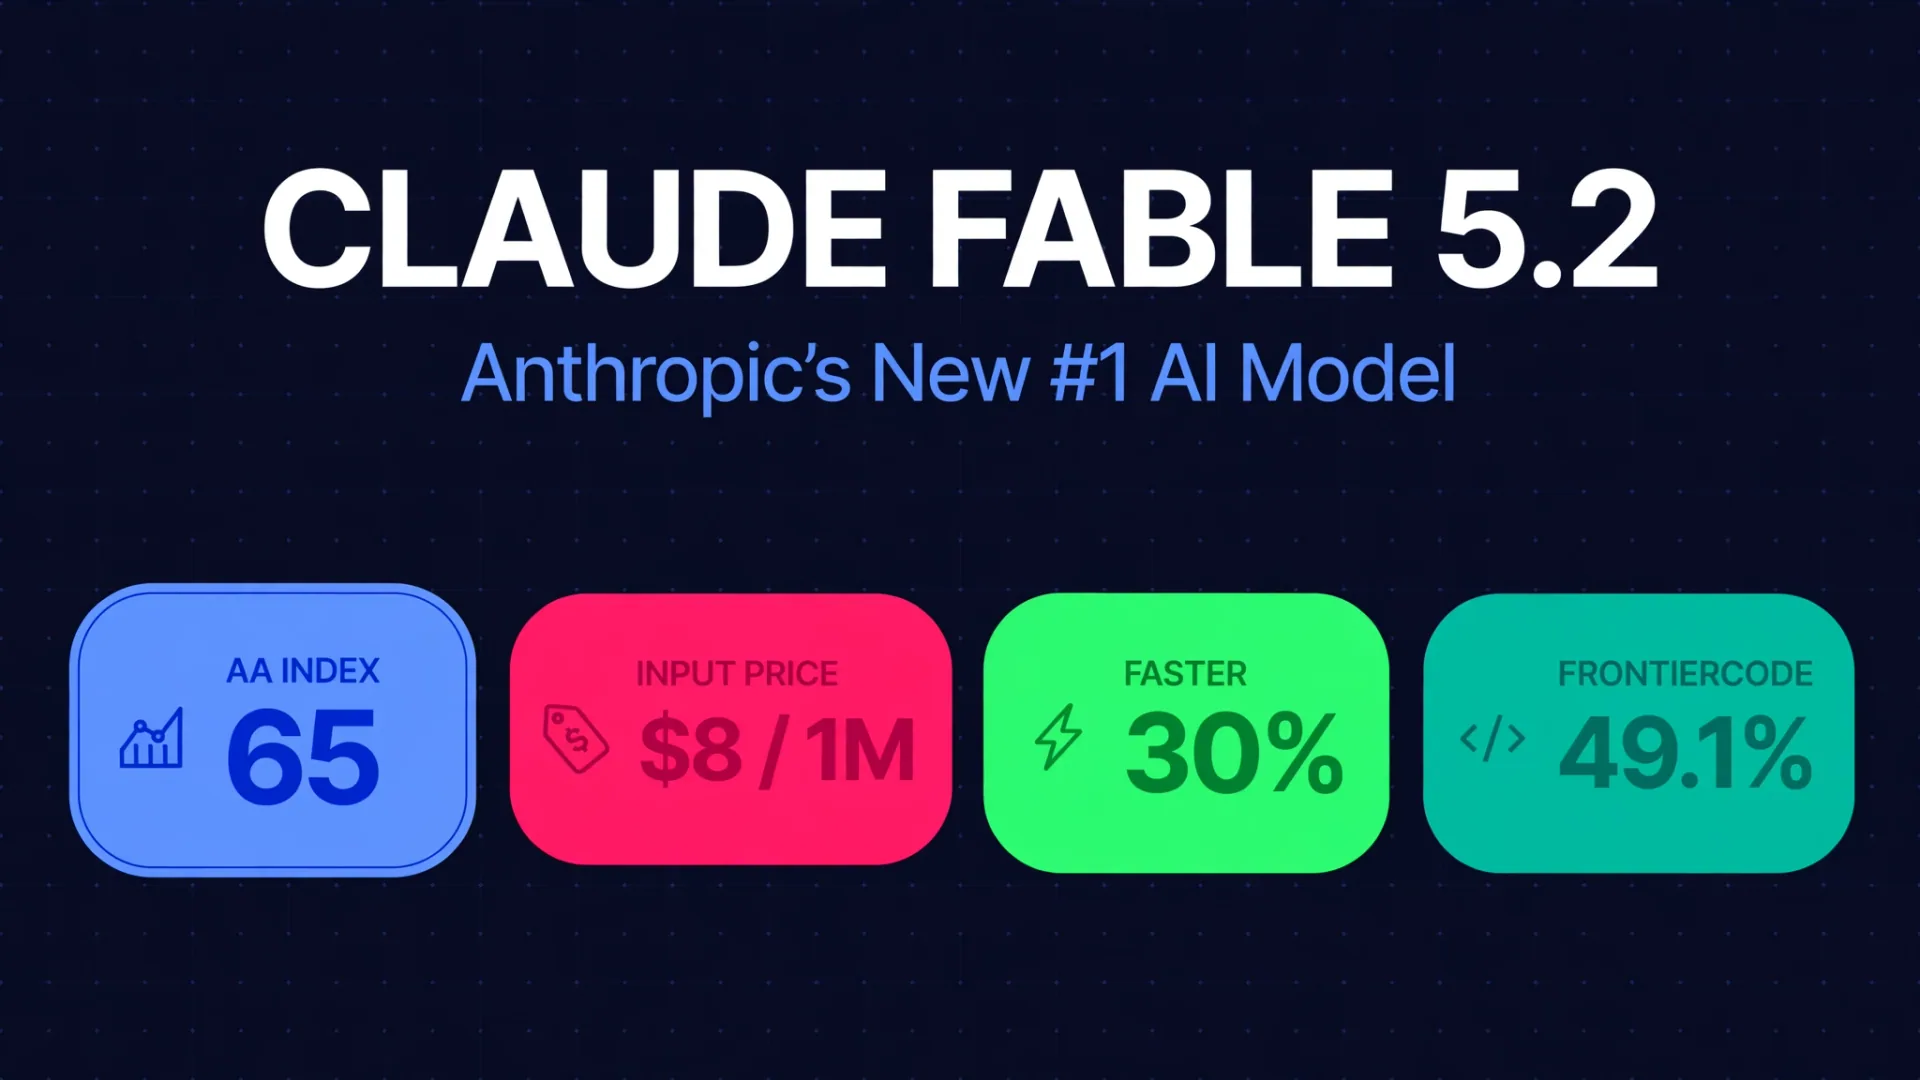
Redaktionelle Punkteübersicht, die die Urteile aus Paul Lipskys direkten Tests oben zusammenfasst.
Die Zahlen, die zählen
- Unabhängiger Benchmark: Opus 5.5 gewinnt mit 10 Punkten.
- Preis: GPT-6 Sol kostet nur halb so viel pro API-Token.
- Geschwindigkeit: GPT-6 Sol ist normalerweise schneller, hat aber beim Bearbeiten stark verloren.
- Kosten pro Aufgabe: weniger als 1 Prozent der wöchentlichen Nutzung im 100-Dollar-Monatsplan für beide Modelle. Diese Tests sind günstig durchzuführen.
Das Urteil
GPT-6 Sol ist günstiger und oft schneller. Opus 5.5 ist besser in der eigentlichen Arbeit. Für Schreiben, Editieren und Design ist Opus 5.5 das neue Standardmodell und behebt alles, was Opus 5 zu einem Modell gemacht hat, das niemand verwendet hat.
Auch diese Woche, in schnellen Treffern
- Gemini Notebook bietet Live-Sprachchat mit Notizbüchern für Ultra-Abonnenten, Notizbüchern als zitierbare Quellen in Google Docs sowie neue interaktive Berichte, die Infografiken, Präsentationen, Mindmaps und Quizze einbetten.
- Grok 4.7 ist mit beanspruchten Gewinnen zum gleichen Preis und Geschwindigkeit erhältlich. Grokbot fügt Sprachmemos, Sprachanrufe mit Stimmen pro Bot und lokale Verkehrsrouten hinzu, um Cloud-Blockaden zu umgehen.
- Meta Muse hatte eine große Connect-Keynote: Jede Muse erhält ihre eigene E-Mail-Adresse, Live-Videoanrufe mit animiertem Avatar, Computernutzung in der Mac-App und neue Shopping-Connectors wie Walmart, Best Buy und Sephora. Amazon hat Muse von seiner Website blockiert. Neue Hardware umfasst den taschengroßen Muse Charm mit Fingerabdrucksensor.
- Die ChatGPT-Desktop-App unterstützt jetzt jede Chrome-Erweiterung, Plugins können mehrere Konten verbinden, und Voice kann E-Mail-, Kalender- und Slack-Plugins verwenden.
Was das für dein Team bedeutet
Die Modellwahl hängt jetzt vom Auftrag ab, nicht von der Marke. Bei Inhalten und kreativen Pipelines ist Qualität pro Dollar wichtiger als die rohe Geschwindigkeit. Bevor Sie Ihren Workflow auf ein Modell festlegen, testen Sie es an Ihren echten Aufgaben, so wie Lipsky es getan hat.
Bei CodeMyPixel bauen wir individuelle KI-Agenten und Automatisierungen für wachsende Teams und testen Modelle jede Woche mit echten Kundenarbeiten. Wenn Sie eine KI möchten, die wirklich zu Ihrem Prozess passt, sprechen Sie mit uns.
Basierend auf Paul Lipskys wöchentlicher KI-Nachrichtenzusammenfassung. Sehen Sie sich die vollständige Aufschlüsselung oben an.
- AI models
- Claude Opus
- GPT-6
- AI news