KI5 Min. LesezeitVon JH Akash
Claude Opus 5.5: Das größte KI-Modell aller Zeiten? (Videoübersicht + Benchmarks)
Anthropic's Claude Opus 5.5 ist intelligenter, schneller und 40 % günstiger als Opus 5. Vollständige Analyse von Alex Finns Video zum 'größten KI-Modell aller Zeiten', mit verifizierten Benchmarks und Diagrammen.
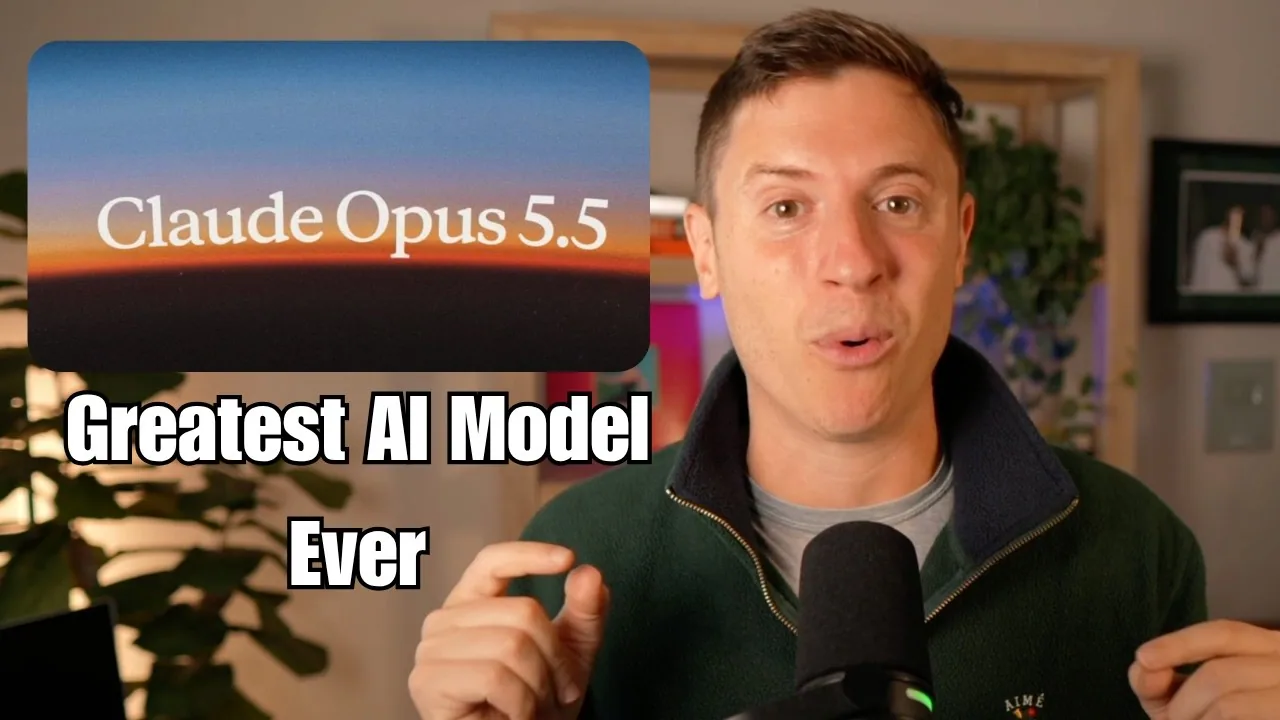
Anthropic veröffentlichte Claude Opus 5.5 am 22. September 2026, und ein Video kursiert mit einer kühnen Behauptung: Es ist das beste KI-Modell, das je veröffentlicht wurde.
Das Video stammt vom YouTuber Alex Finn, der frühzeitig Zugang zu dem Modell erhielt und es tagelang vor dem Start getestet hat. Sein Urteil nach der Aufhebung des Embargos: Opus 5.5 ist intelligenter als alle anderen Modelle, schneller als alle anderen und irgendwie auch günstiger. Hier ist die vollständige Aufschlüsselung dessen, was er herausgefunden hat, mit den verifizierten Spezifikationen und Benchmarks hinter dem Hype.
Die Early-Access-Geschichte
Anthropic übergab Finn das Modell, ohne ihm den Namen zu nennen. Er nahm an, es sei eine Art Sonett 5.2, denn der Sprung über seine Sonett-Ergebnisse war so dramatisch. Als Anthropic ihm sagte, es sei tatsächlich Opus 5.5, glaubte er es zunächst nicht. Seiner Meinung nach hatte er Opus noch nie so schnell gesehen, und die Intelligenzlücke gegenüber allem anderen war nicht einmal annähernd.
Das Trifecta: klüger, schneller, günstiger
Finns Kernargument nennt er die Trifecta. Opus 5.5 ist in allen drei gleichzeitig das Beste der Klasse, was man fast nie sieht.
1. Klüger. In den Startcharts von Anthropic schlägt Opus 5.5 mit hoher Einstellung alle anderen Modelle, die auf Maximum laufen. Die unabhängigen Zahlen bestätigen das. Auf Terminal-Bench 4.0, dem Benchmark für agentische Coding, erzielt Opus 5.5 66,4 %, vor GPT-6 Astra mit 57,9 % und Claude Fable 5.1 mit 55,8 %.
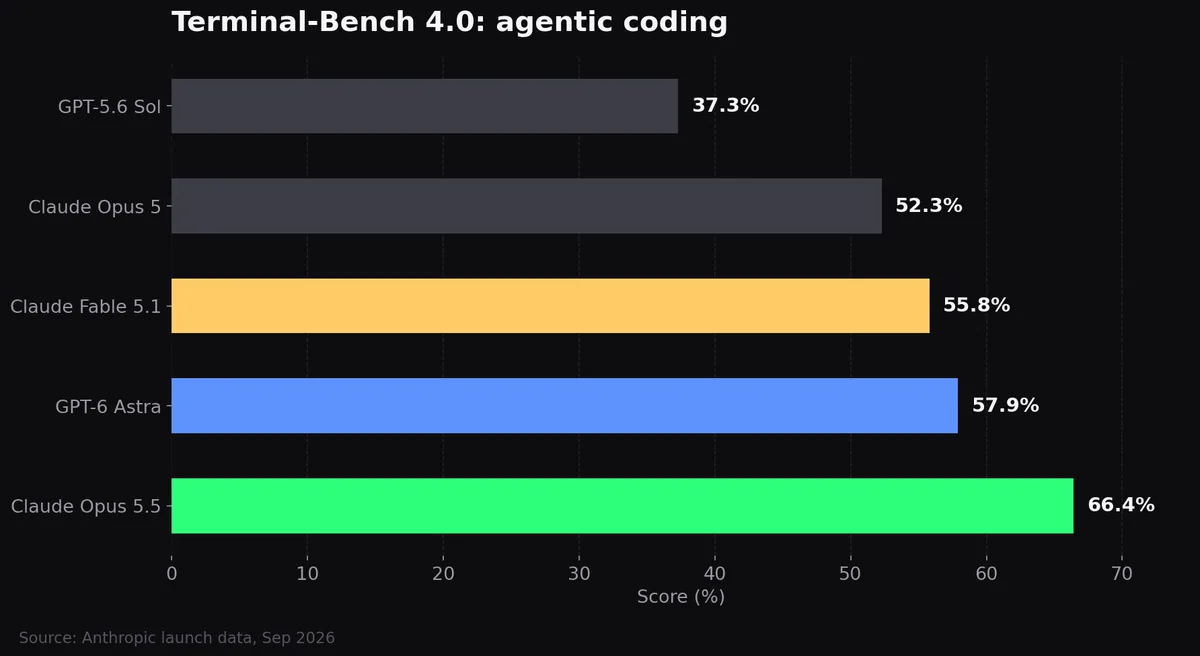
Es verzeichnet außerdem 54,4 % auf FrontierCode v1.1, 67,7 % auf Humanity's Last Exam mit Tools und 81,8 % auf OSWorld 2.0 (teilweise), alles stand der Technik zum Start.
2. Schneller. Finn sagt, es fühlt sich schneller an als alle bisherigen Opus-Modelle und auch schneller als die GPT- und ChatGPT-Modelle. Anthropic berichtet von etwa 30 % schnellerer Output-Generierung als Opus 5.
3. Günstiger. Das überraschte ihn am meisten. Anthropic senkte den Listenpreis auf 4 Dollar pro Million Eingabetoken und 20 Dollar pro Ausgabe-Token, von 5 und 25 Dollar bei Opus 5. Das ist 20 % günstiger pro Token, und Anthropic sagt, dass typische Workloads insgesamt etwa 40 % weniger sind, weil das Modell auch effizienter ist.
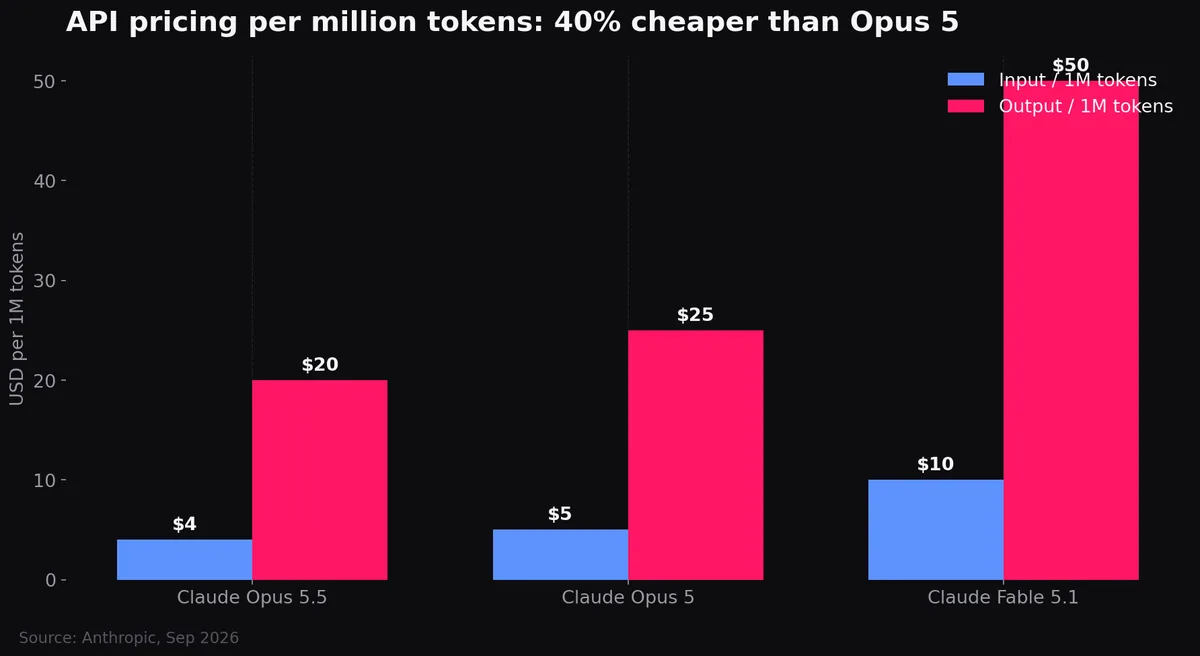
Finns Einschätzung der Strategie: Wenn das Modell so gut ist, werden die Leute es einfach viel öfter nutzen, sodass niedrigere Preise immer noch mehr Umsatz bedeuten. Verbraucherfreundlich und unternehmensfreundlich zugleich.
Das Beste daran: Es spricht wieder wie ein Mensch
Finn sagt, der beste Teil des Modells sind nicht die Benchmarks. Es ist die Persönlichkeit.
Seine Beschwerde wird vielen KI-Nutzern vertraut vorkommen. Jedes seit etwa Mai 2026 veröffentlichte Modell von jedem Unternehmen wurde unerträglich: seltsamer Fachjargon, Absätze, die nie enden, und wenn man fertig gelesen hat, fragt man sich, was man gerade gelesen hat. Anthropic eigene Modelle verloren das warme, prägnante, menschliche Gefühl, das die Menschen überhaupt erst liebte, mit ihnen zu sprechen.
Opus 5.5 bringt es zurück. In seiner Live-Demo berichtete das Modell Testergebnisse so, wie man es tun würde: was es gebaut hat, was verbessert wurde, saubere Tische, die leicht zu scannen sind. Kein Sprech von Unternehmensrobotern. Finn bewertet es als ebenso gut oder besser zum Gespräch als Opus 4.5 und das originale Sonnet 3.5, seine langjährigen Favoriten für Gespräche.
Die Demos: Debugging und ein vollständiges Spiel in fünf Prompts
Debugging. Finn gab Opus 5.5-Code, der von anderen Modellen generiert wurde, und bat es einfach, die Dinge zu verbessern. Ohne überhaupt gebeten zu werden, fand es Problem um Problem im Code von GPT-6 Astra und anderen.
Ein 3D-Extraktions-Shooter in etwa fünf Eingabeaufforderungen. Das Highlight: ein vollständiger Top-Down-3D-Extraktionsshooter mit Waffeninventarsystem, einer Karte mit mehreren Orten, Gegnern, Beute und einem funktionierenden Extraktionsmechanismus. Mehr Tiefe als das, was er aus Astra bekommen hat, mit sehr wenigen Bugs.
Neue Ideen. Finn nutzt KI zum Brainstorming und bezeichnet Opus 5.5 als das beste Modell aller Zeiten. Zwei Beispiele aus dem Video: Ideen für seine neue Apple Watch Ultra 4, bei der das Modell ein App-Konzept entworfen hat, um seine KI-Agenten vom Handgelenk aus zu sehen und mit ihnen zu sprechen, ohne dass ein Handy nötig ist, sowie kreative Anwendungen für ein Regal mit 17 Computern, die er herumliegen hat.
Der ehrliche Nachteil
Finn ist offen über eine Schwäche. Das Claude Code-Geschirr ist immer noch nicht so funktionsreich wie das von ChatGPT, und Claudes Sprachmodus ist noch nicht so gut wie der von ChatGPT. Seine Meinung: Das Modell selbst ist so gut, dass man es trotzdem nutzen sollte, und er erwartet, dass Anthropic die Lücke im Geschirr bald schließen wird.
Claude Opus 5.5 Spezifikationen auf einen Blick
- Modell-ID: claude-opus-5-5
- Veröffentlicht: 22. September 2026
- Kontextfenster: 1 Million Token
- Maximaler Ausgang: 128.000 Token
- Wissensgrenze: Juni 2026
- Preis: 4 $ Eingabe / 20 $ Ausgabe pro 1 Million Token (Cache liest 0,20 $ pro 1 Million)
- Verfügbar auf: Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry
Wie man es benutzt
Opus 5.5 ist über die Claude API unter der Modell-ID claude-opus-5-5 sowie über Anthropic Cloud-Partner verfügbar: Amazon Bedrock, Google Cloud und Microsoft Foundry. Wenn Sie einen Claude Pro- oder Team-Tarif haben, prüfen Sie Ihren Modellwähler, da Anthropic in der Regel neue Opus-Modelle zusammen mit der API in die Apps einführt.
Die Nutzung des Modells über die API ist der einfache Teil. Um es in einen geregelten Geschäftsablauf zu verwandeln, braucht es Architektur, Berechtigungen und menschliche Genehmigung, was unser Leitfaden zur Entwicklung von KI-Agenten abdeckt.
Sieh dir das Originalvideo an
FAQ
Ist Claude Opus 5.5 wirklich besser als GPT-6 Astra? Bei agentischen Coding-Benchmarks ja. Terminal-Bench 4.0 bringt Opus 5.5 auf 66,4 % gegenüber 57,9 % für GPT-6 Astra. Finns praxisnahe Tests stimmten zu: Es wurden Fehler im von Astra generierten Code gefunden, ohne gefragt zu werden.
Wie viel günstiger ist Opus 5.5 als Opus 5? Die Listenpreise sanken um 20 % pro Token (5 bis 4 $ Input, 25 $ bis 20 $ Output). Anthropic sagt, dass typische Workloads insgesamt etwa 40 % weniger kosten, weil das Modell auch effizienter mit seinen Token ist.
Was ist das Kontextfenster von Claude Opus 5.5? 1 Million Kontext-Tokens, mit bis zu 128.000 Token Ausgabe in einer einzigen Antwort.
Sollte ich von Fable 5.1 zu Opus 5.5 wechseln? Wenn du agentisches Coding, Debugging oder lange autonome Durchläufe machst, sagen die Zahlen ja. Opus 5.5 schlägt Fable 5.1 in Benchmarks und kostet weniger als die Hälfte pro Token (4 $/20 $ vs. 10 $/50 $). Der einzige Grund zu warten: Wenn du auf die Agenten-Harness-Funktionen oder den Sprachmodus von ChatGPT angewiesen bist, liegen diese immer noch vor denen von Claude.
Möchten Sie Frontier-KI in Ihr Unternehmen einsetzen? CodeMyPixel entwickelt maßgeschneiderte KI-Agenten, Automatisierungen und Webplattformen für wachsende Teams. Sprechen Sie mit uns über Ihr Projekt.
- Claude Opus 5.5
- Anthropic
- Claude
- GPT-6 Astra
- Claude Fable 5.1
- AI benchmarks
- AI coding
- LLM comparison
- AI news