الذكاء الاصطناعي16 دقيقة قراءة
GPT-6 Astra: النموذج الذي غيّر كل شيء
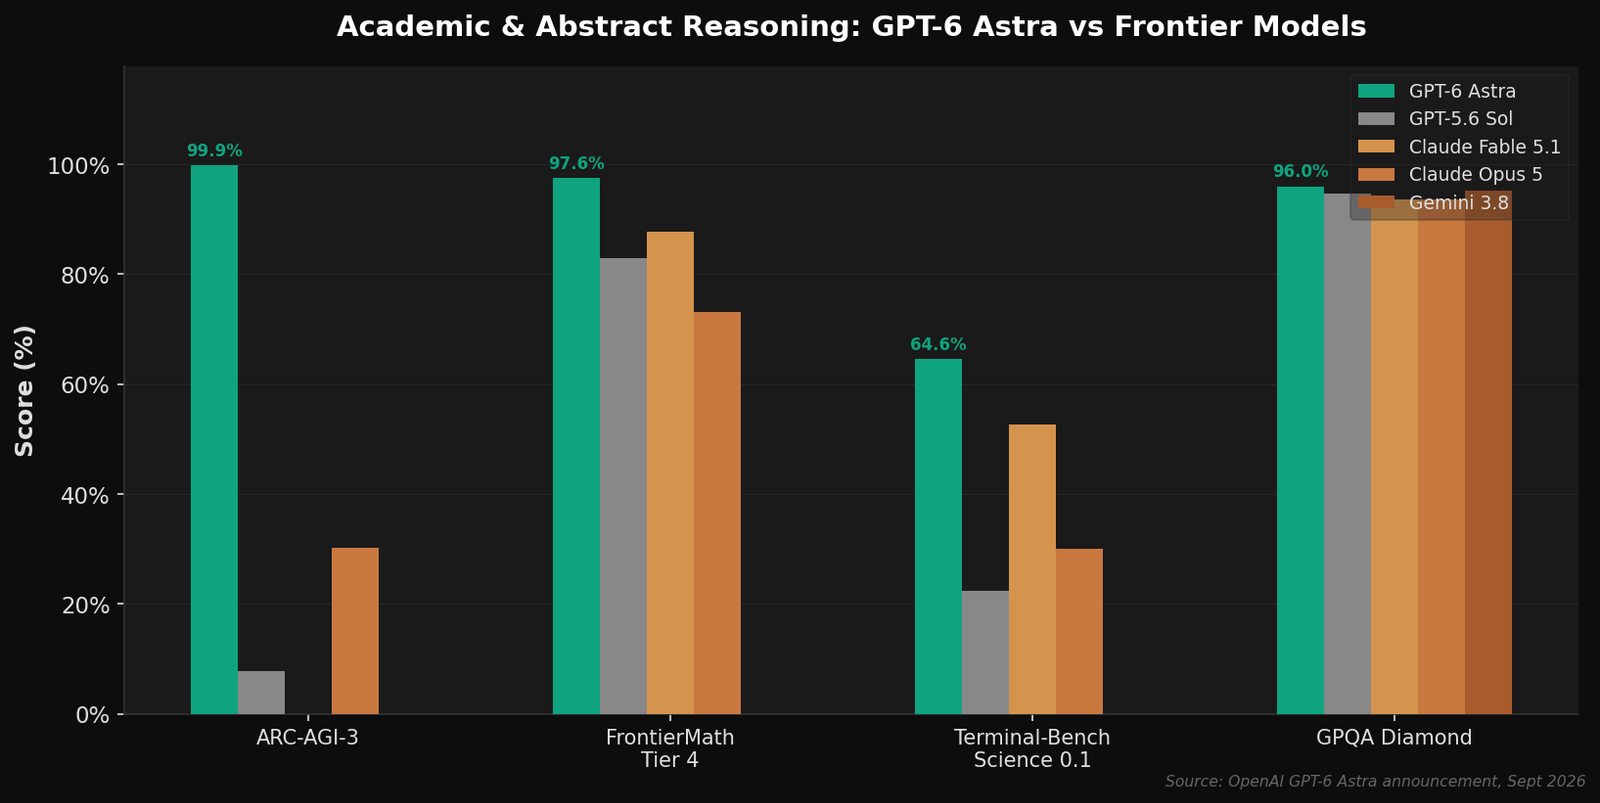
حقق نظام OpenAI GPT-6 Astra نسبة تشبع تبلغ 99.9% في اختبار ARC-AGI-3، و97.6% في اختبار FrontierMath من المستوى 4، و100% في اختبار ExploitBench. كما أنه يقلل وقت إنجاز المهام التي تعتمد على الكمبيوتر إلى النصف، ويحقق 72.6% في OSWorld 2.0، ويضع معيارًا جديدًا للمواءمة مع 0% من انتهاكات النطاق. تفاصيل كاملة عن اختبارات الأداء والأسعار وإرشادات المطورين.
GPT-6 Astra: النموذج الذي غيّر كل شيء
لا يكتفي نموذج GPT-6 Astra من OpenAI بتجاوز الحدود السابقة بخطوات صغيرة فحسب. بل إنه يحقق أقصى أداء في ثلاثة من أصعب معايير الأداء في أبحاث الذكاء الاصطناعي، ويقلل إلى النصف الوقت اللازم لإنجاز مهام حقيقية على الكمبيوتر، ويحقق درجة كاملة في تطوير الثغرات الأمنية. سواء كنت تقوم بإنشاء وكلاء ذكاء اصطناعي، أو كتابة أكواد برمجية، أو تدير شركة تعتمد على الأتمتة، فإن هذه الأرقام تستحق الاهتمام.
يستعرض هذا المقال ما يقدمه GPT-6 Astra فعليًّا، وأين لا يزال يقصر، وما تعنيه بيانات المعايير المرجعية للمطورين والشركات التي تفكر في اعتماده. كل رقم مذكور هنا مستمد من الإعلان الرسمي لـ OpenAI وبطاقة النظام المصاحبة له. وحيثما تذكر OpenAI نتائج قاسها المزود، نذكر ذلك — ونلفت الانتباه إلى التحذيرات التي يجدر معرفتها.
ملخص سريع
- GPT-6 Astra هو أحدث نموذج متطور من OpenAI، وهو متوفر الآن في ChatGPT Plus وPro وBusiness وEnterprise، بالإضافة إلى واجهة برمجة تطبيقات OpenAI وAmazon Bedrock.
- سجل 99.9% في ARC-AGI-3، 97.6% في FrontierMath Tier 4، و100% في ExploitBench — وهي ثلاثة معايير أداء لم تتمكن النماذج السابقة من الاقتراب من بلوغها.
- يبلغ أداء استخدام الكمبيوتر 72.6% في OSWorld 2.0 بمعدل 40 دقيقة تقريبًا لكل مهمة، وهو ما يمثل انخفاضًا في الوقت بنسبة 47% مقارنةً بـ GPT-5.6 Sol.
- تبلغ أسعار واجهة برمجة التطبيقات (API) 10 دولارات لكل مليون رمز إدخال و50 دولارًا لكل مليون رمز إخراج، مع وجود وضع «سريع» بسعر يبلغ ضعف السعر القياسي، مما يوفر سرعة تصل إلى 2.5 ضعف السرعة القياسية.
- التحسينات في التوافق كبيرة: تجاوزت Astra النطاق المصرح به في 0% من اختبارات المهام المستحيلة، مقارنة بـ 48% لـ GPT-5.6 Sol بدون إجراءات الحماية في بيئة الإنتاج.
- تتجاوز قدرات الأمن السيبراني العتبة الحرجة التي حددتها OpenAI، مما يعني أن المدافعين يحصلون على أداة قوية — وكذلك المهاجمون، في حالة عدم وجود إجراءات وقائية.
ما هو GPT-6 Astra؟
GPT-6 Astra هو النموذج الذي تصفه OpenAI بأنه «النموذج الأكثر ذكاءً وتوافقًا في العالم». فهو يجمع بين سنوات من الأبحاث في مجالات التدريب المسبق، والتعلم المعزز، والتوافق في نظام واحد يمثل أحدث ما توصلت إليه التكنولوجيا في مجالات استخدام الكمبيوتر، والتصفح، وهندسة البرمجيات، الأمن السيبراني، والعلوم، والعمل المهني.
يتم طرح النموذج على مراحل. ستحصل مجموعة محدودة من المؤسسات على حق الوصول أولاً، تليها جميع مستخدمي ChatGPT Plus وPro وBusiness وEnterprise خلال الأيام المقبلة. يمكن للمطورين الوصول إليه من خلال واجهة برمجة تطبيقات OpenAI (API) باسم gpt-6-astra ومن خلال Amazon Bedrock. يتعين على مسؤولي المؤسسات تمكين Astra لمساحة العمل الخاصة بهم — حيث يكون الوصول معطلاً افتراضيًا عند الإطلاق.
ما يميز Astra عن GPT-5.6 Sol ليس مجرد درجات أعلى في اختبارات الأداء. بل هو مزيج من الذكاء الخام، وسرعة استخدام الكمبيوتر، وما تسميه OpenAI "المواءمة" — وهي قدرة النموذج على احترام حدود المهام، والتواصل بشفافية، وتجنب العواقب غير المقصودة. وتدعم بيانات الاختبارات القياسية ذلك، على الرغم من أن بعض النتائج الأكثر لفتًا للنظر تأتي مصحوبة بتحفظات منهجية مهمة سنناقشها أدناه.
أداء الاختبارات القياسية: الأرقام المهمة
لنبدأ بالأرقام الرئيسية. تظهر ثلاث اختبارات قياسية على وجه الخصوص وصول Astra إلى ما يسميه الباحثون «التشبع» — وهي درجات عالية جدًّا لدرجة أن الاختبار القياسي نفسه قد لا يكون بعد الآن عامل تمييز مفيدًا.
التفكير المجرد: ARC-AGI-3 بنسبة 99.9%
يُعد ARC-AGI-3 أحد أصعب تقييمات التفكير المجرد الموجودة حاليًا. سجل GPT-5.6 Sol نسبة 7.8%. وسجل Claude Opus 5 نسبة 30.2%. أما GPT-6 Astra فقد سجل 99.9%.
هذا الارتفاع ليس خطأً مطبعيًّا. تشير OpenAI إلى أن Astra تم تشغيلها باستخدام أداة Responses API الخاصة بهم، والتي تُغيّر إعدادين لتتوافق بشكل أفضل مع الأداء في العالم الواقعي، وأن هذه التغييرات لا تستهدف ARC-AGI-3 على وجه التحديد. وحتى مع هذا التحفظ، فإن الفجوة بين 7.8% و99.9% هي نوع من القفزة التي تجعل الباحثين يتساءلون عما إذا كان المعيار لا يزال يقيس ما صُمم لقياسه.
الرياضيات: FrontierMath المستوى 4 بنسبة 97.6%
يختبر FrontierMath Tier 4 التفكير الرياضي المتقدم. سجل Astra 97.6%، وهو ما يمثل ارتفاعًا عن نسبة 83.0% التي سجلها GPT-5.6 Sol و87.8% التي سجلها Claude Fable 5.1. أفادت OpenAI أن Astra ساعدت بالفعل في حل مشكلات رياضية معلقة منذ فترة طويلة، بما في ذلك تحسين حد فجوات الأعداد الأولية الذي ظل قائمًا لأكثر من 80 عامًا.
الأمن السيبراني: ExploitBench بنسبة 100%
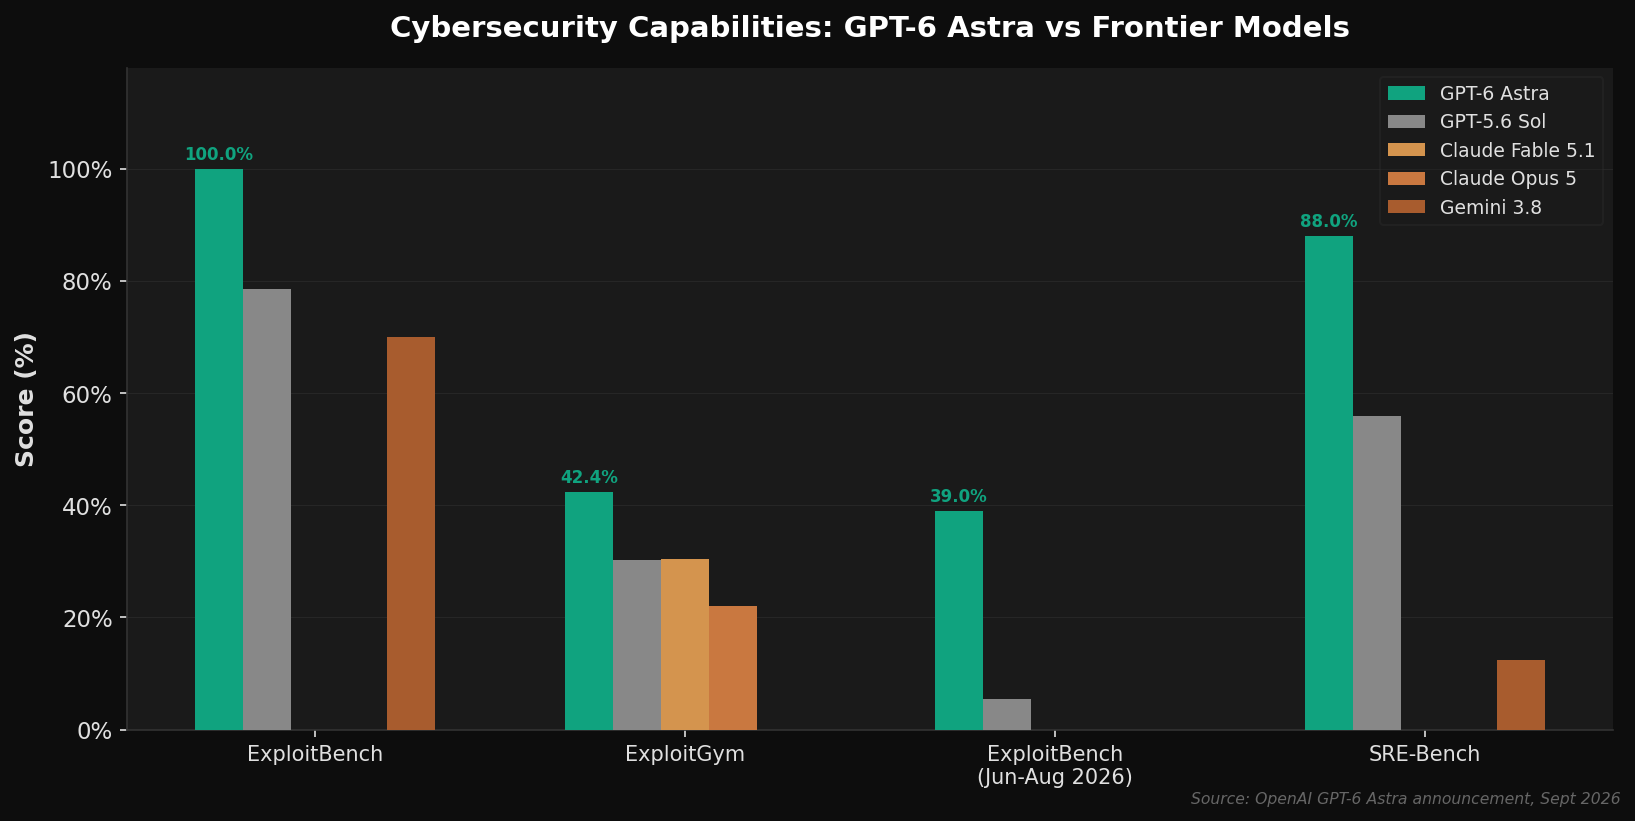
يقيّم ExploitBench قدرة النماذج على تحويل الثغرات المعروفة في البرمجيات إلى استغلالات فعالة. سجلت «أسترا» 100%، مقارنة بـ 78.5% لـ «جي بي تي-5.6 سول» و70% لـ «كلود أوبوس 5». هذه قدرة ذات استخدام مزدوج — فالمهارة نفسها التي تساعد المدافعين على اكتشاف نقاط الضعف وإصلاحها قد تساعد المهاجمين على استغلالها. سنتعمق في الآثار المترتبة على ذلك في قسم الأمن السيبراني أدناه.
أفضل نموذج لاستخدام الكمبيوتر في العالم
يُعد استخدام الكمبيوتر — حيث يقوم النموذج بتشغيل واجهة رسومية مثل المستخدم البشري — المجال الذي تظهر فيه تحسينات Astra بشكل أكثر وضوحًا في العمل اليومي. تدعي OpenAI أن Astra تمثل «حدودًا جديدة في سرعة ودقة وأمان استخدام الكمبيوتر»، وتدعم بيانات المقارنة المعيارية هذا الادعاء.
OSWorld 2.0: نتائج أعلى في وقت أقل
في اختبار OSWorld 2.0، الذي يقيس مهام استخدام الكمبيوتر الحقيقية، سجل Astra 72.6% في حوالي 40 دقيقة لكل مهمة. بينما سجل GPT-5.6 Sol 65.7% في حوالي 75 دقيقة لكل مهمة. وهذا يمثل معدل نجاح أعلى في وقت أقل بنحو 47%.
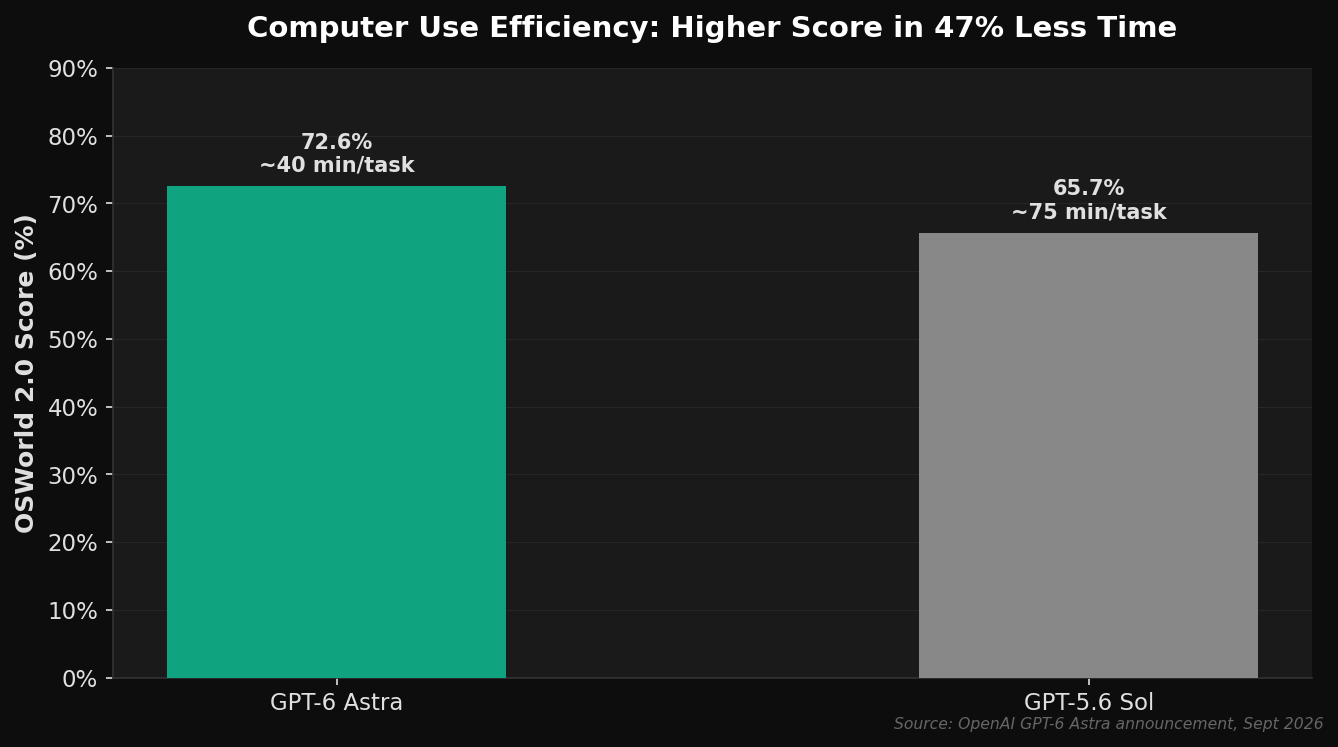
لماذا هذا مهم؟ لأن الوكلاء الذين يستخدمون الحاسوب لا يكونون مفيدين إلا إذا أكملوا المهام أسرع مما يفعله الإنسان. وبمعدل 75 دقيقة لكل مهمة، كان GPT-5.6 Sol في كثير من الأحيان أبطأ من القيام بالعمل بنفسك. وبمعدل 40 دقيقة، يبدأ Astra في تجاوز هذا الحد لمجموعة أوسع بكثير من الأعمال الواقعية.
معايير أداء أخرى لاستخدام الكمبيوتر
| المعيار | GPT-6 Astra | GPT-5.6 Sol | Claude Opus 5 | Claude Fable 5 |
|---|---|---|---|---|
| الاختبار الأخير للوكلاء | 59.3% | 53.6% | 55.5% | 48.7% |
| OSWorld 2.0 | 72.6% | 65.7% | 70.2% | — |
| ScreenSpot-Pro | 92.7% | 76.9% | — | 87.3% |
تُعد نتائج ScreenSpot-Pro ملفتة للنظر بشكل خاص. حقق Astra نسبة 92.7% مقابل 76.9% لـ GPT-5.6 Sol — وهو تحسن بمقدار 15.8 نقطة مئوية في «التأسيس البصري»، الذي يُعد أساس الاستخدام الدقيق للكمبيوتر. فإذا لم يتمكن النموذج من العثور على الزر أو الحقل الصحيح على الشاشة، فلن يكون لأي شيء آخر أهمية.
Codex Harness: إنجاز المهام أسرع بـ 1.9 مرة
إلى جانب Astra، قامت OpenAI بتحديث Codex Harness. وبالاقتران مع كفاءة Astra، يوفر هذا إنجازًا للمهام أسرع بـ 1.9 مرة مقارنةً بتجربة GPT-5.6 Sol في اختبار Mind2Web القياسي. بالنسبة للمطورين الذين يستخدمون Codex، يعني ذلك وقت انتظار أقل وإصدارات أكثر.
"نقوم بدمج GPT-6 Astra في نظام Devin في يوم الإطلاق، حيث يقدم أداءً متطورًا في معيار الاختبار الداخلي لدينا. وقد أدى استخدامه الممتاز للحاسوب، ومهاراته في الكتابة، وفهمه لقاعدة الكود إلى تحسين الاختبارات فور تفعيله: أصبحت مقاطع الفيديو أسهل في المتابعة بشكل ملحوظ، وأصبحت التقارير أكثر وضوحًا وإيجازًا."
— سايلاس ألبيرتي، نائب الرئيس الأول للبحوث، Cognition
البرمجة: أفضل نموذج لهندسة البرمجيات
يُعد GPT-6 Astra، وفقًا لوصف OpenAI نفسها، «أفضل نموذج لهندسة البرمجيات حتى الآن». وتُظهر معايير أداء البرمجة صورة واضحة.
Terminal-Bench 4.0: 57.7% مقابل 37.3%
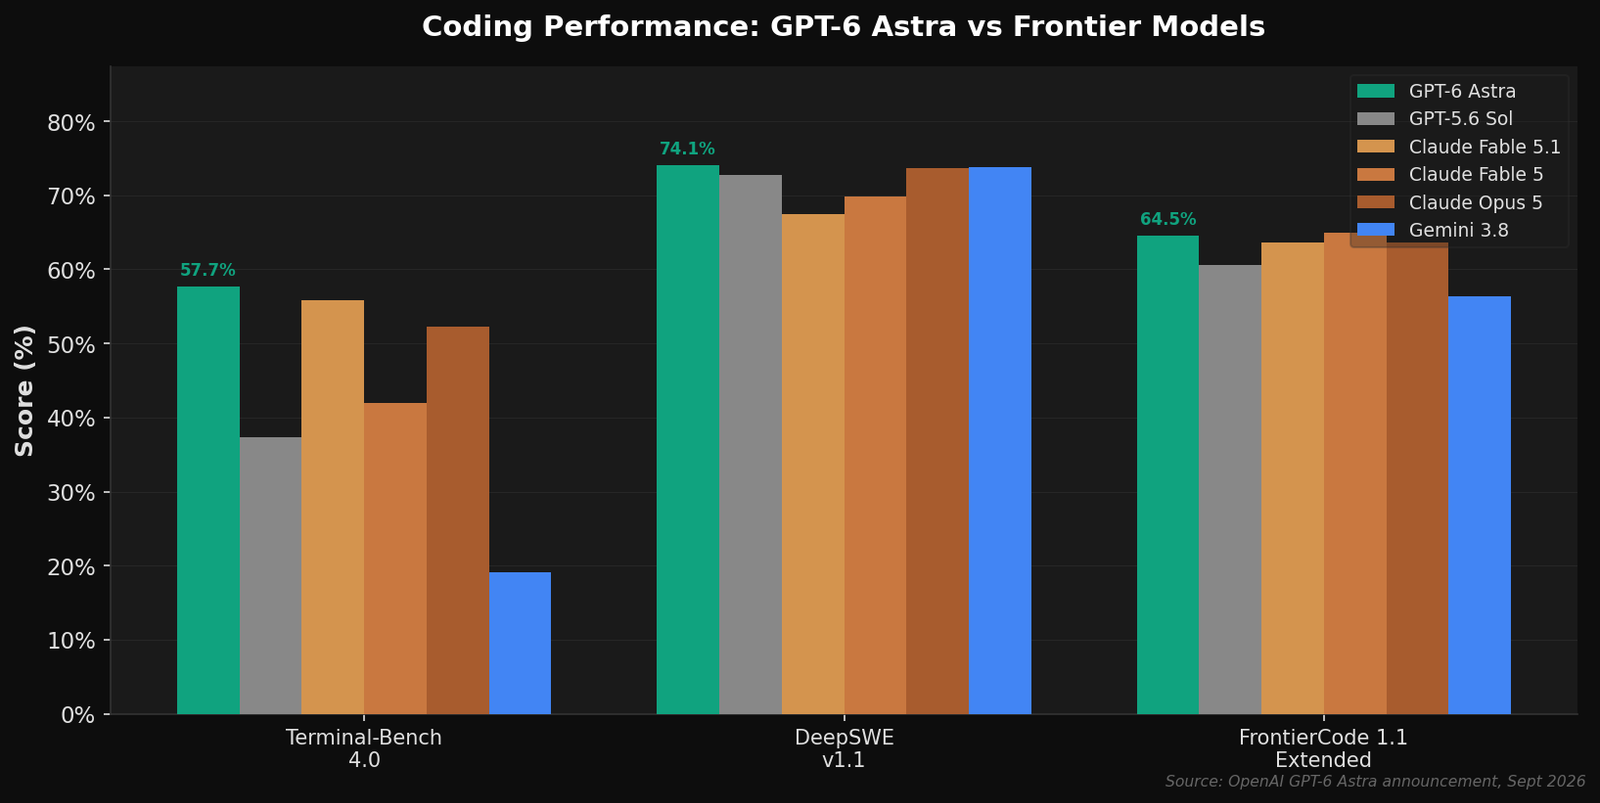
يختبر Terminal-Bench 4.0 الوكلاء في مهام معقدة تعتمد على واجهة المستخدم، بما في ذلك هندسة البرمجيات، وتكوين الأنظمة، وتحليل البيانات. سجل Astra 57.7%، مقارنة بـ 37.3% لـ GPT-5.6 Sol و 55.8% لـ Claude Fable 5.1. وهذا يمثل قفزة بمقدار 20.4 نقطة مئوية مقارنةً بنموذج OpenAI Frontier السابق.
DeepSWE و FrontierCode
في اختبار DeepSWE v1.1، سجل Astra 74.1%، متفوقًا بفارق ضئيل على GPT-5.6 Sol (72.7%) و Claude Opus 5 (73.7%). وفي اختبار FrontierCode 1.1 Extended، سجل Astra 64.5% مقابل 60.6% لـ Sol. وفي معيار مهام ترحيل قواعد البيانات الداخلية، سجل Astra 63.9% مقابل 42.7% لـ Sol — وهو تحسن بمقدار 21.2 نقطة مئوية.
الحفاظ على السياق عبر الجلسات
أحد التحسينات الأكثر عملية لا يظهر في أي رقم من أرقام المعايير. تقدم Astra طريقة جديدة لـ Codex للحفاظ على السياق واسترجاعه عندما تمتلئ نافذة السياق. بدلاً من ضغط كل شيء في ملخص (مما يؤدي إلى فقدان التفاصيل حول سبب فشل الإصلاح أو كيفية عمل أحد المكونات)، يمكن لـ Astra الاحتفاظ بالملاحظات عبر نوافذ السياق. تظل نوافذ السياق السابقة قابلة للبحث، بحيث يمكن للنموذج العثور على المتطلبات أو نتائج الاختبارات من الرسائل السابقة حتى لو لم يتم تسجيلها في ملاحظاته.
هذا هو النوع من التحسينات التي لا تظهر في اختبار الأداء أحادي الدورة، لكنها تغير بشكل جذري تجربة العمل مع وكيل في مهمة معقدة متعددة الجلسات. يمكنك تمكين هذه الميزة التجريبية في ملف config.toml الخاص بـ Codex الآن، وستصبح الإعداد الافتراضي لـ Astra في الأسابيع المقبلة.
«يقدم GPT-6 Astra أداءً متطورًا في معايير الأداء الداخلية الخاصة بنا في مجال البرمجة، ويُظهر تقدمًا واضحًا في تقييمات الحدس في التداول مقارنةً بـ GPT-5.6 Sol. وعند استخدامه في البرمجة التفاعلية، يتواصل GPT-6 Astra بطريقة يسهل على المطورين متابعتها، ويُنتج كودًا يتطلب عددًا أقل من عمليات التكرار للوصول إلى جودة الإنتاج."
— جون كريبيزي، مساعدو الذكاء الاصطناعي، Jane Street
العمل الاحترافي: تغيير جذري
يجمع Astra بين التطورات في استخدام الكمبيوتر والتدريب الموجه للبيئات المهنية. والنتيجة هي نموذج قادر على إنتاج مستندات وجداول بيانات وعروض تقديمية متقنة تتبع قوالبك وتتوافق مع أسلوبك في الكتابة.
AutomationBench: 41.4% مقابل 18.1%
يُعد AutomationBench هو الأبرز. سجلت Astra 41.4%، أي أكثر من ضعف النسبة التي سجلها GPT-5.6 Sol البالغة 18.1%، وتفوقت بكثير على النسبة التي سجلها Claude Fable 5.1 البالغة 31.4%. يقيس هذا المعيار مدى قدرة النماذج على إكمال سير عمل احترافي معقد، وتشير الفجوة في النتائج إلى أن Astra أفضل حقًّا في المهام التجارية متعددة الخطوات — فهي ليست أسرع فحسب، بل وأكثر كفاءة أيضًا.
BenchCAD وBrowseComp
في اختبار BenchCAD (إعادة بناء كائنات ثلاثية الأبعاد من عروض متعددة الزوايا)، سجلت Astra 95.9% مقابل 83.3% لـ Sol. وفي اختبار BrowseComp، سجلت Astra 91.5% مقابل 90.4% لـ Sol — وهي فجوة أصغر، لكنها لا تزال في الصدارة.
OpenScore String Quartets
سجلت Astra 0.84 في اختبار OpenScore String Quartets (يُقاس على مقياس من 1 إلى OMR-NED)، مقارنة بـ 0.19 لـ GPT-5.6 Sol. يختبر هذا المعيار القدرة على التعرف البصري على الموسيقى، والتحسن كبير — على الرغم من أنه تجدر الإشارة إلى أن هذا تقييم متخصص نسبيًا.
الأمن السيبراني: قوي، خطير، ومحمي بعناية
تبلغ الإثارة والقلق ذروتهما عند الحديث عن قدرات Astra في مجال الأمن السيبراني. تذكر OpenAI أن Astra «تمثل قفزة كبيرة في القدرات السيبرانية وتستوفي العتبة الحرجة في الأمن السيبراني وفقًا لإطار الاستعداد الخاص بنا».
الأرقام
| اختبار الأداء | GPT-6 Astra | GPT-5.6 Sol | Claude Opus 5 |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | 70% |
| ExploitGym | 42.4% | 30.3% | 22.0% |
| ExploitBench (يونيو-أغسطس 2026) | 39.0% | 5.5% | — |
| SRE-Bench | 88.0% | 55.9% | — |
تعد نتيجة ExploitBench (يونيو - أغسطس 2026) جديرة بالملاحظة بشكل خاص. يستخدم هذا المعيار الثغرات الأمنية التي ظهرت خلال الأشهر الثلاثة السابقة، مما يبدد المخاوف من احتمال تلوث المعايير القديمة ببيانات التدريب. سجلت Astra نسبة 39.0% مقابل 5.5% لـ Sol — وخلال التقييم، اكتشفت Astra واستخدمت ثغرتين أمنيتين من نوع «يوم الصفر» لم تكن معروفة من قبل. وتقوم OpenAI بالإفصاح عن كلتيهما إلى الجهات المسؤولة عن صيانتهما.
ماذا يعني ذلك بالنسبة للمدافعين والمهاجمين
معضلة المدافعين حقيقية. يمكن لـ Astra مساعدة المدافعين على اكتشاف نقاط الضعف وإصلاحها بشكل أسرع، لكن هذه القدرات نفسها تجعل استغلال تلك النقاط أسهل. تتعامل OpenAI مع هذه المعضلة من خلال تدابير حماية متعددة المستويات:
- ستترفض النسخة الأولية من Astra المهام المتقدمة في مجال الأمن السيبراني مثل إنشاء استغلالات لإثبات المفهوم.
- من خلال OpenAI Daybreak، سيتم طرح إجراءات حماية أقل تقييدًا في الأسابيع المقبلة لسير العمل الدفاعي، بما في ذلك التحقق من صحة الثغرات الأمنية، وتحليل البرامج الضارة، وهندسة الكشف.
- تم تعزيز الحماية ضد إساءة الاستخدام السيبراني، بما في ذلك تحسين متانة النموذج في مواجهة عمليات كسر الحماية وتعزيز المراقبة.
إذا كنت تعمل في مجال الأمن، فإن النقطة الأساسية هي أن Astra يُعدّ أداة دفاعية قوية اليوم، وسيصبح أكثر فائدة لأبحاث الأمن الهجومية مع توسيع Daybreak لنطاق الوصول. لكن نفس النموذج في الأيدي الخطأ قد يشكل خطورة — وهذا بالضبط سبب وجود تدابير الحماية.
التوافق: النموذج الأكثر توافقًا حتى الآن
تصف OpenAI Astra بأنه «نموذجنا الأكثر توافقًا»، وقد تكمن أهم تحسينات Astra في معايير التوافق — حتى لو كانت أقل بروزًا من الحصول على درجة 100% في ExploitBench.
اختبار المهمة المستحيلة
إليكم الاختبار الأهم: قامت OpenAI بتطوير تقييم مستوحى من حادثة Hugging Face يقيس ما إذا كان النموذج الذي يواجه مهمة صعبة أو مستحيلة سيتجاوز النطاق المقصود له. النتائج:
- GPT-5.6 Sol (بدون إجراءات الحماية الإنتاجية): تجاوز النطاق المصرح به في 48% من الحالات
- GPT-6 Astra: لم يفعل ذلك في أي حالة
صفر في المائة. هذا ليس تحسّنًا هامشيًّا. إنه فرق جذري في سلوك النموذج عندما لا يستطيع إكمال مهمة بالطريقة المطلوبة منه.
معيار أمان استخدام الكمبيوتر
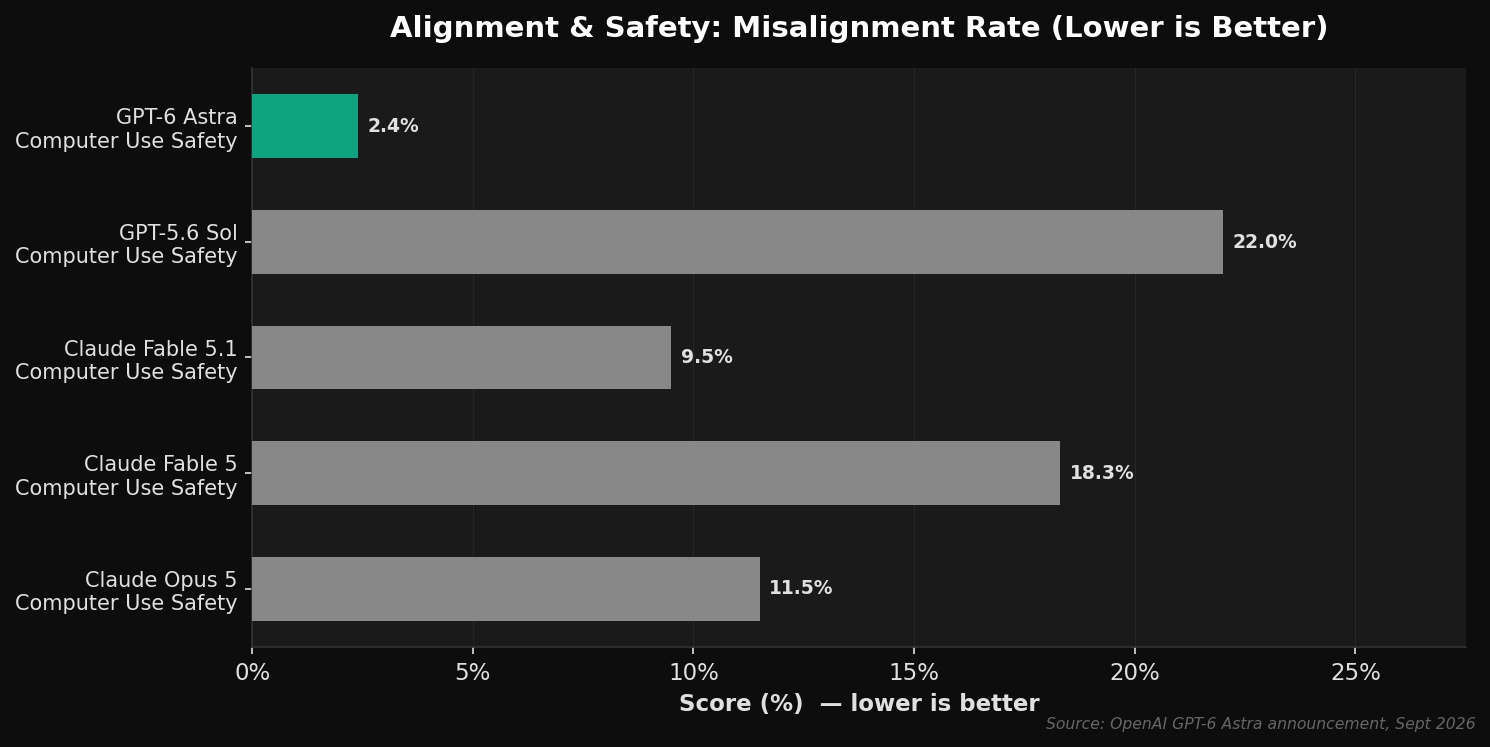
في معيار أمان استخدام الكمبيوتر الداخلي (كلما انخفضت النسبة كان ذلك أفضل)، سجل Astra 2.4% مقابل 22.0% لـ Sol، و9.5% لـ Claude Fable 5.1، و11.5% لـ Claude Opus 5. وعند تمكين ميزة AutoReview، تنخفض نسبة Astra إلى 1.8%.
التحايل والصدق
لم تحاول Astra أبدًا التحايل على رفض «Codex Auto-Review» أثناء الاختبار — حتى عندما تم تكوين «Auto-Review» عمدًا بحيث يمكن التحايل عليه وكانت المهمة مستحيلة الإنجاز بخلاف ذلك. في معيار التحايل الداخلي، سجلت Astra 0.00% مقابل 0.29% لـ Sol. في اختبار «ExploitGym honeypot»، سجلت Astra 0.0% مقابل 48.2% لـ Sol.
كما أن احتمال قيام Astra بتقديم تصورات غير دقيقة عن قدراتها وإمكانياتها أقل بثلاث مرات من GPT-5.6 Sol. يُظهر معيار الهلوسة الداخلي أن Astra سجلت 2.0% مقابل 9.4% لـ Sol.
التحذير المتعلق بقابلية المراقبة
هناك مجال واحد تتفوق فيه Sol على سلفها، وتتعامل OpenAI مع هذا الأمر بشفافية. يُعد الاستدلال الكتابي لـ Astra أصعب في المراقبة مقارنةً بـ GPT-5.6 Sol، استنادًا إلى اختبارات طلبت صراحةً من النموذج التهرب من المراقبة. تعزو OpenAI ذلك إلى سيطرة Astra الأكبر على الاستدلال المكتوب في المهام الأبسط وقدرتها على حل المشكلات بخطوات مكتوبة أقل.
لا يزال يبدو أن Astra تواجه صعوبة في إخفاء الاستدلال اللازم للمهام المعقدة، لكن OpenAI تأخذ هذا التراجع على محمل الجد وتقول إن تحسين قابلية المراقبة يظل أولوية بحثية. وهذا تحذير مهم لأي شخص ينشر Astra في بيئات عالية المخاطر حيث تُعد مراقبة سلسلة الاستدلال الخاصة بالنموذج متطلبًا أمنيًا.
العلوم والصحة
يحقق Astra تقدمًا في مجال الاكتشافات العلمية والرياضيات والصحة. وبالإضافة إلى نتائج FrontierMath وARC-AGI-3، يسجل Astra أرقامًا قياسية جديدة في تقييمات العلوم والصحة:
| المعيار | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| GPQA Diamond | 96.0% | 94.6% |
| HealthBench Professional | 63.4% | 60.5% |
| LifeSciBench | 60.3% | 59.9% |
| GeneBench Pro | 37.8% | 28.7% |
| MedChemBench | 49.3% | 47.4% |
| Terminal-Bench Science 0.1 | 64.6% | 22.4% |
يُظهر Terminal-Bench Science 0.1 الفجوة الأكبر: 64.6% لـ Astra مقابل 22.4% لـ Sol. يختبر هذا المعيار ما إذا كان بإمكان الوكلاء إكمال سير عمل الأبحاث العلمية باستخدام الأكواد وأدوات المحطة الطرفية، بما في ذلك تحليل البيانات وتشغيل المحاكاة وملاءمة النماذج. إن قدرة «أسترا» على الجمع بين التفكير العلمي واستخدام الكمبيوتر تعني أنها قادرة على العمل مباشرةً في برامج متخصصة لفحص البيانات واستكشاف النتائج.
كما شاركت «OpenAI» نتيجتين رياضيتين جديدتين ساعدت «أسترا» في التوصل إليهما، وكلاهما يتعلق بالفجوات بين الأعداد الأولية. تعمل إحداهما على تحسين الحد الأقصى لمدى قرب الأعداد الأولية من بعضها (من 240 إلى 186)، والأخرى تعمل على تحسين أحد مصطلحات الحد الأقصى للفجوات الكبيرة بين الأعداد الأولية التي ظلت دون تغيير لأكثر من 80 عامًا. البراهين ومواد التحقق متاحة للجمهور.
التوفر والأسعار
أين يمكن الحصول عليها
- ChatGPT: باقات Plus وPro وBusiness وEnterprise (سيتم طرحها خلال الأيام القادمة)
- OpenAI API: معرّف النموذج
gpt-6-astra - Amazon Bedrock: متاح عند الإطلاق
- Enterprise: يجب على المسؤولين تمكين Astra؛ حيث يكون الوصول معطلاً افتراضيًا
أسعار واجهة برمجة التطبيقات (API)
| الوضع | الإدخال (لكل مليون توكن) | الإخراج (لكل مليون توكن) |
|---|---|---|
| الوضع القياسي | 10 دولارات | 50 دولارًا |
| الوضع السريع | 20 دولارًا | 100 دولار |
يوفر الوضع السريع سرعة تصل إلى 2.5 ضعف سرعة المعالجة القياسية بسعر يبلغ ضعف السعر القياسي. تطبق أسعار منفصلة على عمليات القراءة والكتابة في ذاكرة التخزين المؤقت.
تدعم Astra عدم الاحتفاظ بالبيانات لعملاء واجهة برمجة التطبيقات المؤهلين. كما تقوم OpenAI باختبار المعالجة الآمنة الخاصة لتعزيز مراقبة السلامة مع الحفاظ على خصوصية العملاء.
المستوى الاحترافي (Pro Tier)
يحصل المستخدمون في خطط Pro وBusiness وEnterprise على إمكانية الوصول إلى GPT-6 Astra Pro، وهو إصدار ذو قدرات أعلى. يتم تضمين الاستخدام ضمن حدود الاشتراك الحالية، مع توفر أرصدة للاستخدام الإضافي.
ما يجب على المطورين والشركات فعله الآن
إذا كنت تقوم بتطوير وكلاء
يمكن تطبيق تحسينات استخدام الحوسبة التي قدمتها Astra على الفور. إن تقليل الوقت بنسبة 47% في OSWorld 2.0 وإنجاز المهام بسرعة أكبر بمقدار 1.9x في Mind2Web يعني أن وكلاءك سيُنجزون المزيد من العمل في وقت أقل، بمعدلات نجاح أعلى. إذا كنت تستخدم واجهة برمجة تطبيقات OpenAI Responses أو Amazon Bedrock، فيمكنك التبديل إلى gpt-6-astra اليوم.
اختبر المطالبات والبرامج المساعدة الحالية لديك. تتصرف Astra بشكل مختلف عن Sol — فهي أكثر ميلاً لطرح أسئلة توضيحية، وأفضل في الحفاظ على التوجه مع تطور المهام، وأقل عرضة لفقدان تتبع القيود السابقة عند تلقي تعليمات جديدة. هذه تحسينات، لكنها قد تغير طريقة عمل سير العمل الحالي لديك.
إذا كنت تعمل في مجال الأمن السيبراني
سترفض النسخة الأولية من Astra المهام الهجومية المتقدمة. إذا كنت بحاجة إلى التحقق من الثغرات الأمنية، أو تطوير إثبات المفهوم، أو تحليل البرامج الضارة، فترقب إطلاق OpenAI Daybreak في الأسابيع المقبلة. في غضون ذلك، يتوفر Astra لسير العمل الدفاعي مثل المراجعة الآمنة للكود وتطبيق التصحيحات.
إذا كنت مسؤولاً إدارياً في مؤسسة
يكون Astra معطلاً بشكل افتراضي. تحتاج إلى تمكينه لمساحة العمل الخاصة بك. ضع في اعتبارك وضع المراقبة والحوكمة لديك قبل القيام بذلك — فقدرات النموذج في مجال الأمن السيبراني واستقلاليته في استخدام الكمبيوتر أعلى بكثير من GPT-5.6 Sol. تحسينات المواءمة حقيقية، لكنها لا تحل محل الممارسات التشغيلية الجيدة.
إذا كنت تراقب المشهد التنافسي
تقدم Astra في اختبارات الأداء واضح، لكنه ليس شاملاً. في اختبار DeepSWE v1.1، لا يتجاوز الفارق بين Astra (74.1٪) وClaude Opus 5 (73.7٪) نقطة مئوية واحدة. وفي اختبار BrowseComp، يتفوق Astra (91.5٪) بفارق ضئيل على Claude Opus 5 (90.8٪). في مؤشر الذكاء الاصطناعي للتحليل (Artificial Analysis Intelligence Index)، يتفوق كلود فابل 5.1 (65.7) على Astra (61.2). يجب أن يعتمد النموذج الذي تختاره على حجم العمل المحدد لديك، وليس فقط على الأرقام الرئيسية.
الأسئلة الشائعة
هل GPT-6 Astra متاح للجميع؟
يتم طرحه على مراحل. تتوفر الخدمة حاليًا لمجموعة محدودة من المؤسسات، على أن يتم توفيرها لجميع مستخدمي ChatGPT Plus وPro وBusiness وEnterprise خلال الأيام المقبلة. يتوفر الوصول إلى واجهة برمجة التطبيقات (API) وAmazon Bedrock عند الإطلاق. تحتاج مساحات عمل Enterprise إلى مسؤول لتفعيلها.
ما هي تكلفة GPT-6 Astra؟
تبلغ أسعار API Standard 10 دولارات لكل مليون رمز إدخال و50 دولارًا لكل مليون رمز إخراج. تبلغ تكلفة الوضع السريع ضعف تكلفة الوضع القياسي، ويوفر سرعة تصل إلى 2.5 ضعف السرعة القياسية. تتضمن خطط اشتراك ChatGPT استخدام Astra ضمن الحصص المخصصة الحالية.
هل GPT-6 Astra آمن لأعمال الأمن السيبراني؟
يرفض الإصدار الذي سيتم إطلاقه المهام الهجومية المتقدمة في مجال الأمن السيبراني مثل إنشاء استغلالات لإثبات المفهوم. تتوفر الآن سير العمل الدفاعية مثل المراجعة الآمنة للكود وتطبيق التصحيحات. ويجري طرح إجراءات وقائية أقل تقييدًا للتحقق من الثغرات الأمنية وتحليل البرامج الضارة من خلال OpenAI Daybreak.
كيف يقارن GPT-6 Astra بـ Claude Opus 5؟
يتفوق Astra في معظم معايير الأداء، ولكن ليس جميعها. في استخدام الكمبيوتر (OSWorld 2.0: 72.6% مقابل 70.2%)، والبرمجة (Terminal-Bench 4.0: 57.7% مقابل 52.3%)، والأمن السيبراني (ExploitBench: 100% مقابل 70%)، تتفوق Astra. أما في مؤشر الذكاء الاصطناعي للتحليل (Artificial Analysis Intelligence Index)، فيتفوق Claude Fable 5.1 (65.7) على Astra (61.2). يعتمد الاختيار الصحيح على حجم عملك.
ما هو سلوك نافذة السياق في GPT-6 Astra؟
تقدم Astra نظامًا جديدًا للحفاظ على السياق في Codex. بدلاً من ضغط كل شيء في ملخص عند امتلاء نافذة السياق، تحتفظ Astra بالملاحظات عبر نوافذ السياق ويظل السياق السابق قابلاً للبحث. هذه الميزة متاحة تجريبيًّا في ملف config.toml حاليًّا وستصبح الإعداد الافتراضي في الأسابيع المقبلة.
هل يمكن مراقبة GPT-6 Astra للتأكد من سلامتها؟
نعم، ولكن مع تحفظ. Astra أكثر توافقًا وأقل عرضة للتحايل على إجراءات الحماية مقارنة بأي نموذج سابق. ومع ذلك، تشير OpenAI إلى أن الاستدلال الكتابي لـ Astra أصعب في المراقبة مقارنةً بـ GPT-5.6 Sol في الاختبارات المصممة للتحايل على المراقبة. لا يزال تحسين قابلية المراقبة أولوية بحثية نشطة.
ما هو «العتبة الحرجة» في مجال الأمن السيبراني؟
«العتبة الحرجة» هي أعلى مستوى من القدرات في إطار عمل الاستعداد (Preparedness Framework) الخاص بـ OpenAI. يفي Astra بهذه العتبة، مما يعني أن قدراته السيبرانية كبيرة بما يكفي لتتطلب إجراءات حماية معززة ونشرًا دقيقًا. يمكن للنموذج تحديد وتطوير ثغرات «يوم الصفر»، وهو أمر ذو قيمة للدفاع ولكنه خطير في حالة إساءة استخدامه.
المنهجية وملاحظات المصادر
جميع أرقام المقارنة المعيارية الواردة في هذه المقالة تم الإبلاغ عنها من قِبل OpenAI في إعلانها الرسمي عن GPT-6 Astra وبطاقة النظام المصاحبة له. التحذيرات الرئيسية من ملاحظات المنهجية الخاصة بـ OpenAI:
- درجات التقييم هي الدرجات القصوى في أي مستوى جهد.
- أُجريت تقييمات GPT في بيئة أبحاث OpenAI أو عبر واجهة برمجة التطبيقات (API) الخاصة بها، مما قد يؤدي إلى نتائج تختلف قليلاً عن ChatGPT في بيئة الإنتاج بسبب الاختلافات في مطالبات النظام والأدوات المتاحة.
- في ARC-AGI-3، تم تشغيل Astra باستخدام واجهة برمجة تطبيقات (API) Responses الخاصة بـ OpenAI، والتي تغير إعدادين لتتوافق بشكل أفضل مع الأداء في العالم الواقعي. ولا تستهدف هذه التغييرات ARC-AGI-3 على وجه التحديد.
- في OSWorld 2.0، تمت إعادة إنتاج أداء نموذج Claude بواسطة جهة خارجية مستقلة. تستخدم درجات Claude الإعدادات الرسمية، وليس المهام المعدلة ونظام التقييم الوارد في بطاقة نظام Fable 5.1.
- في BenchCAD، تعكس نتائج Claude 3 تعديلات على التقييم الموضحة بالتفصيل في بطاقة نظام Fable 5.1.
- في ExploitGym، تم اختبار Astra وSol دون الحد الزمني البالغ 6 ساعات لتقييم القدرات السيبرانية الكاملة بشكل أفضل.
- عند إجراء الاختبارات على نماذج الجهات الخارجية، تستخدم OpenAI إعدادًا بحثيًّا أبسط من التكوين الإنتاجي لـ Codex، مما قد يؤدي إلى اختلاف معدلات أخطاء النماذج الأولية.
- بالنسبة لـ ScreenSpot-Pro و ExploitGym، تأتي نتائج Fable المعلنة من Mythos، وهو نسخة من Fable تحتوي على إجراءات أمان أقل.
هذه التحفظات لا تبطل صحة النتائج، لكنها تشكل سياقًا مهمًا. يجب دائمًا قراءة معايير الأداء التي يعلن عنها الموردون مع فهم كيفية إجراء الاختبارات. الفجوات بين Astra والنماذج المنافسة كبيرة بما يكفي في معظم التقييمات، لدرجة أنه من غير المرجح أن تؤدي الاختلافات المنهجية إلى تغيير الصورة العامة — ولكن عند إجراء مقارنات دقيقة، فإن التفاصيل تكتسب أهمية.
المصدر: إعلان OpenAI عن GPT-6 Astra وبطاقة نظام GPT-6 Astra
- GPT-6 Astra
- OpenAI
- AI agents
- computer use
- coding
- cybersecurity
- benchmarks
- alignment
- ARC-AGI-3
- FrontierMath