Eine durchgängige Pipeline
Hochladen, OCR, in Blöcke unterteilen, einbetten, abrufen, mit Quellenangaben beantworten – mit Wiederholungsversuchen und Qualitätsprüfungen an den Schritten, die bei fehlerhaften Eingaben fehlschlagen, statt am Ende.
Fallstudie zu KI-SaaS
Eine Plattform, die ein PDF – einschließlich der Scans, die niemand durchsuchen kann – in etwas verwandelt, zu dem man Fragen stellen kann, sei es per Web-Chat, per SMS oder indem man die Kamera seines Smartphones auf einen QR-Code richtet, der auf dem Gegenstand aufgedruckt ist, nach dem man fragt.
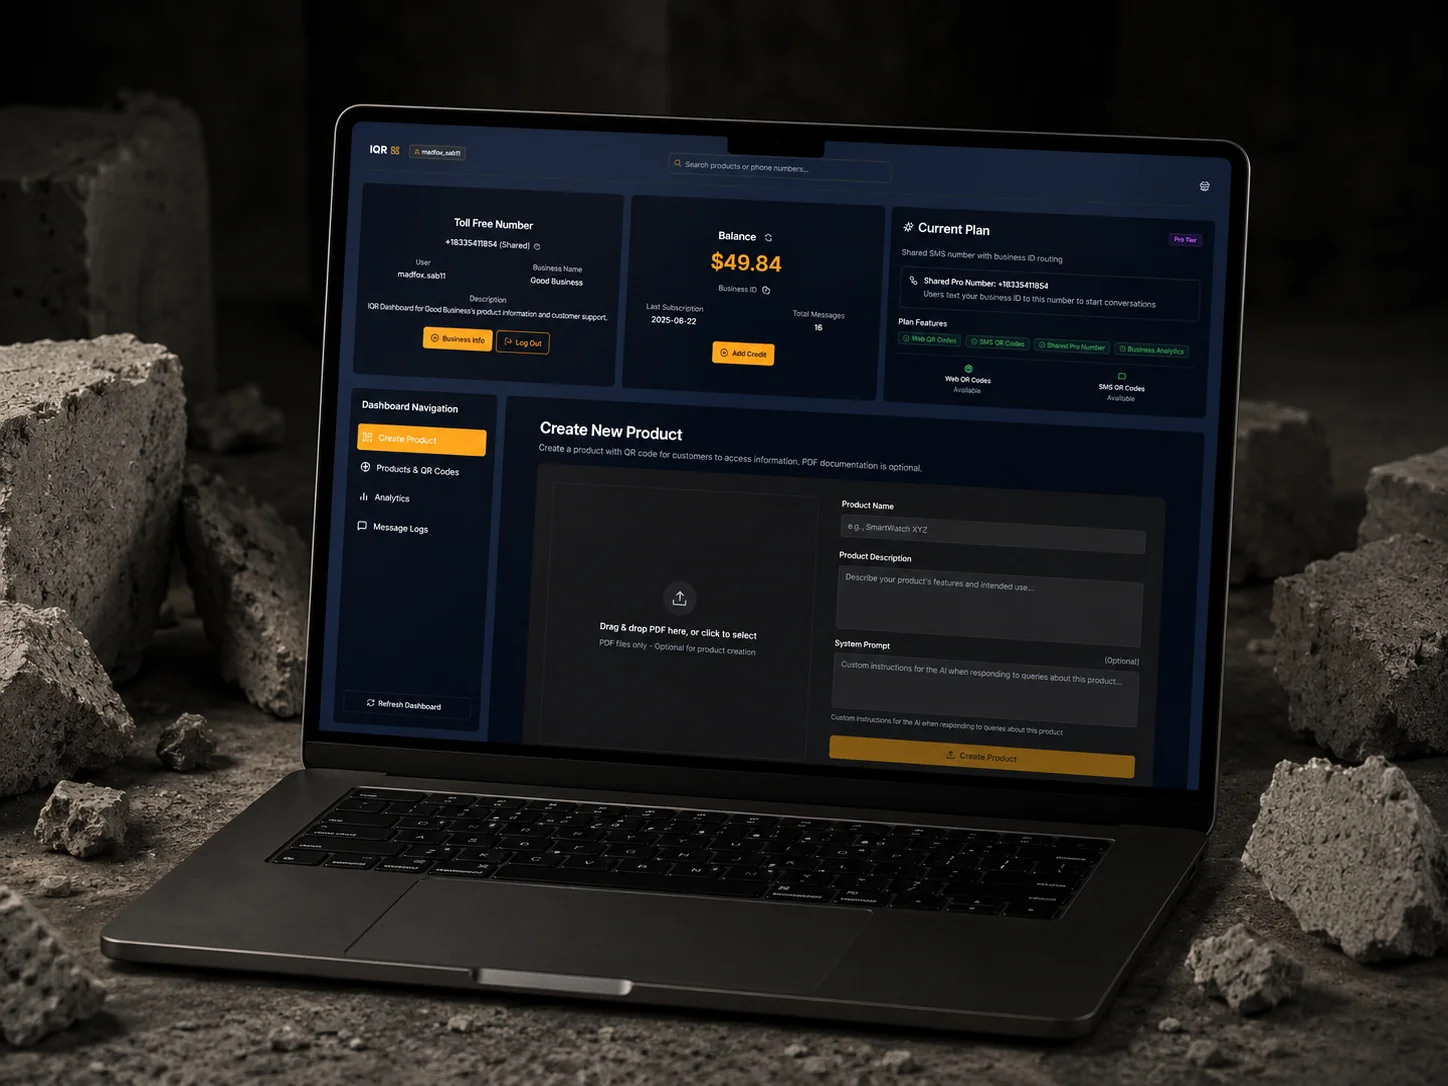
TextGPT + IQR.Codes sind zwei Produkte in einer Pipeline, die für Modezilla LLC entwickelt wurden. TextGPT ist der Bereich für Privatkunden: Man lädt ein Dokument hoch, wählt eine Persona aus und stellt ihr Fragen. IQR.Codes ist der geschäftliche Teil, bei dem ein Unternehmen seine Handbücher und Richtlinien hochlädt, einen QR-Code ausdruckt und jeder Kunde, der diesen scannt, ein Gespräch beginnt, bei dem die Antworten bereits bekannt sind.
Der zugrunde liegende Prozess ist in beiden Fällen derselbe – Hochladen, OCR, Aufteilen, Einbetten, Abrufen, Beantworten mit Quellenangaben. Was es schwierig machte, war der Zustand, in dem ein PDF tatsächlich eintrifft. Ein sauberes digitales Exportdokument ist ein gelöstes Problem; ein Foto einer Seite aus einem fünfzehn Jahre alten Handbuch hingegen nicht – und genau solche Dokumente liegen in Unternehmen tatsächlich vor.
Die übrige Architektur ergibt sich aus zwei Anforderungen, die bereits vor der ersten Zeile festgelegt wurden: Eine Antwort muss innerhalb einer Sekunde zurückkommen, und keine Organisation darf jemals die Dokumente einer anderen einsehen können. Die zweite Anforderung wird in Postgres durch Sicherheit auf Zeilenebene durchgesetzt, anstatt dass die Anwendung selbst für die Filterung sorgen muss.
Eine Schritt-für-Schritt-Anleitung zu TextGPT und IQR.Codes – vom Hochladen einer PDF-Datei in das Dashboard bis hin zum Scannen eines gedruckten Codes durch den Kunden und dem Erhalt der Antwort per SMS.
PDF-Erfassung mit OCR
Dokumente werden unverändert übernommen, einschließlich Scans. Bevor die Daten den Parser erreichen, werden sie einer OCR-Verarbeitung und einer Bereinigung unterzogen, sodass eine fotografierte Seite durchsuchbar wird und nicht übersprungen wird.
Antworten mit Quellenangaben
Ein durch Dokumentensuche erweiterter Chat, der Antworten aus den hochgeladenen Dokumenten liefert und angibt, aus welchem Dokument die Antwort stammt – und nicht einfach aus dem, was das Modell ohnehin schon glaubte.
QR- und SMS-Kanäle
Durch das Scannen eines Codes wird ein markenspezifischer Web-Chat oder eine Textnachricht-Konversation geöffnet. Es muss nichts installiert und kein Konto angelegt werden, und über SMS behält der Kunde den Chatverlauf in seinen Nachrichten.
Standardmäßig mandantenfähig
Jede Zeile und jede Datei ist in Postgres selbst auf eine Organisation beschränkt, und zwar durch Sicherheit auf Zeilenebene und signierte URLs und nicht durch einen Filter auf Anwendungsebene.
Abonnements und Abrechnung
Die Stripe-Tarife legen fest, welche Kanäle einem Konto zur Verfügung stehen und in welchem Umfang diese genutzt werden dürfen. Nach der ersten Zahlung steht ein Kundenportal für alle Funktionen zur Verfügung.
Unternehmen verfügten über Dokumente, die bereits alle Antworten enthielten, nach denen ihre Kunden suchten – Produktanleitungen, Richtlinien, Datenblätter, Rückgabebedingungen –, jedoch in einem Format, das sich nicht durchsuchen ließ. Wenn es sich bei diesen Dokumenten um Fotos von Seiten und nicht um digitale Auszüge handelte, lieferte selbst eine Suche im Klartext keine Ergebnisse. Die Notlösung war eine Support-Warteschlange: Jemand las den ganzen Tag lang dieselbe PDF-Datei erneut durch und tippte denselben Absatz immer wieder ab, während der Kunde darauf wartete.
Nicht durchsuchbare Dokumente
Das Wissen war vorhanden, in PDF-Dateien – und am schlimmsten waren dabei Bilder von Seiten, bei denen selbst eine Textsuche keine Ergebnisse lieferte.
Reibereien an der Haustür
Alles, was den Kunden dazu aufforderte, eine App zu installieren oder ein Konto anzulegen, ließ ihn abspringen, noch bevor die Frage überhaupt gestellt wurde.
Kosten und Isolierung in großem Maßstab
Das System musste auch bei Millionen von Dokumenten schnell und kostengünstig bleiben und gleichzeitig gewährleisten, dass keine Organisation die Dokumente einer anderen lesen konnte.
Jedes Dokument durchläuft denselben Prozess. Es wird hochgeladen, bei Bedarf einer OCR-Verarbeitung unterzogen, in Abschnitte aufgeteilt, eingebettet und zusammen mit seinen Vektoren in Postgres gespeichert. Eine Frage wird auf dieselbe Weise eingebettet und anhand der Rückmeldung beantwortet, wobei die Quelle angegeben wird. Auf dieser einen Pipeline basieren zwei Produkte – TextGPT für Privatpersonen mit einem Dokument und IQR.Codes für Unternehmen, deren Kunden Fragen haben – sowie zwei Zugangswege: Web-Chat und SMS, die beide über einen auf der Verpackung aufgedruckten Code erreichbar sind.
Hochladen, OCR, in Blöcke unterteilen, einbetten, abrufen, mit Quellenangaben beantworten – mit Wiederholungsversuchen und Qualitätsprüfungen an den Schritten, die bei fehlerhaften Eingaben fehlschlagen, statt am Ende.
TextGPT für den privaten Gebrauch und IQR.Codes für den geschäftlichen Einsatz, wobei die Erfassungs- und Abrufebene gemeinsam genutzt wird, anstatt dass jede Anwendung eine eigene Kopie davon besitzt.
Supabase mit Sicherheit auf Zeilenebene und pgvector, auf Vercel Serverless Functions. Durch bereichsbezogene Richtlinien und signierte URLs wird die Isolation zu einer Eigenschaft der Datenbank.
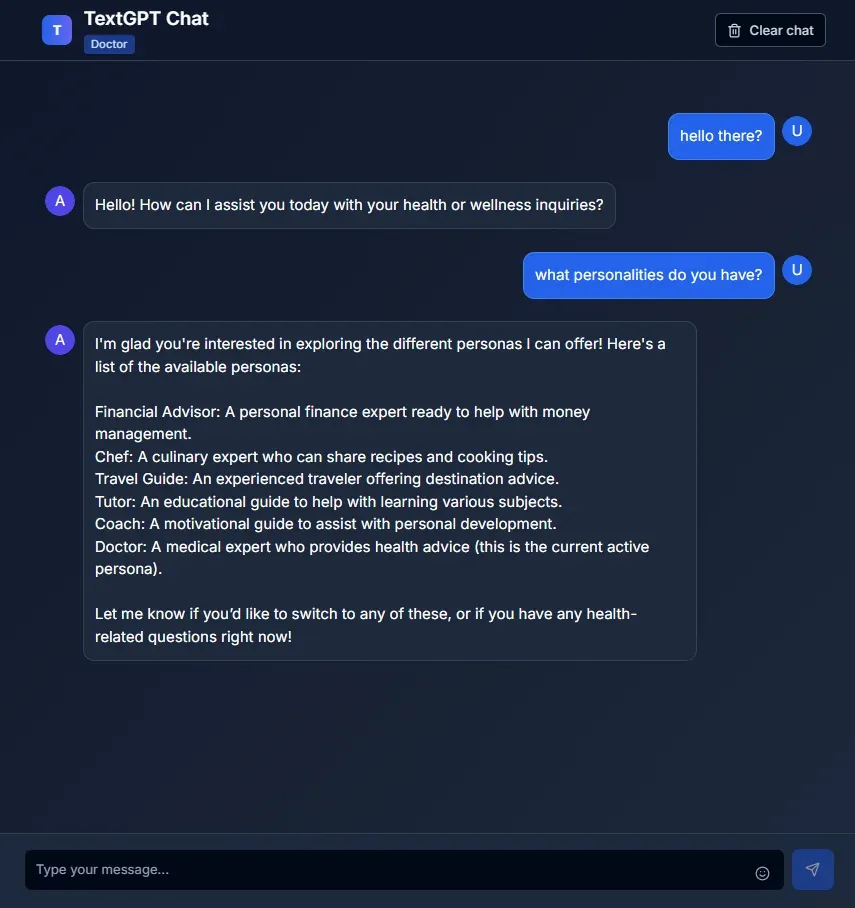
The personal side of the platform: a chat window over whatever has been uploaded, with a persona that sets how the answers come back. The badge under the title is the one currently answering, and switching it is a sentence in the conversation rather than a trip to a settings page.
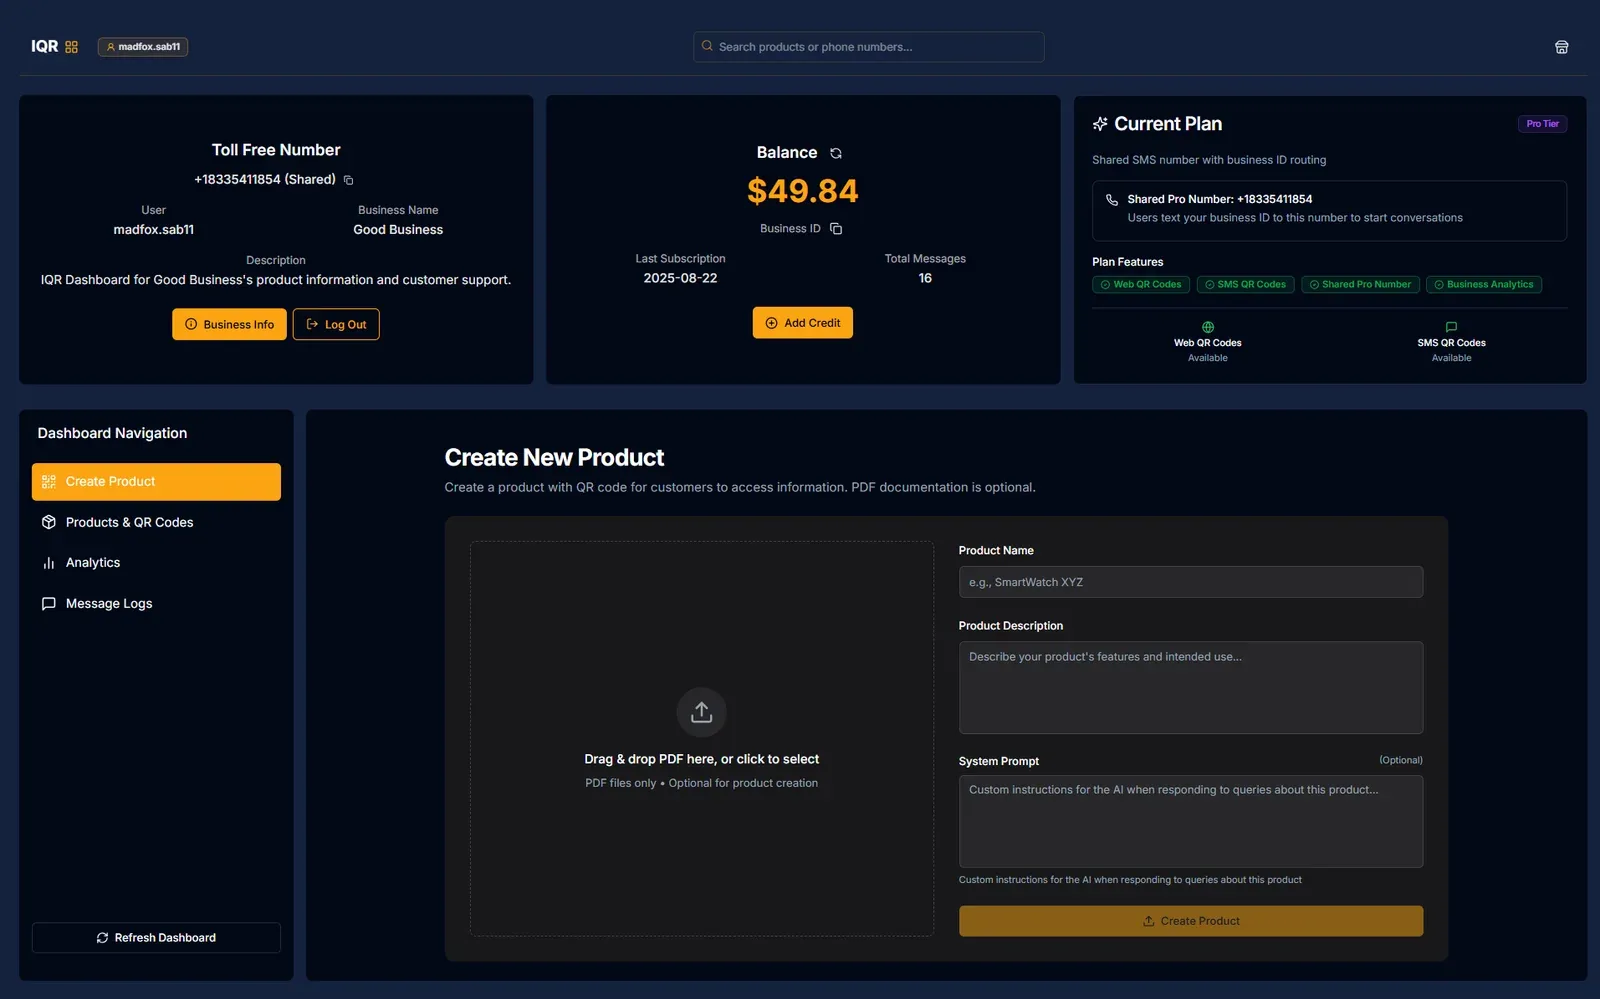
A team creates a product, drops in the PDF documentation, and optionally writes a system prompt that steers how the assistant answers about that one product. What comes out is a secure knowledge base and a QR code pointing at it — branded SMS or web chat, no support ticket in between.
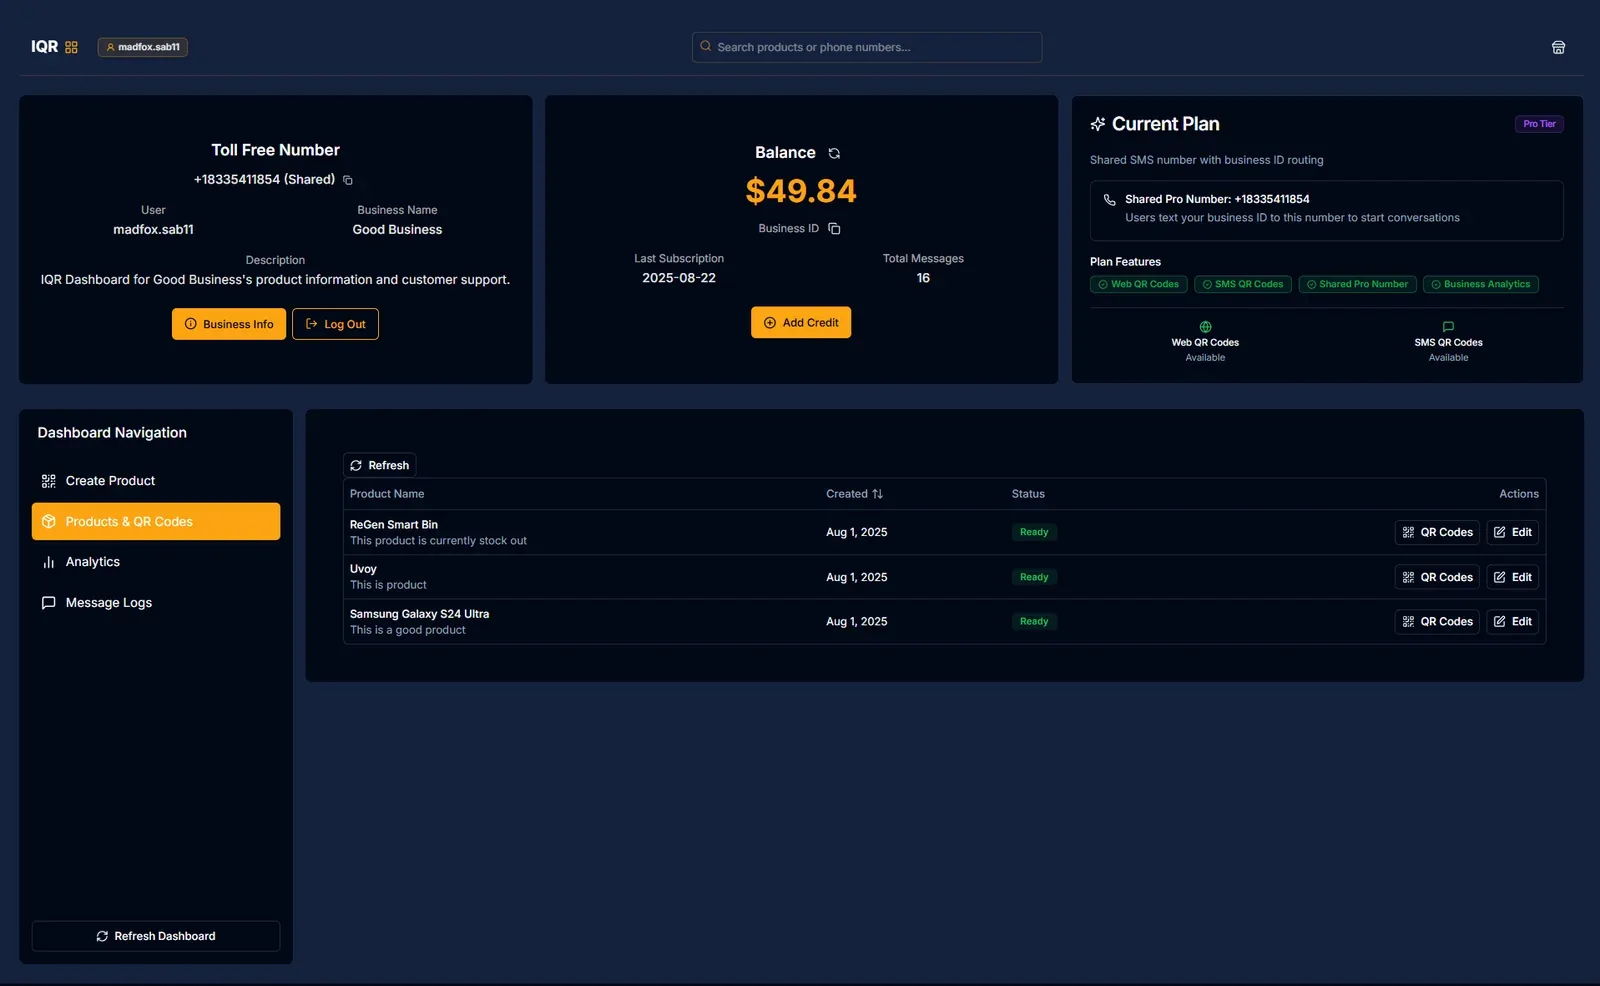
Every product has its own row, with codes to view, edit and download. That download is what actually gets printed — on packaging, on an event flyer, on a sticker beside the machine — so the customer with the question is one camera scan away from the answer.
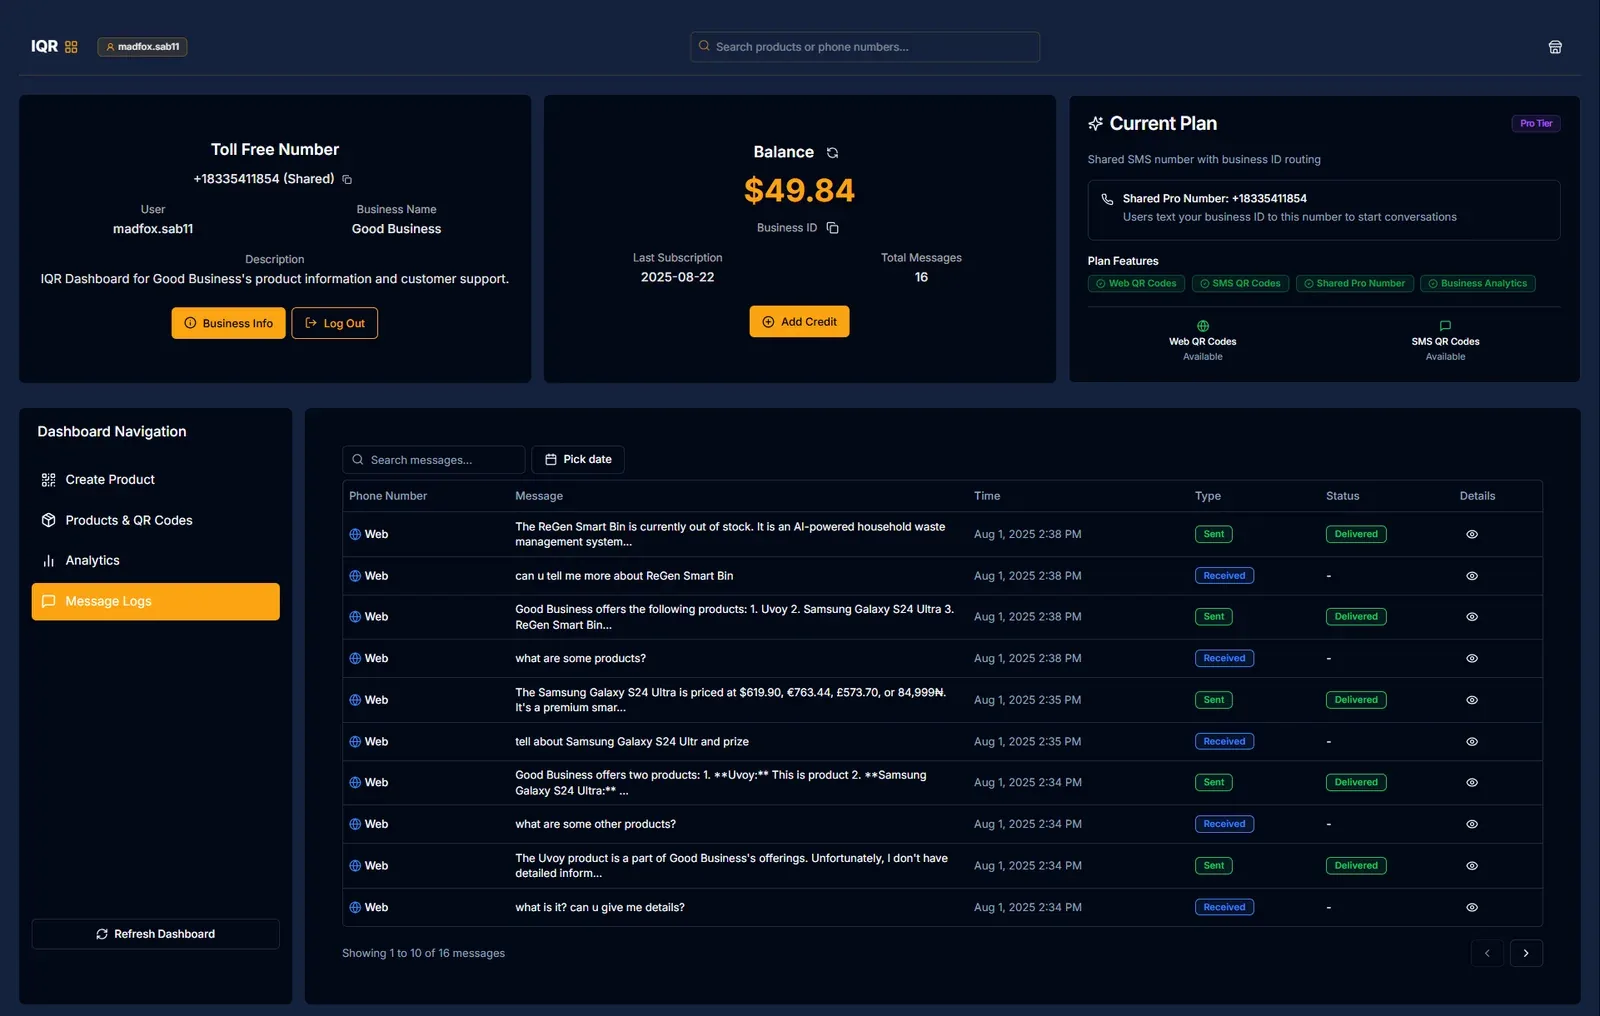
Web chat and SMS land in the same log, with the message, the time, the direction and the delivery status on a single line. It is what turns the chatbot from something a business hopes is working into something it can audit — and what shows which questions customers keep asking.
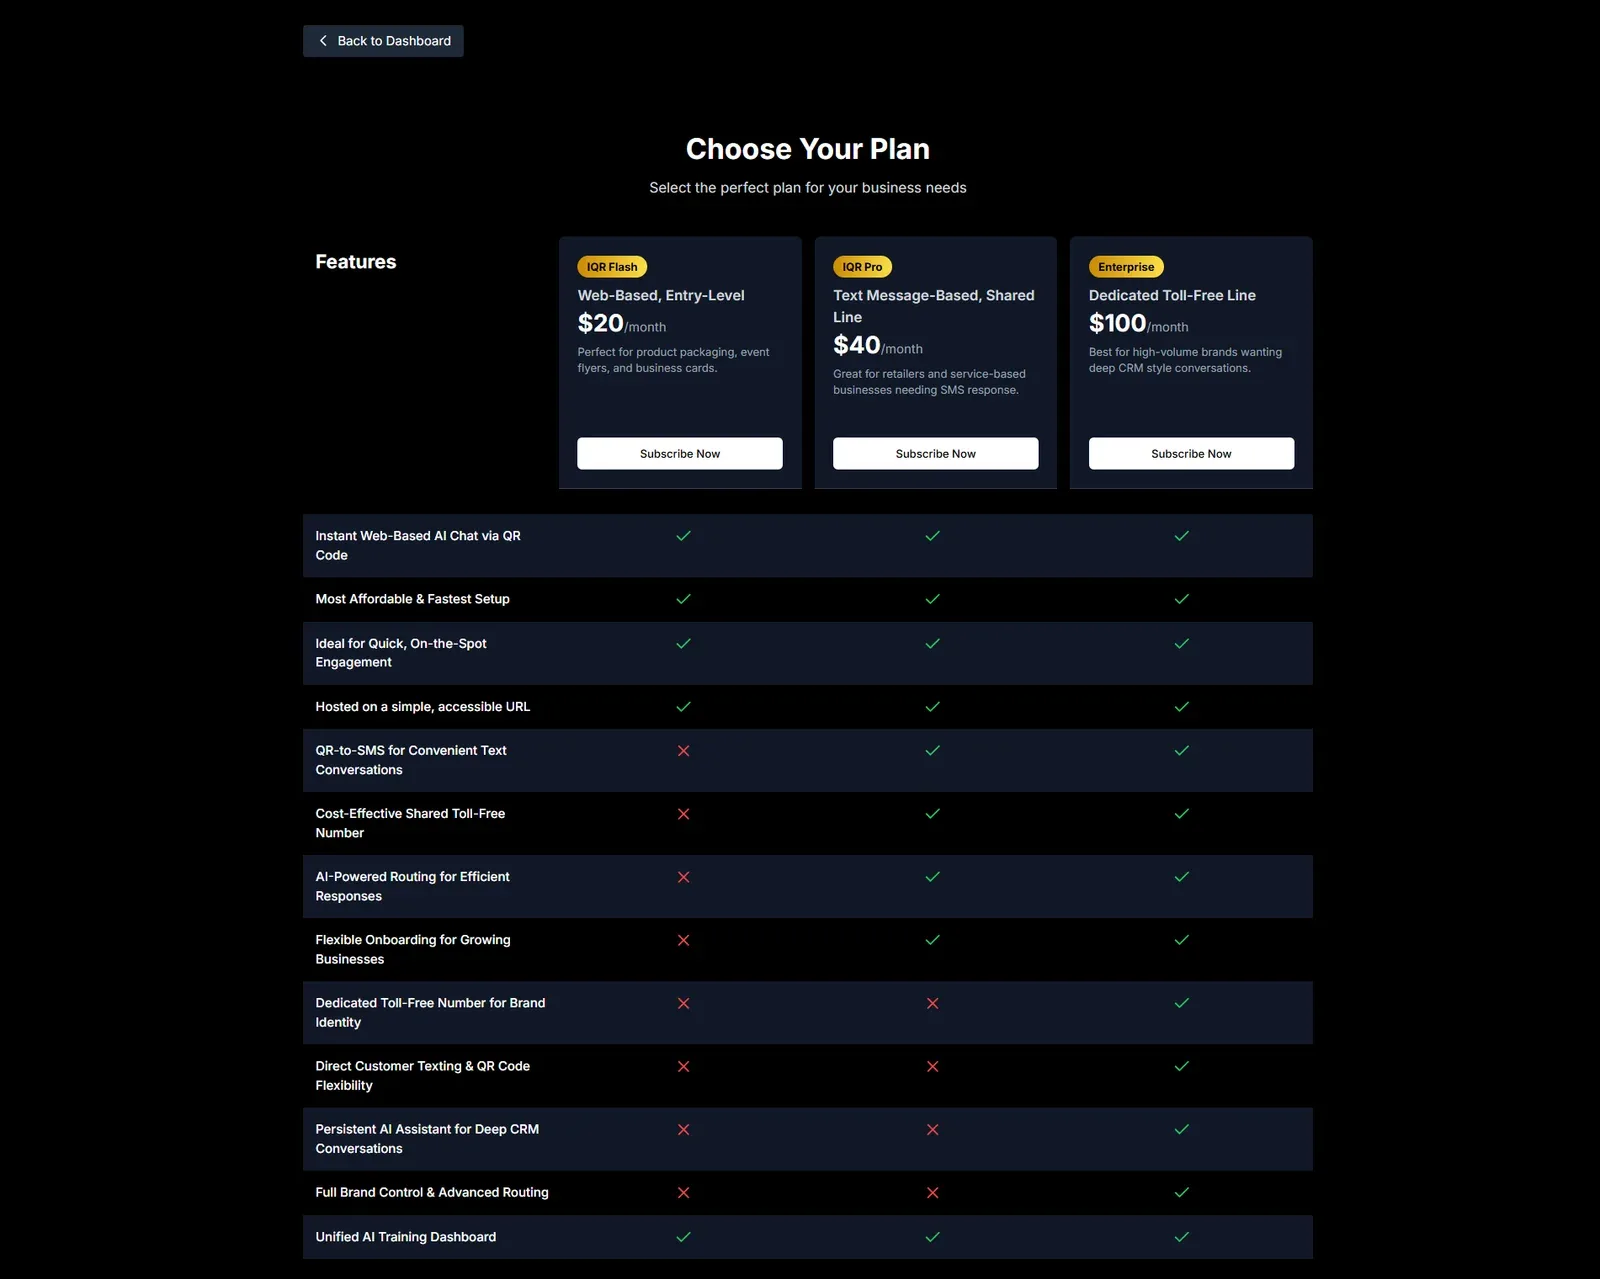
Three Stripe tiers, where the feature matrix is the product decision made visible. The entry plan is web chat reached from a printed code, the middle one adds SMS on a shared toll-free number, and the top one is a dedicated line for a brand that wants the number to be its own.
Die Plattform orientierte sich an konkreten Kennzahlen statt an Impressionen: Wie lange dauert es, bis ein Dokument durchsuchbar ist, wie lange dauert es, bis eine Antwort zurückkommt, wie viel von einem schlecht gescannten Dokument die OCR übersteht und auf wie viele Daten einer Organisation eine andere zugreifen kann.
Solution: Ein OCR-Vorverarbeitungsschritt und ein heuristischer Bereinigungsdurchlauf, bevor die Daten den LLM-Parser erreichen, ergänzt durch Wiederholungsversuche und Qualitätskontrollen. Diese Kombination hat dazu geführt, dass die Genauigkeit bei schwierigen Scans von geringer Qualität von unbrauchbar auf zuverlässig gesteigert wurde.
Solution: Optimierte pgvector-Indizes, Schreibvorgänge im Batch-Modus und Kosinus-Ähnlichkeit über gefilterte Bereiche statt über den gesamten Korpus – mit leichtgewichtigem Metadaten-Caching vor den sich wiederholenden Abfragen.
Solution: Ein durch RLS durchgesetztes Schema mit Trennung von Diensten und Rollen sowie Supabase Storage, auf das ausschließlich über signierte URLs im Rahmen von bereichsbezogenen Richtlinien zugegriffen werden kann. Organisationsdaten werden durch die Datenbank getrennt, nicht durch den Code, der sie abfragt.
Machen wir daraus Antworten.