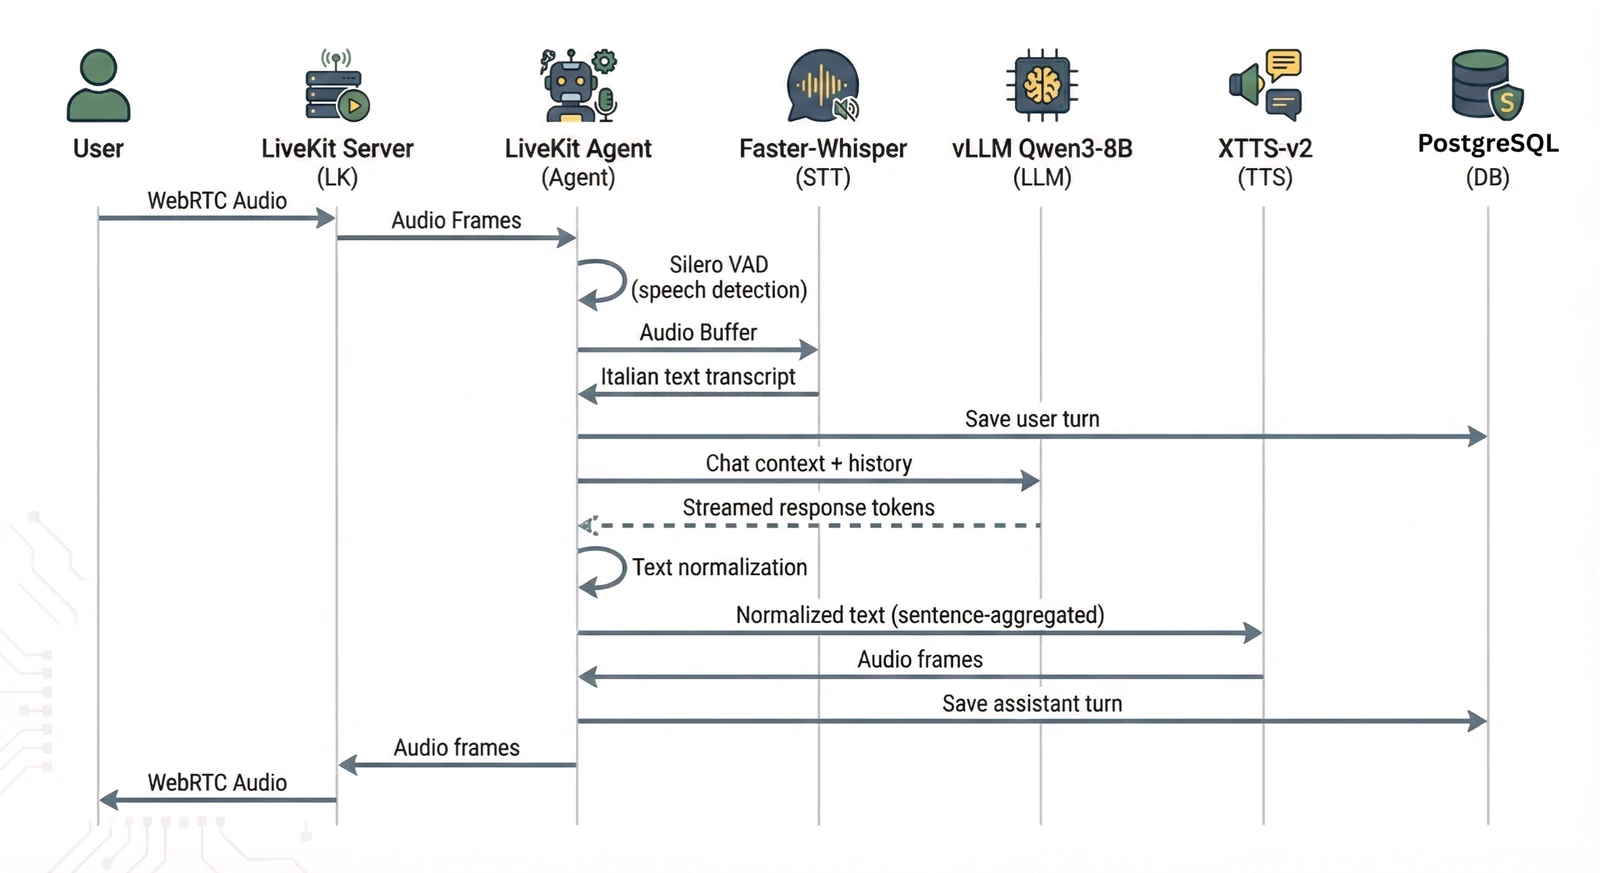
Bei Managed Voice AI erfolgt die Abrechnung minutengenau, sodass ein erfolgreicher Agent eine höhere Rechnung erhält. Bei der Entwicklung von Vocale, das entweder über eine gehostete API oder auf einer privaten GPU läuft, haben wir vier Dinge gelernt, was tatsächlich schwierig wird, wenn die Modelle intern betrieben werden.
Erfahren Sie, wie Sie eine Agentur für KI-Automatisierung auswählen, die Arbeitsabläufe überprüft, Systeme integriert, Fehler behebt und messbare Produktionsergebnisse liefert.
Ein praktischer Leitfaden zur KI-Automatisierung im Unternehmen: Identifizieren Sie wertschöpfende Arbeitsabläufe, reduzieren Sie sich wiederholende Aufgaben, integrieren Sie menschliche Kontrolle und messen Sie den ROI auf sichere Weise.
Erfahren Sie, was Dienstleistungen zur Entwicklung von KI-Agenten leisten sollten – von RAG- und Tool-Integrationen bis hin zu Bewertungen, Berechtigungen, manuellen Freigaben und Wartung.
Bangladesh's best AI teams in 2026 ship agentic systems, RAG pipelines, and local LLMs with measured metrics. Here is how to identify the right AI team for your build.
Choosing an AI expert in Dhaka in 2026 means deciding between solo engineers and full teams. Compare rates, tech stacks, and the 6 questions that reveal real depth.
Building a RAG system in Dhaka in 2026 costs $8K-$25K with retrieval under 1s. Compare pgvector vs Pinecone, Llama 3 vs GPT-4, and the 5-step production process.
Bangladesh's AI solution providers in 2026 ship agentic systems, custom SaaS, and local LLMs with measured metrics. Compare the top 8, pricing, and the 8-step buyer process.